涵盖 bm25vector、bm25query、tsvector、<&>、to_bm25query、bm25_page_inspect 以及全部 19 个 pg_tokenizer 函数的完整参考。
这是本节的多页打印视图。 .
参考手册与基准测试
vchord_bm25 与 pg_tokenizer 的完整 SQL 参考手册、GUC 参数、性能基准测试与版本演进历史。
- 1: SQL 参考手册
- 2: GUC 与索引参数
- 3: 性能与精度基准测试
- 4: 版本历史与 API 演进
vchord_bm25 与 pg_tokenizer 的完整技术参考资料:
v0.1–v0.3 (bm25_catalog.) 与 main 分支 (bm25.) 的会话 GUC 参数及索引存储选项。
与 Elasticsearch、Lucene、ParadeDB 及 PostgreSQL GIN 的 QPS 吞吐量与 NDCG@10 检索精度对比。
从 v0.1.0 到 v0.3.0 再到新一代原生 tsvector 架构的变更日志与模式演进。
1 - SQL 参考手册
vchord_bm25 与 pg_tokenizer 的完整 SQL 数据类型、操作符、类型转换、索引访问方法与函数参考。
vchord_bm25 数据类型
| 数据类型 | 所属模式 | 适用版本 | 文本表示形式 / 内部结构 | 说明 |
|---|---|---|---|---|
bm25vector |
bm25_catalog |
v0.1.0 – v0.3.0 |
{token_id:freq, ...}(例如 {1:1, 2:2, 15:1}) |
将 32 位无符号词元 ID 映射为 32 位词频的稀疏向量。存储策略为 STORAGE = EXTERNAL。 |
bm25query |
bm25_catalog |
v0.1.0 – v0.3.0 |
(index_oid regclass, query_vector bm25vector) |
将目标 bm25 索引 OID 与查询 bm25vector 配对的复合类型。 |
bm25query |
public / 扩展模式 |
main |
(vector tsvector, index regclass) |
将查询 tsvector 与目标 bm25 索引 OID 配对的复合类型。 |
bm25vector 字面量语法(v0.1 – v0.3)
vchord_bm25 操作符
| 操作符 | 左操作数 | 右操作数 | 返回类型 | 适用版本 | 说明 |
|---|---|---|---|---|---|
<&> |
bm25vector |
bm25query |
real (f32) |
v0.1.0 – v0.3.0 |
计算负值 BM25 相关性得分($-\text{BM25}(D, Q)$)。支持使用 bm25_ops 执行索引加速的 ORDER BY ... ASC 扫描。 |
<&> |
tsvector |
bm25query |
float8 (f64) |
main |
在原生 tsvector 上计算负值 BM25 相关性得分。支持使用 bm25_ops 执行索引加速的 ORDER BY ... ASC 扫描。 |
= |
bm25vector |
bm25vector |
bool |
v0.2.0 – v0.3.0 |
比较两个 bm25vector 值是否完全相等。 |
<> |
bm25vector |
bm25vector |
bool |
v0.2.0 – v0.3.0 |
比较两个 bm25vector 值是否不相等。 |
vchord_bm25 函数
| 函数签名 | 返回类型 | 适用版本 | 说明 |
|---|---|---|---|
to_bm25query(index_oid regclass, query_vector bm25vector) |
bm25query |
v0.1.1 – v0.3.0 |
根据 bm25 索引名称/OID 与查询 bm25vector(或经由隐式转换的 INT[])构造 bm25query。 |
to_bm25query(index_oid regclass, query_vector int[]) |
bm25query |
v0.3.0+ |
直接接受 INT[] 词元 ID 数组的显式重载函数。 |
to_bm25query(vector tsvector, index regclass) |
bm25query |
main |
根据原生 tsvector 与目标 bm25 索引名称/OID 构造 bm25query。 |
search_bm25query(target_vector bm25vector, query bm25query) |
real |
v0.1.0 – v0.3.0 |
bm25vector <&> bm25query 操作符的底层实现函数。 |
_bm25_evaluate(left tsvector, right bm25query) |
float8 |
main |
tsvector <&> bm25query 操作符的底层实现函数。 |
bm25_page_inspect(index regclass, blkno int) |
text |
v0.3.0 |
返回 bm25 索引第 blkno 号数据块的可读诊断元数据。 |
vchord_bm25 访问方法与操作符类
| 对象类型 | 名称 | 目标类型 | 排序操作符 |
|---|---|---|---|
| 访问方法 (Access Method) | bm25 |
索引 (Index) | 处理器 _bm25_amhandler |
| 操作符族 (Operator Family) | bm25_ops |
USING bm25 |
OPERATOR 1 pg_catalog.<&> FOR ORDER BY float_ops |
| 操作符类 (Operator Class) | bm25_ops |
bm25vector(v0.1–v0.3)/ tsvector(main) |
USING bm25 的默认操作符类 |
pg_tokenizer 函数(tokenizer_catalog)
所有 pg_tokenizer 函数均位于 tokenizer_catalog 模式中:
分词器管理与执行
| 函数签名 | 返回类型 | 说明 |
|---|---|---|
create_tokenizer(name TEXT, config TEXT) |
void |
根据 TOML 配置字符串创建一个命名分词器。 |
drop_tokenizer(name TEXT) |
void |
删除已有的分词器。 |
tokenize(text TEXT, tokenizer_name TEXT) |
INT[] |
使用 tokenizer_name 对 text 进行分词,返回整数词元 ID 数组(可隐式转换为 bm25vector)。 |
文本分析器管理
| 函数签名 | 返回类型 | 说明 |
|---|---|---|
create_text_analyzer(name TEXT, config TEXT) |
void |
创建可复用的命名文本分析器流水线(包含 character_filters、pre_tokenizer、token_filters)。 |
drop_text_analyzer(name TEXT) |
void |
删除指定的命名文本分析器。 |
apply_text_analyzer(text TEXT, text_analyzer_name TEXT) |
TEXT[] |
对 text 运行指定的文本分析器,返回归一化后的字符串词元数组(常用于调试分词效果)。 |
模型管理
| 函数签名 | 返回类型 | 说明 |
|---|---|---|
create_custom_model(name TEXT, config TEXT) |
void |
使用指定的文本分析器,在现有表列上训练自定义词表模型。 |
drop_custom_model(name TEXT) |
void |
删除自定义模型及其底层词表数据表。 |
create_custom_model_tokenizer_and_trigger(tokenizer_name TEXT, model_name TEXT, text_analyzer_name TEXT, table_name TEXT, source_column TEXT, target_column TEXT) |
void |
一步创建自定义模型与分词器,回填 table_name 表中的 target_column 列,并绑定自动 BEFORE INSERT OR UPDATE 触发器。 |
create_huggingface_model(name TEXT, config TEXT) |
void |
从 HuggingFace tokenizer.json 字符串导入模型。 |
drop_huggingface_model(name TEXT) |
void |
删除已导入的 HuggingFace 模型。 |
create_lindera_model(name TEXT, config TEXT) |
void |
根据 TOML 配置创建 Lindera 形态学分析模型(如 ipadic)。 |
drop_lindera_model(name TEXT) |
void |
删除 Lindera 模型。 |
词典与预加载管理
| 函数签名 | 返回类型 | 说明 |
|---|---|---|
create_stopwords(name TEXT, config TEXT) |
void |
创建自定义停用词典(每行一个停用词)。 |
drop_stopwords(name TEXT) |
void |
删除自定义停用词典。 |
create_synonym(name TEXT, config TEXT) |
void |
创建自定义同义词典(每行以空格分隔一组同义词,统一映射到该行第一个词)。 |
drop_synonym(name TEXT) |
void |
删除自定义同义词典。 |
add_preload_model(name TEXT) |
void |
注册在 PostgreSQL 服务启动(shared_preload_libraries)时预加载的模型。 |
remove_preload_model(name TEXT) |
void |
从启动预加载列表中移除指定模型。 |
list_preload_models() |
TEXT[] |
返回当前已注册为启动预加载的所有模型名称列表。 |
内部触发器与辅助函数(tokenizer_catalog)
| 函数签名 | 返回类型 | 说明 |
|---|---|---|
apply_text_analyzer_for_custom_model(text TEXT, text_analyzer_name TEXT) |
TEXT[] |
调用 text_analyzer_name 分词,并在写入自定义模型词表前自动过滤掉长度超过 2600 字节(PostgreSQL B-tree UNIQUE 索引键最大长度限制)的超长词元。 |
custom_model_insert_trigger() |
trigger |
AFTER INSERT OR UPDATE 触发器函数,从源文本列提取词元并将新出现的词元自动追加写入 tokenizer_catalog."model_<name>" 词表。 |
custom_model_tokenizer_set_target_column_trigger() |
trigger |
由 create_custom_model_tokenizer_and_trigger 安装的 BEFORE INSERT OR UPDATE 触发器函数,自动执行 NEW.<target_column> = tokenize(NEW.<source_column>, tokenizer_name)。 |
pg_tokenizer 元数据表(tokenizer_catalog)
| 表名 | 列定义 | 说明 |
|---|---|---|
tokenizer_catalog.tokenizer |
name TEXT NOT NULL UNIQUE, config TEXT NOT NULL |
存储已注册的分词器名称及其序列化后的 JSON/TOML 配置。 |
tokenizer_catalog.text_analyzer |
name TEXT NOT NULL UNIQUE, config TEXT NOT NULL |
存储独立命名且可复用的文本分析器定义。 |
tokenizer_catalog.model |
name TEXT NOT NULL UNIQUE, config TEXT NOT NULL |
存储已注册的自定义模型、HuggingFace 模型与 Lindera 模型定义。 |
tokenizer_catalog.stopwords |
name TEXT NOT NULL PRIMARY KEY, config TEXT NOT NULL |
存储内置(lucene_english、nltk_english、iso_english)及自定义停用词典。 |
tokenizer_catalog.synonym |
name TEXT NOT NULL PRIMARY KEY, config TEXT NOT NULL |
存储自定义同义词典。 |
tokenizer_catalog."model_<name>" |
id SERIAL PRIMARY KEY, token TEXT NOT NULL UNIQUE |
为每个自定义模型 <name> 自动创建的底层词表数据表,将唯一归一化词元映射为从 1 开始的自增整数 ID。 |
pg_tokenizer TOML 配置参数参考
分词器配置项(create_tokenizer)
| 参数名 | 类型 | 说明 |
|---|---|---|
text_analyzer |
string(可选) |
预先创建的命名 text_analyzer 名称。若省略,可在支持文本分析器的模型中直接内联定义 character_filters、pre_tokenizer 和 token_filters。 |
model |
string(必填) |
内置模型(llmlingua2、bert_base_uncased、wiki_tocken、gemma2b)或用户创建的模型(custom、huggingface、lindera)名称。 |
文本分析器配置项(create_text_analyzer)
| 参数名 | 类型 | 说明 |
|---|---|---|
character_filters |
array / table |
在分词前对整段字符串依次应用的字符过滤器列表:to_lowercase、unicode_normalization(nfc、nfd、nfkc、nfkd)。 |
pre_tokenizer |
string / table |
将字符串切分为初始词元的单个预分词器:unicode_segmentation、regex(Rust 正则表达式)或 jieba(mode = "full" | "precise" | "search",enable_hmm = true | false)。 |
token_filters |
array |
按顺序执行的词元过滤器列表:skip_non_alphanumeric、stemmer(支持 30 种 Snowball 词干提取器)、stopwords(内置 lucene_english、nltk_english、iso_english 或自定义停用词典)、synonym、pg_dict(除 Thesaurus 外的任意 pg_ts_dict 词典)、ngram(min_gram、max_gram 范围 1..=255,preserve_original)。 |
自定义模型配置项(create_custom_model)
| 参数名 | 类型 | 说明 |
|---|---|---|
table |
string(必填) |
包含源文本语料的目标表名称。 |
column |
string(必填) |
table 表中用于构建词表的源 TEXT 列名称。 |
text_analyzer |
string(必填) |
用于将 column 列切分为词表词元的 text_analyzer 名称。 |
2 - GUC 与索引参数
vchord_bm25 会话级 GUC 参数与索引存储选项的完整参考手册。
稳定发布版(v0.1.0 – v0.3.0):bm25_catalog.* GUC 参数
在 v0.1.0 至 v0.3.0 版本中,所有会话级 GUC 参数均使用 bm25_catalog. 前缀,任何普通用户均可在会话或事务级别修改(GucContext::Userset):
| 参数名称 | 类型 | 默认值 | 有效范围 | 说明 |
|---|---|---|---|---|
bm25_catalog.bm25_limit |
integer |
100 |
-1 .. 65535 |
单次 bm25 索引扫描返回的高分文档最大数量。设为 -1 时禁用 Block-WeakAnd 剪枝并执行全量暴力扫描;设为 0 时直接返回空结果。必须 SQL 查询中的 LIMIT 值。 |
bm25_catalog.enable_index |
boolean |
true |
true / false |
在 PostgreSQL 查询规划器中启用或禁用 bm25 索引扫描。设为 false 可强制执行顺序扫描并调用 search_bm25query 精确求值。 |
bm25_catalog.enable_prefilter |
boolean |
true |
true / false |
自 v0.2.2 引入。设为 true 时,会在将候选文档推入 Block-WeakAnd Top-K 最小堆之前,先行过滤掉不满足查询过滤条件或 MVCC 可见性检查的文档。 |
bm25_catalog.segment_growing_max_page_size |
integer |
4096 |
1 .. 1000000 |
仅追加的增长段(Growing Segment)在被封存为差分位打包压缩的只读封闭段(Sealed Segment)之前的最大尺寸(以 8 KB 页面为单位,默认值 4096 即 32 MB)。 |
配置示例(v0.1 – v0.3)
新一代 main 分支:bm25.* GUC 参数与索引存储参数
在 main 分支重构版本中,会话级 GUC 参数改用 bm25. 前缀,并与每个索引独立的存储参数(WITH (...))配合工作:
会话级 GUC 参数(main)
| 参数名称 | 类型 | 默认值 | 有效范围 | 说明 |
|---|---|---|---|---|
bm25.enable_scan |
boolean |
true |
true / false |
在查询规划器中启用或禁用 bm25 索引扫描。 |
bm25.limit |
integer |
100 |
0 .. 65535 |
单次 bm25 索引扫描返回的最大结果数。若设为 0,则回退使用索引自身的 limit 存储参数。 |
bm25.prefilter |
boolean |
false |
true / false |
在 bm25 索引扫描期间启用预过滤(当设为 true 时,会覆盖索引自身的 prefilter 存储参数)。 |
索引存储参数(main 中的 WITH (...))
| 存储参数 | 类型 | 默认值 | 有效范围 | 说明 |
|---|---|---|---|---|
options |
string (TOML) |
k1 = 1.2, b = 0.75 |
k1: 1.2..2.0b: 0.0..1.0 |
用于配置该索引 Okapi BM25 超参数 与 的 TOML 字符串。 |
limit |
integer |
0 |
0 .. 65535 |
当会话参数 bm25.limit = 0 时使用的索引级回退检索上限。 |
prefilter |
boolean |
false |
true / false |
索引级的默认预过滤设置。 |
3 - 性能与精度基准测试
VectorChord-BM25 与 Elasticsearch、Lucene、ParadeDB 及 PostgreSQL GIN 的 QPS 吞吐量与 NDCG@10 检索精度对比基准测试。
吞吐量基准测试(QPS 对比 Elasticsearch、Lucene、ParadeDB、PG GIN)
凭借结合 128 文档差分位打包块与单字节 Fieldnorm 量化的 Block-WeakAnd 算法实现,VectorChord-BM25 在 Top-10 排序查询上的 QPS 吞吐量最高可达基于 Tantivy 的 PostgreSQL 扩展(ParadeDB / pg_search)的 3 倍,并比 PostgreSQL 原生 GIN 索引高出一个数量级:
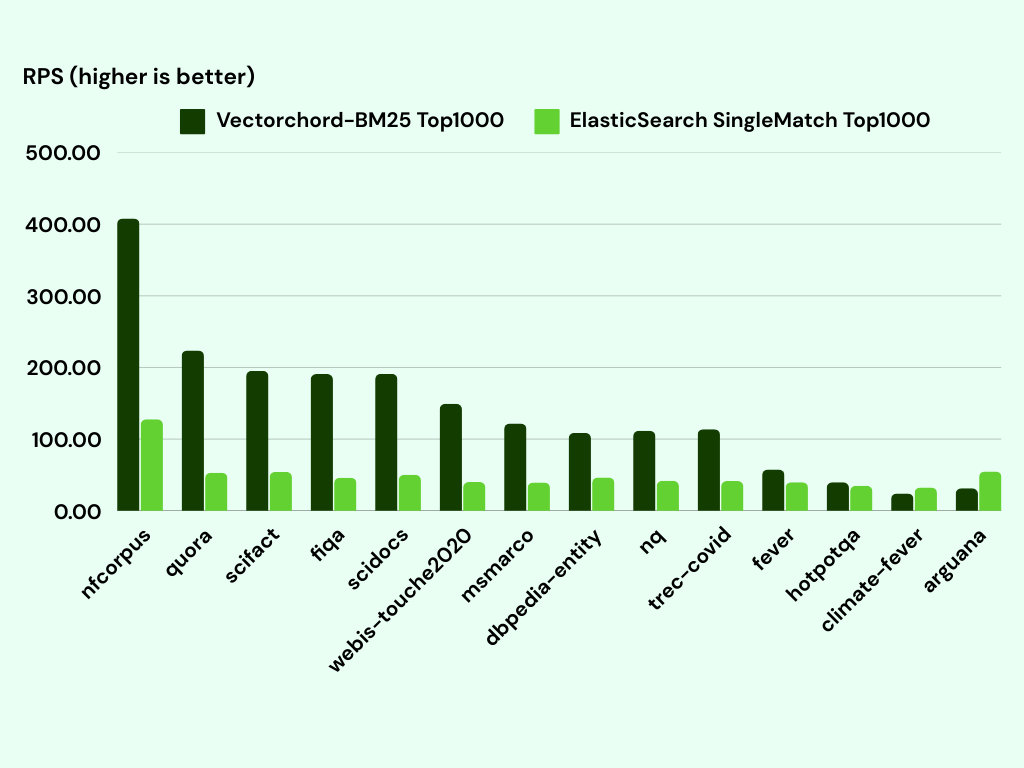
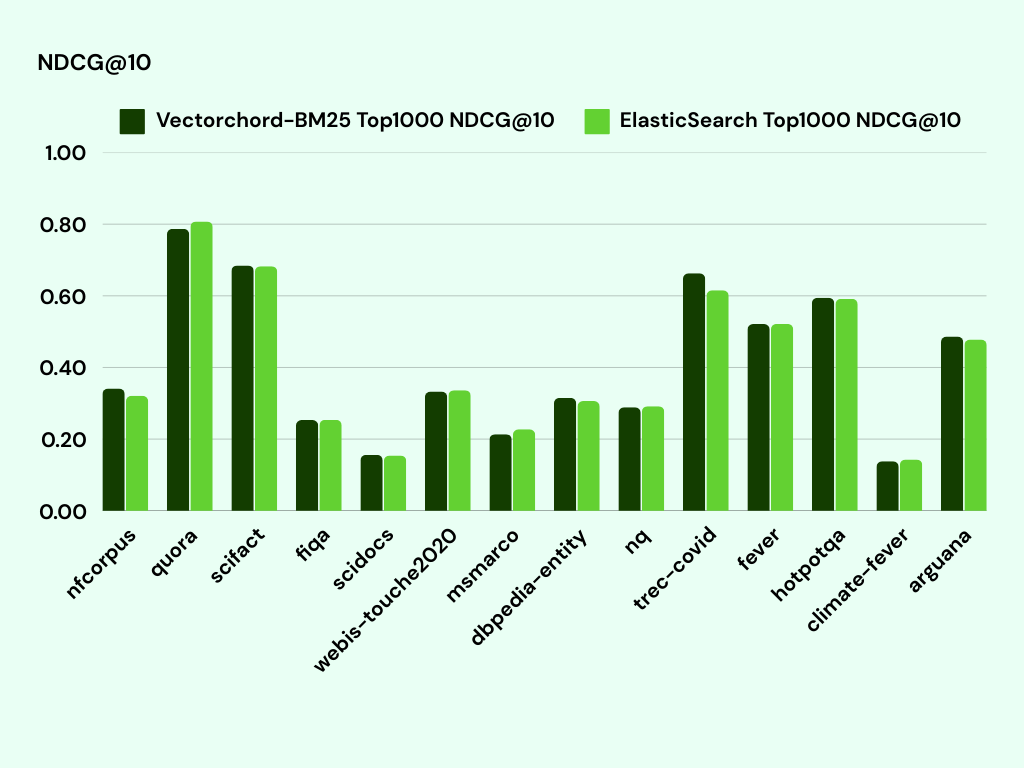
为什么 vchord_bm25 能实现极高的 QPS
- 零跨引擎序列化开销:不同于外部数据包装器(FDW)或外挂 Tantivy/Lucene 桥接方案,
vchord_bm25将段数据直接存储在 PostgreSQL 缓冲池页面(PostgresRelation)中,彻底消除了跨引擎元组编组(Marshaling)开销。 - 激进的块级上界剪枝(Block-Max Pruning):在多词查询场景下,一旦 Top-10 阈值趋于稳定,Block-WeakAnd 即可直接跳过 80%–95% 以上的 128 文档倒排块,无需对其进行解压。
- 256 项预计算 BM25 查找表:将文档长度量化为单字节
fieldnorm,使原本昂贵的逐文档浮点运算简化为单次数组查表。
检索精度基准测试(BEIR 与 LoTTE 上的 NDCG@10)
下表(摘自我们的 BEIR / LoTTE 混合检索与 ColBERT 重排序评测报告)对比了以下三种方案的检索精度(NDCG@10):
- PostgreSQL
vchord稠密向量检索(Vector) - PostgreSQL
vchord_bm25词法检索(BM25) - 混合检索(
vchord+vchord_bm25配合 ColBERT 重排序)
| 数据集 | 领域 | 稠密向量 (vchord) |
词法 BM25 (vchord_bm25) |
混合检索 + ColBERT 重排序 |
|---|---|---|---|---|
| scifact | 科学事实核查 | 0.676 | 0.665 | 0.751 |
| nfcorpus | 生物医学信息检索 | 0.340 | 0.325 | 0.370 |
| fiqa | 金融问答 | 0.405 | 0.236 | 0.415 |
| trec-covid | 生物医学 COVID-19 | 0.728 | 0.656 | 0.838 |
| LoTTE-lifestyle (search) | 生活方式问答(搜索) | 0.735 | 0.635 | 0.779 |
| LoTTE-lifestyle (forum) | 生活方式论坛 | 0.662 | 0.506 | 0.701 |
| LoTTE-recreation (search) | 休闲娱乐问答 | 0.642 | 0.564 | 0.708 |
| LoTTE-technology (search) | 技术问答 | 0.562 | 0.483 | 0.647 |
| LoTTE-writing (search) | 写作问答 | 0.726 | 0.674 | 0.793 |
提示
在所有评测数据集上,将 vchord_bm25 与 vchord 结合使用均稳定超越单独使用稠密向量检索或单独使用词法 BM25 检索。如需获取开箱即用的 SQL 查询模板,请参阅混合检索 (BM25 + VectorChord)。
4 - 版本历史与 API 演进
VectorChord-BM25 (vchord_bm25) 从 v0.1.0 到 v0.3.0 再到 main 分支的版本变更日志与 SQL 模式演进。
本页记录 vchord_bm25(pgsty/vchord_bm25 / supervc-stack/VectorChord-bm25)的版本发布历史与 SQL 模式演进。
版本演进总览矩阵
| 版本 | 所属模式 | 索引列类型 | 分词方案 | 核心新增特性 |
|---|---|---|---|---|
main(新一代架构) |
扩展所在模式 | tsvector |
原生 to_tsvector(或自定义) |
基于原生 tsvector 完全重写存储与索引引擎;支持外部排序并行构建(ambuild);引入索引级存储参数(options、limit、prefilter);引入 bm25.* GUC 参数;支持 PostgreSQL 18。 |
v0.3.0 |
bm25_catalog |
bm25vector |
pg_tokenizer |
新增 bm25_page_inspect(regclass, int) 函数、to_bm25query(regclass, int[]) 重载,以及 PostgreSQL 18 兼容性支持。 |
v0.2.2 |
bm25_catalog |
bm25vector |
pg_tokenizer |
新增 bm25_catalog.enable_prefilter GUC 参数,支持带 WHERE 子句的精确过滤 Top-K BM25 检索。 |
v0.2.1 |
bm25_catalog |
bm25vector |
pg_tokenizer |
修复增长段(Growing)向封闭段(Sealed)转换以及 VACUUM 清理过程中的若干缺陷。 |
v0.2.0 |
bm25_catalog |
bm25vector |
pg_tokenizer |
为 bm25vector 新增 = 与 <> 相等性操作符,以及隐式类型转换 CREATE CAST (int[] AS bm25vector) AS IMPLICIT。 |
v0.1.1 |
bm25_catalog |
bm25vector |
pg_tokenizer |
将分词能力解耦为独立的 pg_tokenizer 扩展;调整 to_bm25query(regclass, bm25vector) 函数签名。 |
v0.1.0 |
bm25_catalog |
bm25vector |
内置 unicode |
首个发布版本,提供 bm25vector、bm25query、USING bm25 及 Block-WeakAnd Top-K 扫描。 |
各版本升级变更详解
v0.3.0(sql/vchord_bm25--0.2.2--0.3.0.sql)
- 新增页面诊断函数:
- 在
main/0.3.x后期版本中新增了直接接受int[]的便捷重载to_bm25query(regclass, int[])。
v0.2.2(sql/vchord_bm25--0.2.1--0.2.2.sql)
- 在 Block-WeakAnd 中新增预过滤支持(
bm25_catalog.enable_prefilterGUC 参数,在0.3.0中默认启用)。 - 改进索引扫描期间的 MVCC 可见性检查,防止死元组(Dead Tuples)或被过滤元组污染 Top-K 剪枝阈值。
v0.2.0(sql/vchord_bm25--0.1.1--0.2.0.sql)
- 为
bm25vector新增=与<>操作符。 - 新增从
int[]到bm25vector的隐式类型转换(_vchord_bm25_cast_array_to_bm25vector),允许将tokenize(text, name)的输出(INT[])直接赋值给bm25vector列或传入任何接受bm25vector的位置。
v0.1.1(sql/vchord_bm25--0.1.0--0.1.1.sql)
- 将原本内置的
create_tokenizer/tokenize函数抽离为独立的pg_tokenizer扩展(tokenizer_catalog),从而支持丰富的文本分析器、Snowball 词干提取、停用词、同义词、HuggingFace 模型、jieba中文分词与lindera日文分词。 - 简化
to_bm25query(index_oid regclass, query_vector bm25vector)签名,直接接受bm25vector参数。
新一代架构重写(main 分支)
- 用 PostgreSQL 原生
tsvector替代自定义bm25vector类型(CREATE OPERATOR CLASS bm25_ops FOR TYPE tsvector USING bm25),允许用户直接使用USING bm25为to_tsvector(...)列建立索引。 - 新增基于外部归并排序(External Merge Sort)的并行索引构建(
bm25_parallel_build_main),保证恒定的维护内存消耗。 - 支持通过
WITH (options = $$ k1 = 1.2, b = 0.75 $$)配置索引级 BM25 超参数(,)。