1 - 注册云账户
只需几秒即可注册 VectorChord Cloud 并免费开始使用。
如需了解 Cloud 免费套餐包含的内容,请参阅 Cloud 免费套餐。如需了解 Cloud 的付费套餐选项,请参阅 Cloud 套餐。
注册
注册 VectorChord Cloud 非常简单。只需访问 https://cloud.vectorchord.ai 并使用您的 GitHub 账户注册即可。
完成注册后,系统会将您引导至 VectorChord Cloud 控制台,并为您创建一个默认项目。
后续步骤
2 - 快速开始
本指南将帮助您快速上手 VectorChord Cloud。首先,您需要注册一个 VectorChord Cloud 账户。如果您还没有账户,可以在此处免费注册。
创建集群
您需要先绑定信用卡,然后才能创建企业版(Enterprise)套餐集群。
要创建新集群,请前往 VectorChord Cloud 控制台并点击“Create Cluster”按钮。
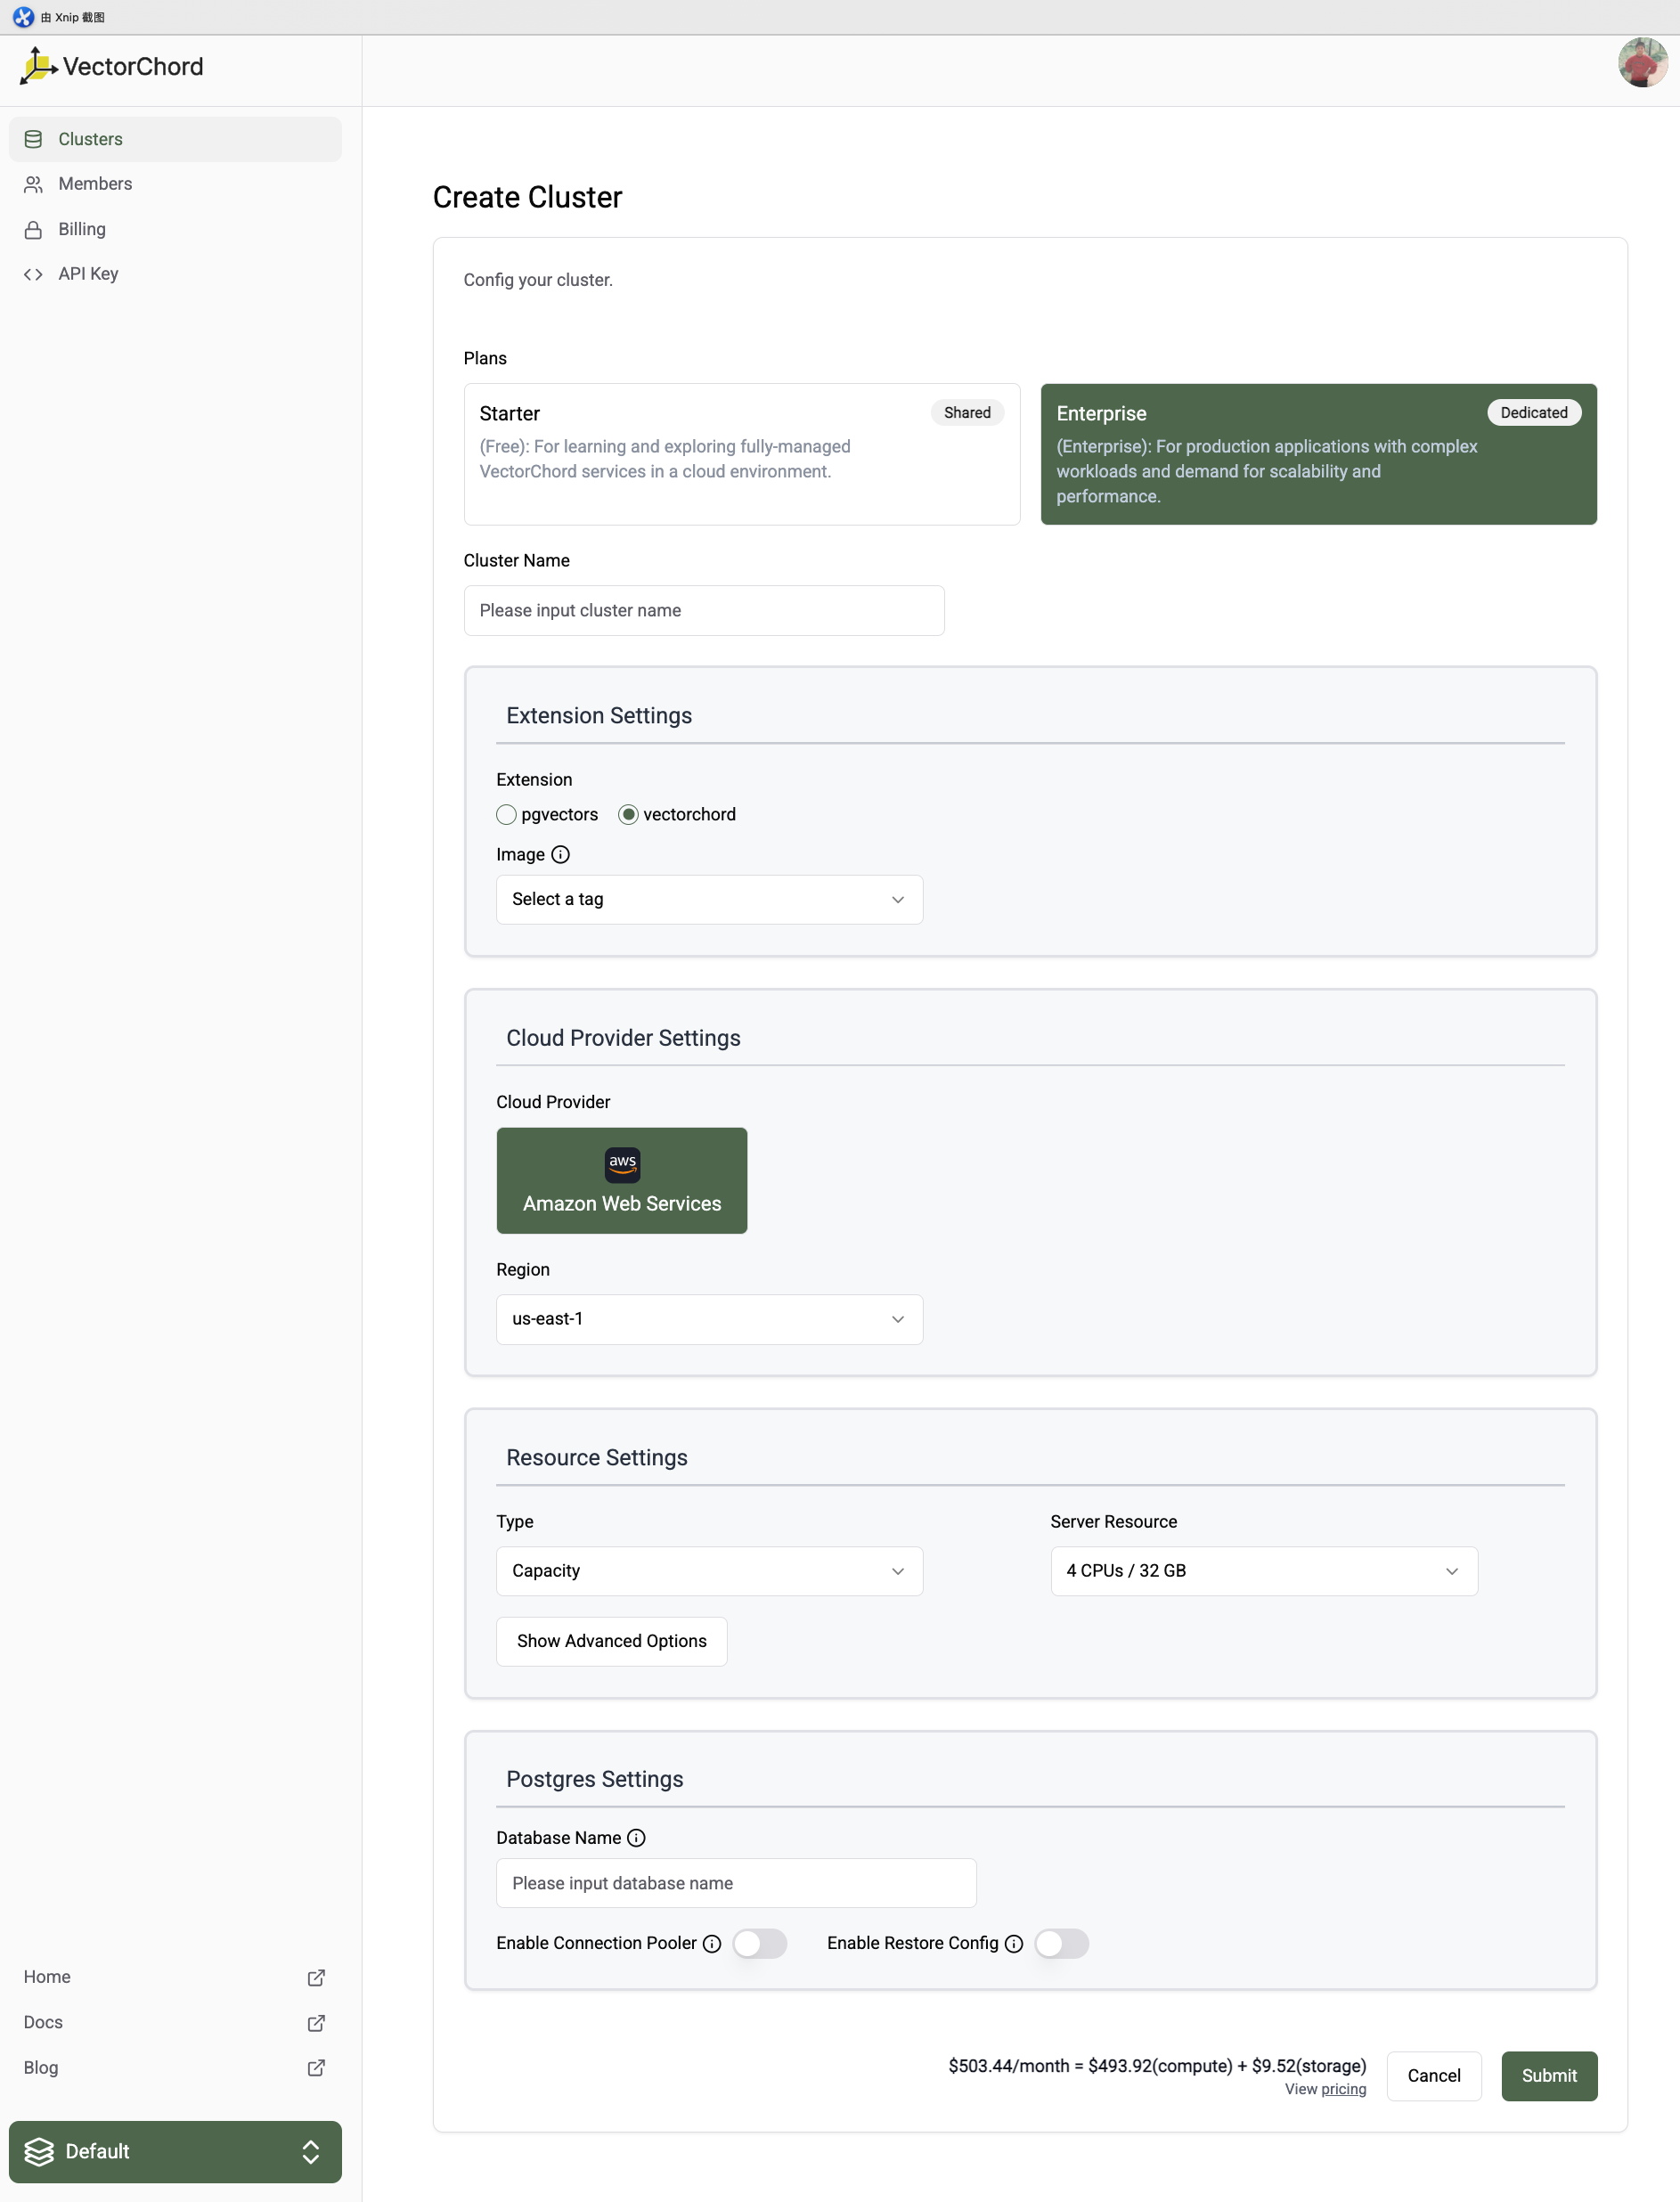
您需要指定以下信息:
- 必填项:
- Plan(套餐):您希望用于该集群的套餐。有关 Cloud 付费套餐选项的详细信息,请参阅 Cloud 套餐。
- Cluster Name(集群名称):集群的唯一名称。
- Extension Settings(扩展设置):
-
Extension(扩展):我们支持两种向量搜索扩展:pgvectors 及其继任者 vectorchord
- vectorchord:Postgres 中可扩展、快速且磁盘友好的向量搜索扩展
- pgvectors:Postgres 中可扩展、低延迟且支持混合搜索的向量搜索扩展。革新向量搜索,而非更换数据库。
警告vectorchord仅支持配备 NVMe SSD 的服务器资源规格。 -
Image(镜像):
- 对于 VectorChord,我们提供语义化版本格式的标签,例如
16-v0.1.0:16表示 Postgres 主版本号v0.1.0表示 VectorChord 版本号
- 对于 pgvecto.rs,我们提供语义化版本格式的标签,例如
16-v0.4.0-vectors-exts:16表示 Postgres 主版本号v0.4.0表示 pgvecto.rs 版本号vectors表示 pgvecto.rs schema 的安装位置,可选值为vectors、extensions、public。如果您希望在 AWS RDS 上搭配使用 VectorChord Cloud,请选择public。如果您打算在 Supabase 上使用 FDW,请选择extensions。exts表示集群支持从 https://pgt.dev/ 安装扩展。
- 对于 VectorChord,我们提供语义化版本格式的标签,例如
-
- Cloud Provider Settings(云厂商设置):
- Cloud Provider(云厂商):部署集群的云服务提供商,目前仅支持 AWS。
- Region(区域):部署集群所在的区域。
- Resource Settings(资源设置):
- Type(类型):我们提供两种资源类型:
Performance(性能型)和Capacity(容量型)。 - Server Resource(服务器资源规格):
- Performance(性能型):
- 1C/2G:免费套餐,1 核 CPU、2GB 内存和 3Gi 磁盘空间。
- 2C/8G:企业版套餐,2 核 CPU、8GB 内存和 15Gi 磁盘空间。
- 2C/16G:企业版套餐,2 核 CPU、16GB 内存和 15Gi 磁盘空间。
- 4C/32G:企业版套餐,4 核 CPU、32GB 内存和 90Gi 磁盘空间。
- Capacity(容量型):
- 4C/32G NVMe SSD:企业版套餐,4 核 CPU、32GB 内存和 850Gi NVMe SSD 磁盘空间。
- Performance(性能型):
- Type(类型):我们提供两种资源类型:
- Postgres Settings(Postgres 设置):
- Database Name(数据库名称):用于存储向量数据的数据库名称。
- Enable Connection Pooler(启用连接池,默认值:
false):为集群启用连接池。 - Enable Restore Config(启用恢复配置,默认值:
false):启用恢复配置,以从其他集群创建的备份进行恢复。 - Optional(可选项):
- Disk Size(磁盘大小):Postgres PGData 磁盘大小,将覆盖默认磁盘大小。
- Instances(实例数):集群中的实例数量,默认值为 1。
警告目前向量索引尚不支持流复制(Streaming Replication)。
集群信息
创建集群后,系统会将您引导至集群信息页面。在这里,您可以查看集群的详细信息,例如连接字符串、集群状态以及集群的资源使用情况。
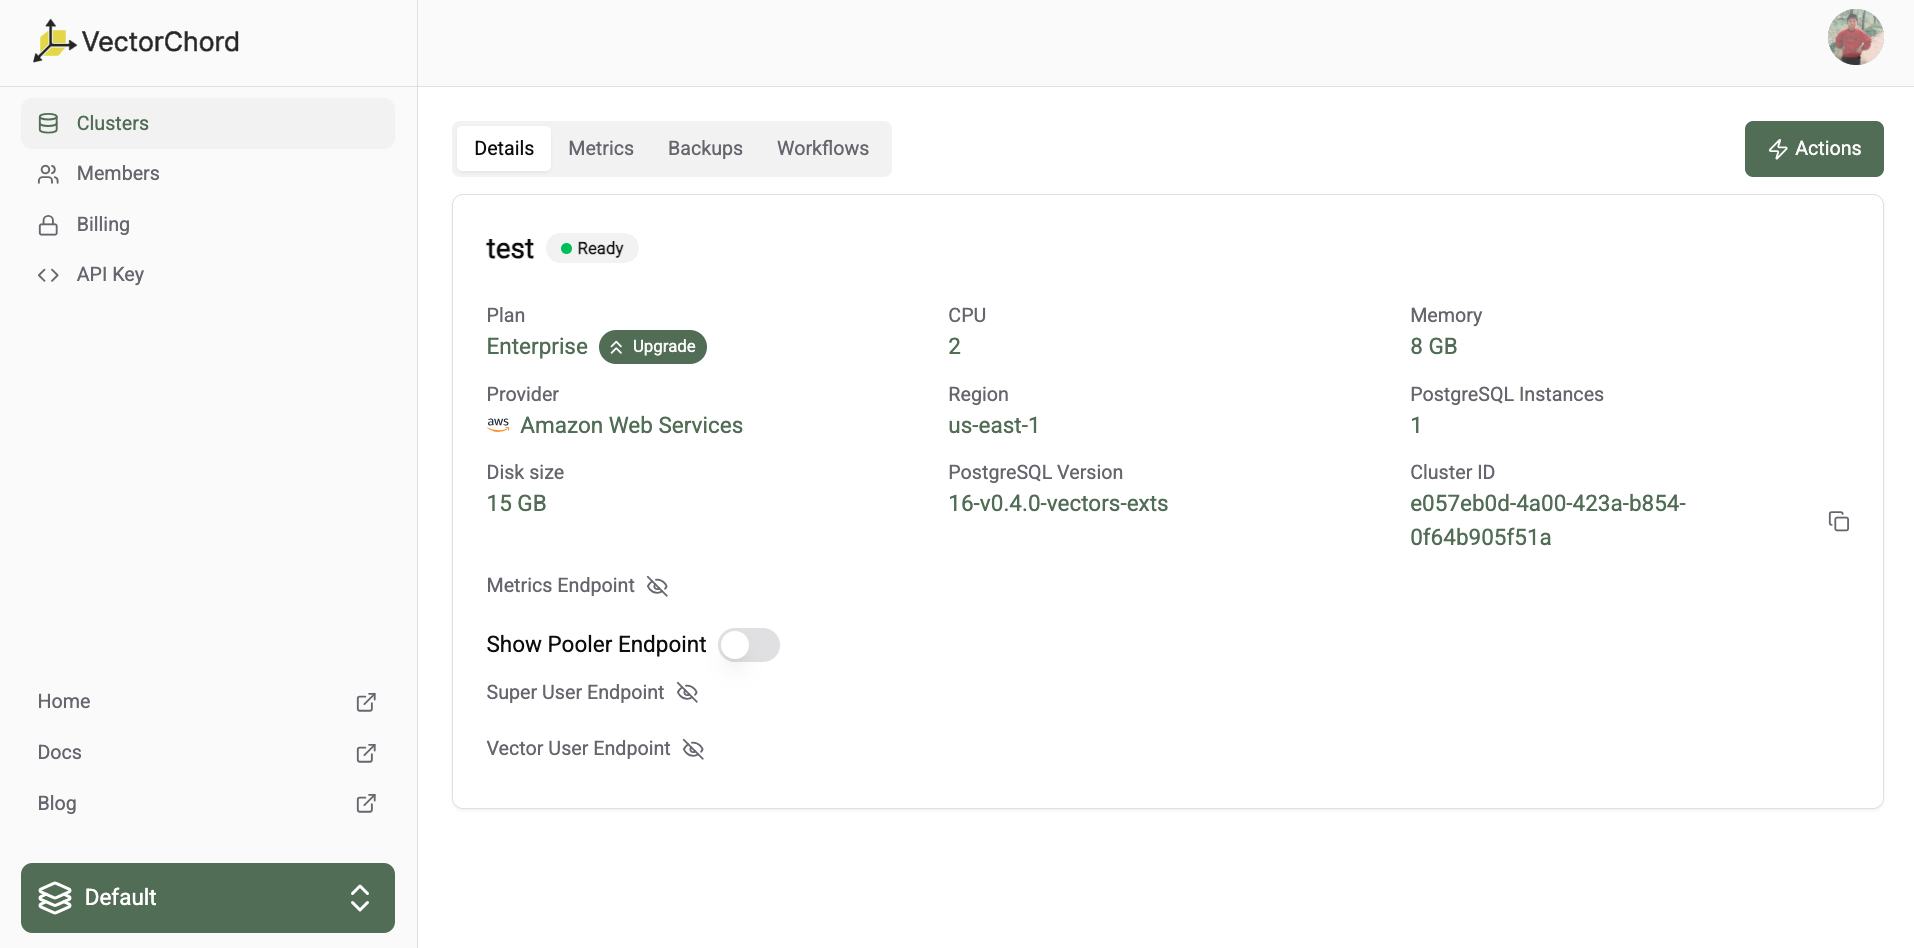
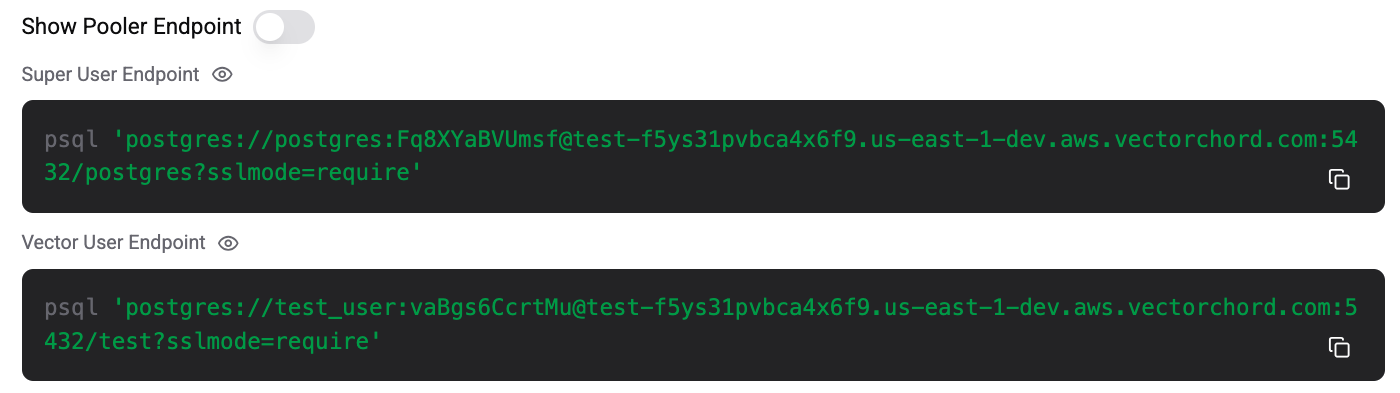
我们提供两种类型的连接端点,分别是 Super User Endpoint(超级用户端点)和 Vector User Endpoint(向量用户端点)。有关这两种连接方式的更多信息,请参阅使用 psql 连接。
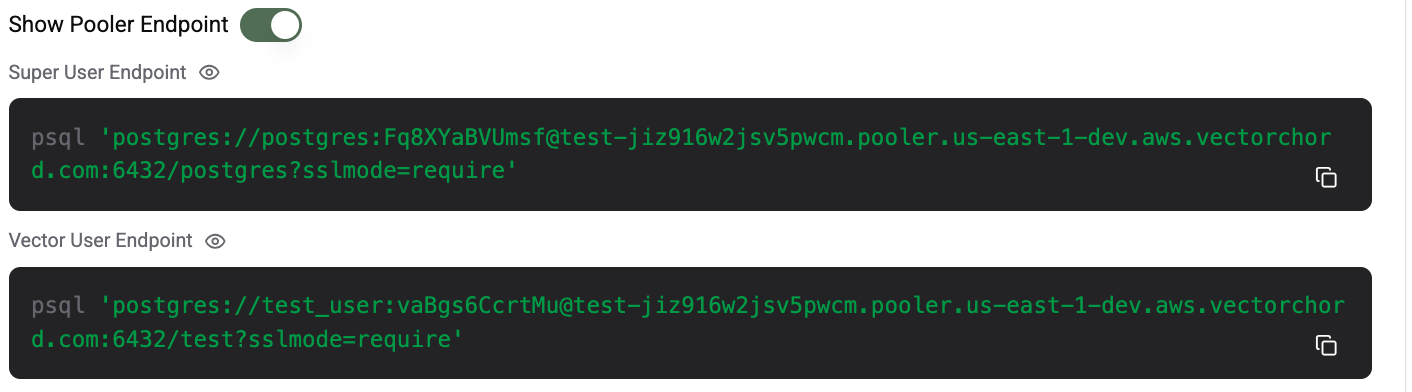
如果在创建集群时勾选了 Enable Connection Pooler,您可以点击 Show Pooler Endpoint 按钮获取连接池端点。
连接到集群
要连接到集群,您可以使用页面提供的连接字符串,并通过 psql 命令行工具进行连接。有关如何连接到集群的详细说明,请参阅使用 psql 连接 VectorChord Cloud。连接到集群后,我们可以执行 \dx 命令来验证 vectors 扩展是否已成功安装。
创建索引
在快速开始中,我们将创建一个简单的索引。如果您想创建更高级的索引,请参阅索引参考文档。我们还提供了丰富的使用场景示例,请参阅使用案例。
监控
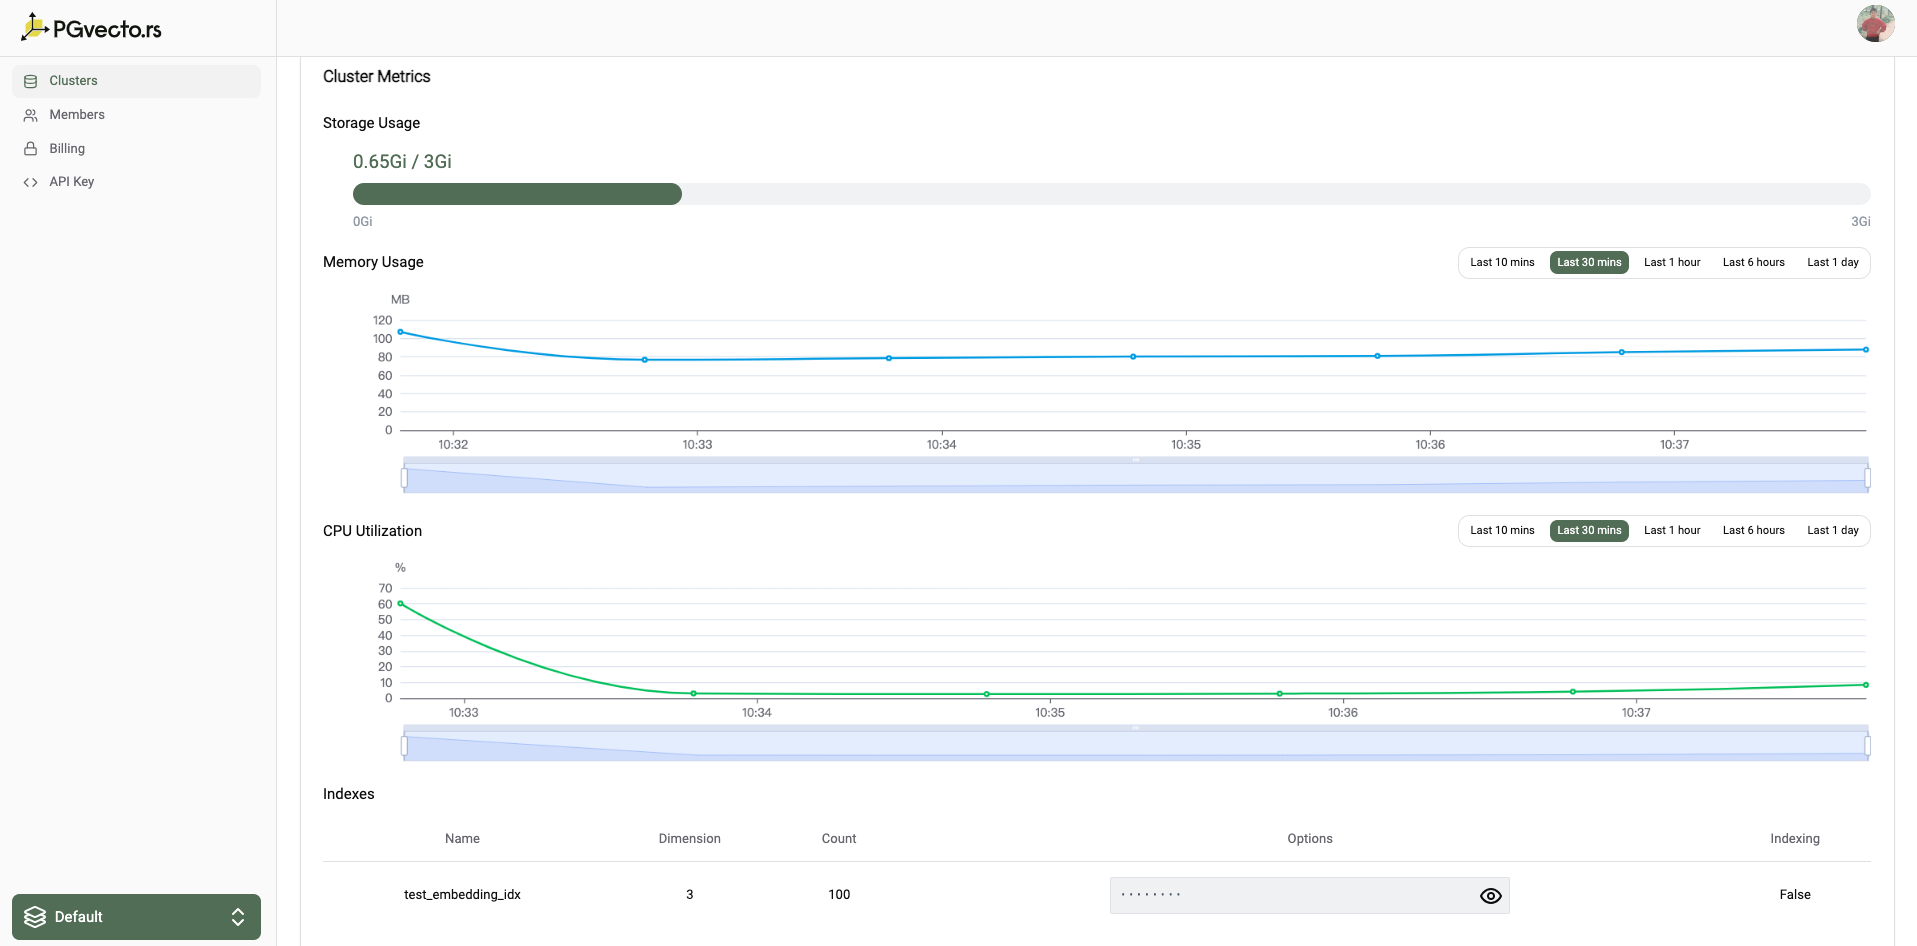
您可以在监控指标(Metrics)页面查看集群的 CPU 使用率、内存使用量以及 PGData 磁盘总量与已用空间。您还可以查看索引信息,例如索引中的向量数量、向量维度等。有关监控的详细信息,请参阅监控。