# PostgreSQL 全文检索:用对方法其实很快(打破“慢”的迷思)
> 通过简单的标准优化将 PostgreSQL 全文检索速度提升 50 倍;结合 VectorChord-BM25 在 Postgres 中实现更快、更精准的 BM25 排序。
---
LLMS 索引: [llms.txt](/zh/llms.txt)
---
你可能在一些技术讨论或博客文章中看到过这样的观点:与专用搜索引擎或特定扩展相比,PostgreSQL 内置的全文检索(Full-Text Search,简称 FTS)在性能上表现不佳。近期一个典型的例子是 **Neon 发布的博客文章《Performance Benchmark: pg\_search on Neon》**([链接](https://neon.tech/blog/pgsearch-on-neon))。
在这项基准测试中,Neon 将其数据库平台上搭载 `pg_search` 扩展(基于 Rust 的 Tantivy 库并通过 `pgrx` 构建)的查询性能,与使用 `tsvector` 和 GIN 索引的 Postgres 内置全文检索进行了对比。值得肯定的是,他们声明已通过在适当位置添加 GIN 索引对标准配置进行了优化(基准测试代码见[此处](https://github.com/paradedb/paradedb/tree/dev/benchmarks))。
然而,虽然添加 GIN 索引是必要的第一步,但测试结果中“标准”配置表现出的显著慢速表明,PostgreSQL FTS 几个至关重要的*额外*优化步骤很可能被遗漏了。所谓“标准 FTS 天生比 `pg_search` 慢得多”的结论,很可能是建立在一个无意间被严重拖累的基线(baseline)之上的。
接下来,让我们深入探讨如何*正确*配置和使用标准 PostgreSQL FTS 以发挥其最佳性能,剖析 Neon 基准测试基线中很可能存在的具体配置缺陷,并展示内置 FTS 的真实速度。我们将通过翔实的数据证明:只需对基线配置应用这些标准优化,就能直接带来**约 50 倍的性能提升**。
## **基准测试环境回顾(来自 Neon 的分析)** {#the-benchmark-setup-recap-from-neons-analysis}
该测试使用了一个包含 1000 万条日志记录的表,表结构类似如下:
```sql
CREATE TABLE benchmark_logs (
id SERIAL PRIMARY KEY,
message TEXT,
country VARCHAR(255),
severity INTEGER,
timestamp TIMESTAMP,
metadata JSONB
);
```
他们测试了多种查询类型,其中许多涉及检索 `message` 文本字段。在其“标准 Postgres”示例中,查询结构如下:
```sql
-- Create index on to_tsvector('english', message)
CREATE INDEX message_gin ON benchmark_logs USING gin (to_tsvector('english', message));
-- Example problematic query structure (likely used in Neon's baseline)
SELECT country, COUNT(*)
FROM benchmark_logs
WHERE to_tsvector('english', message) @@ to_tsquery('english', 'research')
GROUP BY country
ORDER BY country;
```
即便 `message` 上已经创建了函数 GIN 索引,这种查询写法以及很可能保留了默认值的 GIN 索引配置,正是导致*标准 FTS 基线*出现性能问题的根源。
#### **我们的测试环境详情(复现基线场景)** {#our-test-environment-details-replicating-the-baseline-scenario}
为了展示正确优化对标准 FTS 的实际影响,我们使用了以下环境:
* **实例规格**:配备**本地 NVMe SSD** 的 AWS EC2 `i7ie.xlarge`(将磁盘 I/O 干扰降至最低)。
* **CPU**:**4 vCPU**。
* **PostgreSQL 配置**:通过 Docker 运行 PostgreSQL 16,并根据硬件资源进行了如下配置:
```bash
docker run -d \
--name my-postgres \
--network=host \
-v /mnt/localssd/pgdata:/var/lib/postgresql/data \
-e POSTGRES_PASSWORD=mysecretpassword \
postgres:latest \
-c shared_buffers=8GB \
-c maintenance_work_mem=8GB \
-c max_parallel_workers=4 \
-c max_worker_processes=4
```
* **关于并行度的说明**:上述配置默认提供 `max_parallel_workers_per_gather = 2`。Neon 的文章提到由于实例规格较大,其测试环境使用了 8 个并行工作进程,意味着其查询并行度(`max_parallel_workers_per_gather` 最高可达 8)高于我们的测试环境。换言之,我们对*标准* FTS 的优化结果是在*更低*的查询并行度下取得的。
**误区 #1**:在查询时实时计算 `tsvector`(主要问题)
Neon 博客中展示的示例查询(在初级 FTS 教程中也很常见)在 `WHERE` 子句中实时计算 `tsvector`:
```sql
WHERE to_tsvector('english', message) @@ to_tsquery('english', 'research')
```
这会迫使 PostgreSQL:
1. **执行高开销的重复计算**:在查询执行期间,针对大量数据行反复运行 `to_tsvector()`(包括解析、词干提取等操作)。
2. **限制索引效率**:阻碍对 GIN 索引最直接、最高效的利用,即便基础 `message` 列上已经创建了表达式索引。
#### **修复方法(构建合理的标准 FTS 基线):预计算并持久化存储 `tsvector`。** {#the-fix-for-a-proper-standard-fts-baseline-pre-calculate-and-store-the-tsvector}
1. **添加独立的** `tsvector` 列:
```sql
ALTER TABLE benchmark_logs ADD COLUMN message_tsvector tsvector;
```
2. **填充该列数据**:
```sql
UPDATE benchmark_logs SET message_tsvector = to_tsvector('english', message);
```
3. **在该** `tsvector` 列上创建索引(并设置 `fastupdate=off`):(详见下方误区 #2 的修复)
4. **改写查询语句**:
```sql
-- Optimized standard FTS query
SELECT country, COUNT(*)
FROM benchmark_logs
WHERE message_tsvector @@ to_tsquery('english', 'research') -- Use the indexed column!
GROUP BY country
ORDER BY country;
```
**误区 #2**:忽略 GIN 索引的 `fastupdate` 参数(次要问题)
虽然 Neon 的基准测试正确地选择了 GIN 作为标准 FTS 的索引类型,但它很可能使用了默认设置:`fastupdate=on`。
* `fastupdate=on`(默认):通过使用待处理列表(pending list)优先保障索引的*更新*速度。随着时间推移,这会显著拖慢*搜索*速度——尤其是在基准测试所用的大型静态数据集上,因为查询时必须同时扫描主索引和不断增长的待处理列表。此外,它还会导致索引膨胀和页面结构效率下降。
* `fastupdate=off`:优先保障*搜索*速度。虽然索引写入更新会变慢,但生成的索引结构更加紧凑,且由于无需扫描待处理列表,查询速度会快得多。对于读密集型工作负载或测试检索性能的基准测试而言,这一设置必不可少。
为了围绕*搜索*速度进行公平对比,标准 FTS 基线应当使用 `fastupdate=off`。
**修复方法(构建合理的标准 FTS 基线):**
```sql
-- Create the GIN index correctly for search speed
CREATE INDEX idx_gin_logs_message_tsvector
ON benchmark_logs USING GIN (message_tsvector) -- Index the dedicated tsvector column
WITH (fastupdate = off);
```
#### **性能影响:标准 FTS 获得约 50 倍加速** {#the-performance-impact-a-50x-speedup-for-standard-fts}
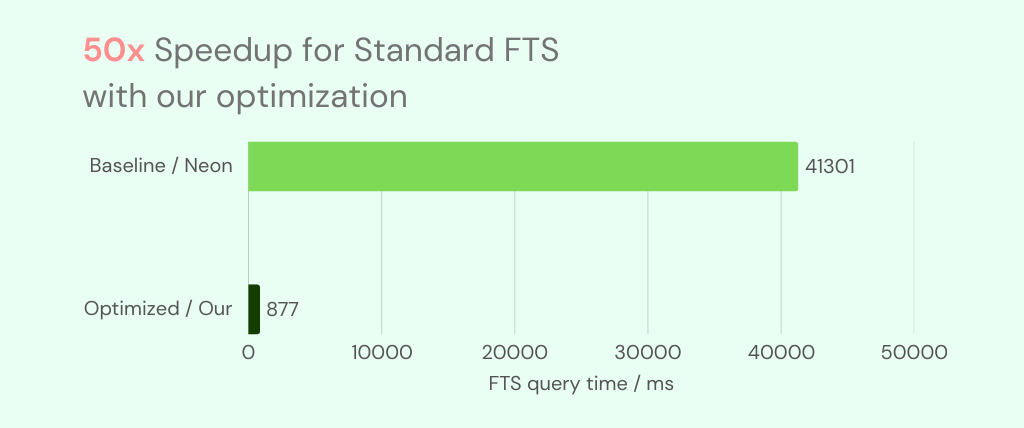
当我们将这些*标准*优化措施应用到*标准* PostgreSQL FTS 配置上时,会发生什么?我们在 1000 万行数据集上测试了 Neon 示例中的同一条查询:
* **未优化的标准 FTS(Neon 基线配置)**:~41301 ms(41.3 秒)
* **优化后的标准 FTS(应用上述修复后)**:~877 ms(0.88 秒)
这证明仅需应用业界公认的最佳实践,就能让*标准 PostgreSQL FTS* 获得**约 50 倍的速度提升**。这彻底改变了基线性能表现,说明 Neon 基准测试中所用的参照点可能并未反映出内置 FTS 的真实潜力。而且,这一加速效果还是在可用查询并行度低于 Neon 测试环境的情况下实现的。
## **客观事实:相关性排序(`ts_rank`)的性能局限** {#the-grain-of-truth-ranking-ts_rank-performance}
不过,Neon 的分析在排序速度方面确实指出了一个切中要害的问题。与单纯找出匹配行相比,标准 PostgreSQL 中的 `ts_rank` 或 `ts_rank_cd` 等排序函数*确实*相对较慢。这是因为在执行 `LIMIT` 截断之前,排序函数需要获取并处理所有匹配行的数据,这会带来可观的 I/O 和 CPU 开销。
## **超越标准 FTS:使用 VectorChord-BM25 实现高性能排序** {#beyond-standard-fts-advanced-ranking-with-vectorchord-bm25}
虽然标准 FTS 非常擅长快速*过滤出*匹配文档,但如果业务对精细、高性能的*相关性排序(ranking)*有严格要求,通常就需要借助专门的工具了。与其仅依赖内置排序函数,不如考虑使用 [**VectorChord-BM25**](https://github.com/tensorchord/VectorChord-bm25)。
[**VectorChord-BM25**](https://github.com/tensorchord/VectorChord-bm25) 是一款专为基于广受认可的 **BM25 算法**进行快速相关性排序而设计的 PostgreSQL 扩展。BM25 超越了简单的词项匹配,通过综合词项在文档内的词频(TF)以及在整个文档集合中的逆文档频率(IDF)来精准评估相关性。

VectorChord-BM25 的核心优势包括:
* **极致性能**:专为速度打造,在排序任务中表现优于 Elasticsearch(最高快 3 倍)及 `pg_search` 等同类方案。
* **标准 BM25 算法**:实现了经典、高效的相关性排序模型。
* **专用索引结构**:采用专用的 `bm25` 索引类型(结合了 Block-WeakAnd 等算法优化),这对于实现极速跳过非Top-K候选以及计算 BM25 评分所需的全局统计信息至关重要。
* **专用数据类型**:引入了 `bm25vector` 类型,专门用于存储适配 BM25 计算的分词表征。
如果你的应用高度依赖相关性排序的质量与速度,且标准 `ts_rank` 难以满足需求,[**VectorChord-BM25**](https://github.com/tensorchord/VectorChord-bm25) 在 PostgreSQL 内部提供了一个强大、原生集成的替代方案。
## **总结:标准 FTS 比你想象的要快得多** {#conclusion-standard-fts-is-faster-than-you-might-think}
只要通过持久化的 `tsvector` 列和正确配置的 GIN 索引(针对读场景设置 `fastupdate=off`)进行合理优化,标准 PostgreSQL FTS 在*查找匹配文档*方面完全具备极其出色的性能。那些声称它很慢的基准测试,往往是在与未经妥善优化的基线进行对比。
而对于标准 `ts_rank` 力有未逮的高级*相关性排序*场景,像 **VectorChord-BM25** 这样的专用扩展通过专用数据类型和优化索引策略实现了 BM25 算法,能够带来数量级的性能飞跃。
请为你的任务选择合适的工具:首先正确优化标准 FTS;如果高性能相关性排序至关重要,不妨探索专为该目标打造的扩展方案。
%[https://github.com/tensorchord/VectorChord-bm25]