# VectorChord 0.5:全新的 RaBitQ 赋能 DiskANN 索引与持续召回率评估
> Postgres 向量搜索中的 DiskANN 索引与持续召回率监控
---
LLMS 索引: [llms.txt](/zh/llms.txt)
---
我们非常激动地宣布发布 **VectorChord 0.5**!此次发布标志着我们在提供更灵活、更强大、更可控的向量搜索能力这一使命上迈出了重要一步。在 0.5 版本中,我们引入了两项重大更新:**对 DiskANN 图索引的实验性支持**,以及全新的**用于主动监控 IVF+RaBitQ 索引健康状况的召回率评估工具**。
## 全新索引预览:RaBitQ 赋能的 DiskANN 索引 {#new-index-preview-rabitq-empowered-diskann-index}
从第一天起,VectorChord 的核心索引方案就建立在一个强大的组合之上:基于聚类的 IVF 算法与 RaBitQ 量化——也就是我们提供的 **vchordrq (IVF+RaBitQ)**。这一方案在广泛的应用场景中始终保持着出色的低延迟与高召回率表现,并且仍然是我们在绝大多数场景下的**默认推荐方案**。
与此同时,我们也认识到,**在某些特定数据集以及特定(通常是更高)的召回率目标下**,**基于图的索引(Graph-Based Indexes)**能够展现出比 IVF+RaBitQ 更优的性能。为了让你在面对不同任务时都能拥有最趁手的工具——也因为我们的目标是成为**向量搜索的一站式解决方案**——VectorChord 0.5 引入了**对 DiskANN 算法的实验性支持**作为额外选项。
### 什么是 DiskANN?它为何重要? {#what-is-diskann-and-why-does-it-matter}
传统的顶尖图算法(如 HNSW 和 NSG)通过将整张图保存在内存中来实现高速检索,但这推高了硬件成本,并限制了单节点的可扩展规模。SSD 虽然价格低廉,但过去其随机 I/O 特性使得磁盘图索引难以在不付出高昂延迟代价的情况下投入实用。
**DiskANN 的使命**正是打破这一内存壁垒。它是一种从零开始设计的图近似最近邻(ANN)算法,旨在使用廉价的 SSD 存储和搜索十亿级规模的数据集,同时保持极具竞争力的召回率和低延迟。
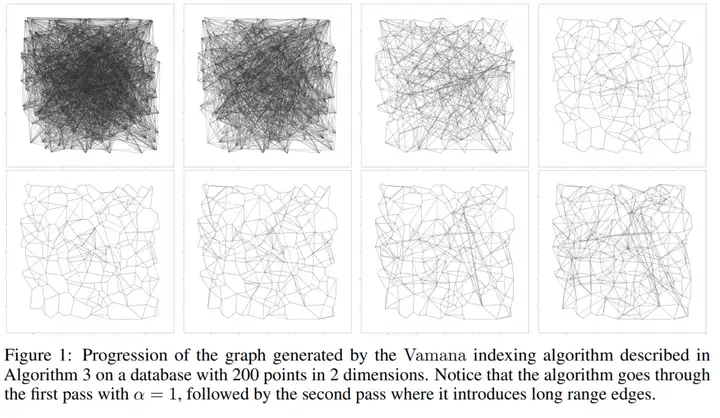
> 来自 DiskANN 原论文的可视化示意图。
#### 我们的变体有何不同 {#how-our-variant-differs}
我们实现了**原始 DiskANN 设计的一个变体**:我们没有采用原论文默认的乘积量化(Product Quantization, PQ),而是使用 **RaBitQ** 作为量化层。**RaBitQ 精度更高且具备理论误差界保证**,这帮助我们实现了比原版实现中使用的普通 PQ **更优的召回率—延迟权衡**。在实际应用中,这一改进使我们能够在相同的存储占用下获得更高的精度,或者在相同的召回率下实现更快的查询。
在 VectorChord 0.5 中,我们将 DiskANN 集成到了现有生态系统中,方便你将其与 vchordrq 进行并排对比评估。
**DiskANN 大放异彩的场景**
* **取决于工作负载与目标的收益**:对于某些模型家族(例如 OpenAI/Cohere 风格的嵌入)以及**高召回率设置**,在相同硬件上,DiskANN 可以提供比 IVF+RaBitQ **更低的延迟和/或更高的召回率**。
* **稳定且可预测的构建内存**:它避免了 IVF 的 KMeans 聚类阶段,减少了索引构建期间的内存波动,简化了容量规划。
* **生态系统兼容性**:依然可以使用 **VBase** 进行元数据过滤,并利用 **RaBitQ 量化**实现更小的存储占用和更快的重排序。
### 重要注意事项(请先阅读) {#important-considerations-read-this-first}
DiskANN 在 VectorChord 中目前仍处于**实验阶段**,而且与所有图 ANN 方法一样,它也伴随着一定的权衡:
* **更新与构建速度**:**索引构建和更新的速度明显慢于 vchordrq (IVF+RaBitQ)**。如果你的业务有频繁的插入/删除操作,或者需要快速重建索引,vchordrq 是更好的选择。
* **动态数据性能**:修改图的连通性在计算上比更新 IVF 倒排列表更重;对于频繁变动的数据集,vchordrq 能提供更好的运维体验。
* **运维简洁性**:对于大多数团队而言,vchordrq 通常更容易调优和运维。
> **我们的建议:**对于绝大多数应用场景,请优先使用 **vchordrq (IVF+RaBitQ)**。当你**在相对静态的数据集上追求极致的召回率**、希望**在高召回率下获得更紧凑的长尾延迟**,或者对**索引构建期间的内存可预测性**有硬性要求时,可以考虑尝试 **DiskANN**。你的反馈将帮助我们进一步打磨这一选项,使其达到生产级成熟度。
### **如何快速开始** {#how-to-get-started}
```bash
docker run \
--name vectorchord-demo \
-e POSTGRES_PASSWORD=mysecretpassword \
-p 5432:5432 \
-d tensorchord/vchord-postgres:pg17-v0.5.2
```
```pgsql
-- 1. Enable the VectorChord extension
postgres=# CREATE EXTENSION IF NOT EXISTS vchord CASCADE;
NOTICE: installing required extension "vector"
CREATE EXTENSION
postgres=# \dx
List of installed extensions
Name | Version | Schema | Description
---------+---------+------------+---------------------------------------------------------------------------------------------
plpgsql | 1.0 | pg_catalog | PL/pgSQL procedural language
vchord | 0.5.0 | public | vchord: Vector database plugin for Postgres, written in Rust, specifically designed for LLM
vector | 0.8.0 | public | vector data type and ivfflat and hnsw access methods
(3 rows)
-- 2. Create a table with a vector column
postgres=# CREATE TABLE items (id bigserial PRIMARY KEY, embedding vector(3));
CREATE TABLE
-- 3. Insert some sample data
postgres=# INSERT INTO items (embedding) SELECT ARRAY[random(), random(), random()]::real[] FROM generate_series(1, 1000);
INSERT 0 1000
-- 4. Build the DiskANN graph index using the 'vchordg' method
postgres=# CREATE INDEX ON items USING vchordg (embedding vector_l2_ops);
CREATE INDEX
-- 5. Run an approximate nearest neighbor search!
postgres=# SELECT * FROM items ORDER BY embedding <-> '[3,1,2]' LIMIT 5;
id | embedding
-----+-----------------------------------
370 | [0.9644321,0.7480163,0.95816356]
186 | [0.9583021,0.6364455,0.9882274]
303 | [0.9735422,0.9101731,0.92470014]
793 | [0.93719786,0.8919436,0.9729206]
432 | [0.97542423,0.62692064,0.9525037]
(5 rows)
```
关于配置和使用新图索引的详细说明,请查阅我们的官方文档:[**VectorChord 图索引使用指南**](/zh/docs/usage/graph-index/)
## 主动监控:面向 IVF+RaBitQ 的召回率评估工具 {#proactive-monitoring-recall-measurement-tool-for-ivfrabitq}
向量搜索索引面临的一个潜在挑战是“**数据分布漂移(Data Distribution Drift)**”。随着你持续写入新数据——尤其是当新数据的向量分布与初始数据集存在显著差异时——索引的召回率可能会随时间推移而下降,进而影响查询质量。
过去,量化这种退化非常困难,往往只能依赖直觉或复杂的离线评估来决定何时需要重建索引。
为了让你能够主动、轻松地监控索引的健康状况,0.5 版本引入了一个强大的新函数:`vchordrq_evaluate_query_recall`。
该函数允许你利用一小批具有代表性的查询向量及其真实最近邻(Ground Truth),快速、准确地评估当前 IVF+RaBitQ 索引的实际召回率。
**它能为你带来什么:**
* **量化性能**:将对索引质量的“主观感觉”转化为确凿、可衡量的数字指标。
* **辅助决策**:通过定期运行评估,你可以清晰地看到召回率的变化趋势,并基于数据做出何时重建索引以保持最佳性能的决策。
* **提升服务质量**:确保线上向量搜索服务持续满足质量 SLA,防止因索引静默退化而影响业务。
### 如何使用 {#how-to-use-it}
下面是具体的使用方法:
```pgsql
-- Select ctid from your vector table with the target query vector to evaluate
postgres=# SELECT vchordrq_evaluate_query_recall(query => $$
SELECT ctid FROM items ORDER BY embedding <-> '[3,1,2]' LIMIT 10$$);
vchordrq_evaluate_query_recall
--------------------------------
1
(1 row)
```
关于更多细节与配置说明,请参阅[**评估 IVF+RaBitQ 索引的召回率**](/zh/docs/usage/measure-recall/)。
## 自动记录查询以进行召回率追踪 {#automatically-record-queries-for-recall-tracking}
维护高质量的向量搜索服务不仅在于单次测量召回率,更在于针对**真实线上流量**进行持续测量。从 **v0.5.2** 开始,VectorChord 可以**自动记录(采样)你的生产查询**,让你能够直接使用用户实际搜索的向量来评估召回率。
### 为什么这很重要 {#why-it-matters}
* **免维护的数据收集**:无需编写自定义日志流水线,也无需修改应用代码。
* **具代表性的信号**:在系统生产环境实际面对的数据分布上评估召回率。
* **兼顾隐私与轻量**:你可以完全控制何时启用采样以及收集多少样本。
### 启用查询采样 {#enable-query-sampling}
```sql
-- Turn on sampling and set sensible limits
SET vchordrq.query_sampling_enable = on;
SET vchordrq.query_sampling_max_records = 1000; -- cap the total stored samples
SET vchordrq.query_sampling_rate = 0.01; -- sample every 100 query (adjust as needed)
```
启用后,正常执行你的向量搜索(例如 `SELECT * FROM items ORDER BY embedding <-> '[3,1,2]' LIMIT 10;`)。VectorChord 会自动捕获每条采样查询的核心要素:**模式名(schema)、索引名(index)、表名(table)、列名(column)、操作符(operator)以及向量值(value)**。
### 查看已记录的查询 {#inspect-what-was-recorded}
```sql
SELECT * FROM vchordrq_sampled_queries('items_embedding_idx');
-- schema_name | index_name | table_name | column_name | operator | value
-- ------------+---------------------+------------+-------------+----------+--------------
-- public | items_embedding_idx | items | embedding | <-> | [0.5,0.25,1]
```
### 在已记录的查询上评估召回率 {#evaluate-recall-on-recorded-queries}
```sql
SELECT AVG(recall_value) FROM (
SELECT vchordrq_evaluate_query_recall(
format(
'SELECT ctid FROM %I.%I ORDER BY %I OPERATOR(%s) %L LIMIT 10',
lq.schema_name,
lq.table_name,
lq.column_name,
lq.operator,
lq.value
)
) AS recall_value
FROM vchordrq_sampled_queries('items_embedding_idx') AS lq
) AS eval_results;
```
> **注意:**如果你在主备架构下运行 PostgreSQL **流复制**,采样的查询**不会**通过复制或备份进行同步。每台服务器仅根据其自身处理的流量记录**各自**的查询。
## 总结 {#summary}
VectorChord 0.5 为用户带来了前所未有的灵活性。实验性的 DiskANN 支持为特定工作负载提供了全新的高性能选项,而召回率评估工具则让你能够对现有 IVF 索引的运行健康状况进行细粒度监控。
我们坚信,赋予用户更多选择和更强的控制力是推动 VectorChord 不断演进的核心动力。我们诚挚邀请你试用新版本并分享你的反馈,特别是 DiskANN 在你的真实业务场景中的表现。
* **在 GitHub 上下载 / Star:** https://github.com/tensorchord/VectorChord
* **加入社区:** https://discord.gg/KqswhpVgdU
准备好亲自体验了吗?立即前往我们的 GitHub 仓库下载最新版本,看看 VectorChord 0.5 能为你带来怎样的惊喜!
%[https://github.com/tensorchord/VectorChord/]