# 多租户架构
> 多租户对于 SaaS 应用至关重要,它允许单个实例服务多个用户或群组,同时确保数据隐私与安全。本文概述如何使用 pgvecto.rs 设计并实现一个简单的多租户向量搜索系统。
---
LLMS 索引: [llms.txt](/zh/llms.txt)
---
多租户(Multi-tenancy)对于 SaaS 应用至关重要,它允许单个数据库实例同时服务多个用户或团队,同时确保数据隐私与隔离安全。本文将介绍如何使用 `pgvecto.rs` 设计并实现一个简洁的多租户向量搜索系统。
## 设计数据库表结构 {#designing-the-database-schema}
在多租户系统中,基于用户的隔离能否成功,取决于结构良好的数据库 Schema 设计:
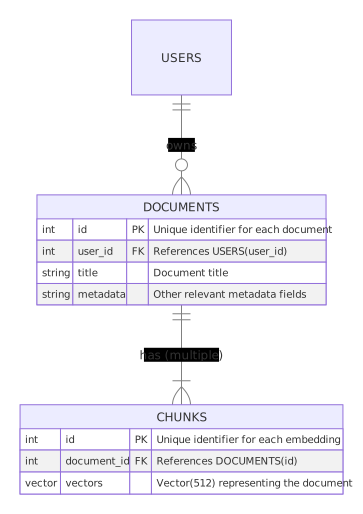
### 用户与文档(Users and Documents) {#users-and-documents}
每个用户由唯一的 `user_id` 标识,该标识直接关联到其拥有的文档以实现私有访问控制。`documents` 表存储每个用户的文档,每篇文档具有唯一的 `id`、`title`(标题)和 `content`(内容)。还可以在 `documents` 表中加入其他元数据字段以增强搜索功能。为了更真实地还原生产场景,我们将 `user_id` 关联在 `documents` 表上,而不是直接冗余在切片嵌入(chunk embeddings)表中。
```sql
CREATE TABLE documents (
id SERIAL PRIMARY KEY,
user_id INTEGER NOT NULL,
title TEXT,
content TEXT,
-- 其他元数据字段
);
```
### 文本切片(Chunks) {#chunks}
`chunks` 表用于存储文档切片的向量化表示(`embedding`),并通过外键 `document_id` 引用其所属的文档。
```sql
CREATE TABLE chunks (
id SERIAL PRIMARY KEY,
document_id INTEGER REFERENCES documents(id),
embedding vector(512) NOT NULL
);
```
### 实体关系图(ER 图) {#entity-relation-diagram}
 ## 实现多租户查询 {#implementing-multi-tenancy}
### 创建索引 {#create-index}
在 `chunks.embedding` 列上创建向量索引以加速查询过程。这里我们使用点积(dot product)作为相似度度量方式:
```sql
CREATE INDEX idx_chunks_embedding ON chunks USING vectors (embedding vector_dot_ops);
```
### 按 `user_id` 执行带过滤的向量查询 {#run-the-query-with-user_id}
```sql
SELECT chunks.id AS chunk_id, documents.id AS document_id, documents.title
FROM chunks
INNER JOIN documents ON chunks.document_id = documents.id
WHERE documents.user_id = 'alice' /* 替换为实际的 user_id */
ORDER BY chunks.embedding <-> '[3,2,1]' /* 替换为查询向量 */ LIMIT 5;
```
在这条查询中:
- `SELECT` 子句包含了 `chunks.id AS chunk_id`、`documents.id AS document_id` 和 `documents.title`,分别返回切片 ID、文档 ID 和文档标题。
- `INNER JOIN` 与 `WHERE` 条件确保只检索属于指定用户(如 `'alice'`)的文档所关联的文本切片。
- `ORDER BY` 子句计算切片嵌入向量与给定查询向量 `'[3,2,1]'` 之间的距离,并按相似度排序,最接近(最相似)的切片会排在最前面返回。
- 在实际使用时,请将 `'[3,2,1]'` 替换为真实的查询嵌入向量,并将 `'alice'` 替换为目标用户的实际 ID。
## 性能优化建议 {#performance-tip}
在带过滤条件的向量搜索过程中,索引会扫描额外的候选点并逐一评估过滤条件。因此,如果系统中的用户 ID 数量非常庞大,或者某个用户的过滤条件命中率极低(数据极其稀疏),查询速度可能会受到影响。为了进一步提升大规模多租户场景下的性能,建议结合使用 PostgreSQL 的表分区(Partitioned Table)功能按租户进行分区。