这是本节的多页打印视图。 .
版本发布说明
- 1: VectorChord 1.1:原生 4/8 比特向量类型与每索引查询默认值
- 2: VectorChord 1.0:Postgres 上开发者优先的向量搜索,索引速度比 pgvector 快 100 倍
- 3: VectorChord 0.5:全新的 RaBitQ 赋能 DiskANN 索引与持续召回率评估
- 4: VectorChord 0.4:凭借高级 I/O 与预过滤实现更快的 PostgreSQL 向量搜索
- 5: VectorChord 0.3:在 PostgreSQL 中实现高效的多向量上下文晚期交互
- 6: VectorChord 0.2:支持 60,000 维向量,ARM 架构下索引速度提升 50%
- 7: pgvecto.rs 0.2:在 PostgreSQL 中统一关系型查询与向量搜索
1 - VectorChord 1.1:原生 4/8 比特向量类型与每索引查询默认值
值此马年新春开启之际,我们非常高兴地宣布发布 VectorChord 1.1。
VectorChord 1.0 是 Postgres 原生向量搜索的一个重要里程碑:它让大规模索引构建变得足够快,感觉就像日常迭代而非停机维护。在 1.1 版本中,我们在此基础上更进一步,推出了 RaBitQ8:这是一种全新的向量类型,相比 float32 可节省 4 倍存储空间并提供更快的搜索速度,同时召回率损失不到 1%。配合 RaBitQ4 以及更具可组合性的查询控制能力,VectorChord 1.1 已准备好应对你最严苛的生产工作负载。
本次发布重点解决我们在社区反馈中观察到的两大痛点:
-
容量瓶颈。当向量索引规模变得极其庞大时,扩展性不仅关乎吞吐量,还直接受限于 SSD 存储占用和缓冲区缓存(Buffer Cache)压力。
-
运维开销。随着索引数量的增长,为每条查询手动设置搜索参数(如
nprobe)会让应用逻辑变得繁琐杂乱。在分区表等场景下,这个问题尤为棘手,因为不同的索引往往需要各自独立的配置。依赖全局会话变量(GUC)使得独立调优这些索引变得不可能。
VectorChord 1.1 同时解决了这两个问题。我们引入了 rabitq8 和 rabitq4 原生量化向量类型,其体积分别仅为标准 float32 的 1/4 和 1/8。这些类型可将总索引大小缩减至原来的 1/4 到 1/7,大幅降低存储开销。同时,我们还新增了每索引查询默认值(Per-Index Query Defaults),让跨多索引查询能够依赖各自独立的配置,而不再受制于脆弱的全局 PostgreSQL GUC。
RaBitQ8 与 RaBitQ4:提升存储效率的低比特向量类型
向量数据占用空间是在 Postgres 上进行大规模搜索的隐形瓶颈。将高维向量存储为标准 float32(每维度 4 字节)会消耗海量的 SSD 空间和内存。随着存储占用的增长,它会加剧缓冲区缓存压力,迫使查询频繁从磁盘读取数据,进而导致 P99 延迟飙升。
VectorChord 1.1 通过引入基于扩展 RaBitQ(论文)构建的两种全新量化数据类型 rabitq8 和 rabitq4 解决了这一问题。通过使用 8 比特和 4 比特表示替代 32 比特浮点数,这两种类型将单向量存储空间分别缩减至 1/4 和 1/8,同时将精度损失控制在极低水平。
使用这些类型的方式与使用 vector 几乎完全相同。唯一的区别是在执行 INSERT 和 SELECT 时,使用 quantize_to_rabitq8 或 quantize_to_rabitq4 对值进行量化。
在包含 1 亿个 768 维向量的 LAION 数据集上,典型的 vector(float32)索引约占 400GB。使用 halfvec(float16)类型可将其缩减至约 171GB。在相同的索引选项下,切换为 rabitq8 可进一步将其缩减至约 95GB,而 rabitq4 则可缩减至约 58GB,相比基线实现了 4 到 7 倍的存储空间缩减。

接下来的问题是召回率与吞吐量的权衡。rabitq8 在大幅缩减索引体积的同时,保持了与基线(float32 向量)基本持平的召回率和 QPS。rabitq4 则是一个更为激进的选项:它以较大的召回率损失换取了极致的最小索引体积,最适合将存储空间作为首要限制因素的部署场景。

每索引查询默认值:可组合的多索引查询
在 VectorChord 中,vchordrq.probes GUC 控制查询时搜索多少向量空间,直接决定了吞吐量与召回率之间的权衡。对于层次化的 vchordrq 索引,vchordrq.probes 的层级长度必须与构建时使用的 build.internal.lists 配置保持一致。典型配置如下表所示:
build.internal.lists |
vchordrq.probes |
|
|---|---|---|
| 无分区 | [] |
'' |
| 1 层分区 | [2000] |
'40' |
| 2 层分区 | [800, 640000] |
'40,200' |
对于单表、单索引上的简单向量搜索,在运行查询前设置一次 GUC 是一个很自然的选择:
然而,当一条查询涉及多个向量索引时,情况就不同了。使用不同 build.internal.lists 配置构建的索引,在逻辑上应当使用不同的 probes 设置。更糟糕的是,当列表层级数量不同时,没有任何一个单一的全局 probes 值能够同时匹配两个索引,导致全局设置天然无法支持此类查询。
为了解决这一问题,VectorChord 1.1 遵循 PostgreSQL 的索引级配置模型,将每索引查询默认值(Per-Index Query Defaults)作为索引选项引入。现在,不必再强迫每条查询共享单一的全局配置,每个索引都可以定义自己的默认值,当未显式设置全局配置时,这些默认值就会自动生效。
你可以在创建索引时设置每索引默认值,也可以随时在线修改它们,而无需重建索引。
除了 vchordrq.probes 之外,其他查询期参数也可以在创建索引时指定每索引默认值,从而让多索引查询能够依赖各自独立的、特定于索引的设置。有关可配置参数的完整列表,请参阅回退参数(Fallback Parameters)。
总结
VectorChord 1.1 让大规模部署的运维变得更加轻松。rabitq8 和 rabitq4 大幅缩减了存储体积,在保持熟悉的 SQL 使用模式的同时,显著降低了存储与内存压力。每索引回退查询默认值则使得在单条语句中执行跨多索引的向量查询成为可能,尤其是当这些索引采用不同选项构建时。
无论你是在真实工作负载中遇到了存储与内存瓶颈,还是正在运行涉及多个向量索引的复杂查询,我们都诚挚邀请你升级到 VectorChord 1.1,在你的业务负载中亲自体验并分享反馈。
-
在 GitHub 上下载 / Star: https://github.com/tensorchord/VectorChord
2 - VectorChord 1.0:Postgres 上开发者优先的向量搜索,索引速度比 pgvector 快 100 倍
两年前,当我们发布第一篇 pgvecto.rs 博客文章时,我们下了一个赌注:Postgres 是进行向量搜索的最佳场所。从那时起,我们一直围绕这个信念持续迭代——从支持过滤向量搜索的 VBASE,到更长维度的向量支持,再到 RaBitQ 量化方案以及对磁盘友好的索引布局。
随着 VectorChord 1.0 的到来,我们再次实现了突破。在一台 16 vCPU 的机器上,我们现在可以在 20 分钟内为 1 亿(100M)个向量构建好索引;而在相同规模下,pgvector 需要超过 50 个小时。这个数字听起来很惊人,但本次发布的目的绝不仅仅是为了在基准测试幻灯片上赢下比赛,而是为了让你的实际开发与迭代周期变得更快。
本文将分为三个部分:
1. 大道至简:打破“HNSW 总是更好”的迷思
当人们第一次和我们聊起 VectorChord 时,最常问的一个问题非常直接:
“你们用的是 HNSW 吗?我听说 HNSW 总是比 IVF 更好。”
在纸面上,HNSW 是一个优美的算法,在许多孤立的基准测试中它确实名列前茅。但我们并不是在真空中运行向量搜索——我们是在 Postgres 内部运行它,必须面对 Postgres 自身的存储模型、VACUUM 机制、MVCC 以及运维习惯。
如果你从这个角度来看,权衡就会发生巨大的变化。
HNSW 在 Postgres 中的现实困境
HNSW 使用分层图结构。每个新向量都是一个节点,可能会跨越多个层级与其它若干个节点建立连接;每次删除操作都可能移除一个被许多其它节点所依赖的节点。
在独立的专用向量引擎中,你可以围绕这种图结构设计整个存储引擎。但在 Postgres 内部,你做不到。你必须在现有的表/索引模型中生存,与 VACUUM 协同工作,并在 MVCC 机制下保持良好表现。
这正是痛点的根源:
-
插入操作极其繁重。向 HNSW 索引中插入单个向量,可能会跨越多个节点和层级触发连锁更新。在高写入负载下,这使得保持稳定的延迟变得十分困难。
-
删除操作暗藏玄机。在实践中,删除操作通常只是将一个节点标记为死亡(dead),但仍将其留在图中,以免立即破坏图的连通性。随着越来越多节点被标记为死亡,搜索过程仍然需要遍历它们;当图中很大一部分节点处于“已死亡但仍存在”的状态时,就会引入额外的查询延迟。
-
VACUUM 付出了真正的代价。你不能简单地直接丢弃那些死亡节点,因为直接移除它们会破坏邻域结构并导致图的部分区域断开连接。为了解决这个问题,pgvector 必须将死亡节点的所有邻居重新插入,以确保在没有该节点的情况下图依然保持连通。这种重新插入的工作正是维护成本高昂的原因;核心问题不仅仅是回收死元组(dead tuples),而是围绕每个被删除的节点重新布线整张图。
这一切并非完全无法实现,但只要你面临频繁的数据更新,它就会把你推向高昂的运维成本。
为什么我们转而选择 IVF + RaBitQ
VectorChord 的核心索引是结合了简单倒排列表(Posting Lists)的 IVF + RaBitQ。向量被路由到粗粒度的聚类簇中,在每个簇内部,我们存储的是极小的量化编码,而不是 768 维的浮点数。在查询时,几乎所有工作都在这些按位打包(bit-packed)的编码上通过查表和廉价的整数运算完成。
由于索引主要扫描压缩编码,即使倒排列表扫描触及大量条目,速度依然极快。在我们的基准测试中,这使 VectorChord 明显快于比较全精度向量的朴素 IVF,并且依然快于需要遍历图并以全精度算术对邻居打分的 pgvector HNSW 索引。
有时人们会问:“那么 HNSW + 量化向量呢?”你确实可以这样做,它也能加速搜索的第一阶段(即遍历量化向量并挑选候选集)。但你仍然需要第二阶段:根据这些候选集获取全精度向量并重新打分,而这一部分并不关心你使用的是哪种索引。在典型工作负载中,第一阶段仅占总延迟的约 40%,因此即使扫描速度提升 2 倍,端到端时间也只能缩短约 20%——更何况 HNSW 无法将数据排列成紧凑、对批处理友好的快速扫描(Fast-Scan)格式,因此就连这点理论收益在实践中也很难真正兑现。
而在 IVF + RaBitQ 中,倒排列表只是压缩条目的数组。插入操作只需追加一个新编码;删除操作只需清除一个编码。没有全局图需要修复,因此频繁更新不会触发连锁反应。在运维层面上,它的表现就像一个普通索引;在我们的测试中,这种设计在保持延迟稳定的同时,能够承受约 10 倍于 pgvector HNSW 索引的更新吞吐量。有关更多性能数据(尤其是查询性能方面的数据),请参阅我们此前的博客文章《PostgreSQL 向量搜索:内存与磁盘方案的对比分析》。
最重要的是,这种简洁性为我们接下来几节中的重大改进奠定了基础。如果你的索引结构本身就已经极其错综复杂,那么每一项额外优化都会增加更多活动部件。通过保持核心设计的简洁,我们为大幅改善索引构建速度和开发者工作流留出了充足的空间。
2. 让索引构建像日常迭代,而不是一次停机事故
让我们聊聊标题中的那个数字:索引速度比 pgvector 快 100 倍。
在 LAION 1 亿(100M)向量数据集上,纸面对比如下:
-
pgvector:在 16 vCPU 上索引构建时间超过 50 小时(如果内存不足还可能失败)。
-
VectorChord 0.1:在 GPU 上进行外部 KMeans 聚类耗时约 2 小时;在 Postgres 中使用 4 vCPU 插入耗时约 20 小时。
-
VectorChord 1.0:KMeans 聚类与插入全部在 Postgres 内部完成,在 16 vCPU 上不到 20 分钟即可全部完成(KMeans 约 8 分钟 + 插入约 12 分钟)。
但对你而言,真正改变的事情其实更加直观:
-
在 pgvector 的世界里,为大型数据集建立索引是一场跨越多日的大工程。你必须围绕它做计划、寸步不离地盯着它,并时刻担心万一中途失败该怎么办。
-
在 VectorChord 1.0 的世界里,全量重建索引更像是**“午饭前启动它,喝杯咖啡回来查看结果”**。
我们通过同时攻克 IVF 构建的两个阶段实现了这一目标:寻找聚类中心的 KMeans 阶段,以及将每个向量分配给最近聚类中心的插入阶段。
为了做到这一点,我们从问题本质入手,而不仅仅是微调代码。首先,我们没有对 1 亿个数据点上的朴素 768 维、160,000 聚类中心 KMeans 进行微观优化,而是利用约翰逊—林登斯特劳斯引理(Johnson–Lindenstrauss Lemma)将向量投影到小得多的低维空间,直接将 KMeans 的计算量和内存占用削减了约 7 倍。其次,我们分两阶段运行层次化 KMeans(Hierarchical KMeans),每次只对较小的数据子集进行聚类,而不是同时处理 160,000 个聚类中心,这在理论上带来了 400 倍的加速。在插入阶段,我们将同样的思路向上复用一层,在聚类中心本身之上再构建一个 IVF 索引,使每个数据向量只需使用量化编码与一小部分候选聚类中心桶进行比较。这些改进共同将大部分工作从受限于 CPU 的距离数学运算中解放出来:在构建 1 亿向量索引时,主要开销变成了 Postgres 以接近 SSD 极限的速度分配和写入索引页。在我们收紧了分配路径和锁粒度、实现以大块(Chunks)方式流式写入页面之后,最终的实际效果就是:全量重建索引可以轻松控制在几分钟之内,而不再需要耗费数天时间。关于更多技术细节,我们专门撰写了一篇博客《我们如何在 PostgreSQL 上实现 20 分钟内完成 1 亿向量索引构建》进行深入解析。
只需以下简单的 SQL 语句,即可轻松启用这些优化:
3. 为开发者打造的特性,而不仅是为了基准测试图表
VectorChord 1.0 还新增了一系列在基准测试中几乎看不出来、但在日常使用系统时至关重要的特性。它们的核心目标是帮助你理解索引的运行状态,并让你能够顺畅无阻地使用现代模型与部署架构。
内置的索引质量监控
所有的近似最近邻(ANN)索引都会随时间推移而发生漂移。数据分布会发生变化,构建之初表现优异的索引可能会在不知不觉中退化。
VectorChord 不会让你盲目猜测,而是可以为你持续测量召回率。它会自动对真实查询向量进行采样,使用更精确的方法重新评估其近邻,并追踪索引返回“正确”答案的频率。
这把一种模糊的感觉——“最近搜索结果好像有点不太准”——转化为了你可以直观查看的图表。如果召回率保持稳定,你就知道可以推迟重建;如果呈下降趋势,你就可以在用户察觉之前提前规划重建。它还为你提供了具体的数据指标,可以接入你现有的可观测性技术栈或导入 Prometheus,让你能够在监控其它 SLO 的同一块仪表盘上随时关注召回率变化。
在实际使用中,你只需一次 SQL 调用即可评估真实查询模式的召回率,并将该数值作为监控指标导出。例如:
长向量支持,无需削足适履限制模型
我们支持最高达 16,000 维的向量。这听起来像是一条枯燥的参数规格,但它有着非常明确的实用价值:你可以直接接入更新的模型(包括长上下文模型或多模态模型),而无需仅仅为了迁就索引就立刻对模型输出进行压缩或截断。
你可以先直接使用模型自然生成的向量表示,直观感受其性能与检索质量,然后再决定是否要应用更激进的量化或降维。索引绝不应该成为迫使你在模型选择上做出妥协的瓶颈。
面向更丰富 RAG 场景的多向量检索
并非每篇文档都适合塞进单个向量里。现代检索增强生成(RAG)系统通常将一段文本表示为一组向量——例如每个词元(Token)一个向量,或每个句子一个向量——然后将这组向量与一组查询向量进行比较。这种“晚期交互(Late Interaction)”风格通常被称为多向量检索。
VectorChord 通过在向量数组上提供 MaxSim 风格的操作符,原生支持这一模式。从概念上讲,对于每个查询向量,你会寻找最匹配的文档向量,计算它们的点积,然后将这些最佳得分相加。在 VectorChord 中,这一功能通过 vector[] 列上的基于距离的 @# 操作符暴露出来:左侧是文档的向量数组,右侧是查询的向量数组。
上手方式与单向量搜索非常相似。你在每行中存储一个向量数组,并构建专用索引:
在查询时,传入查询向量数组并按 @# 得分排序即可:
在底层,VectorChord 会将其 ANN 引擎机制应用于这些向量数组,让你能够在 Postgres 中直接使用纯 SQL 获得多向量模型的强大表达能力,同时享受到与单向量 IVF 索引同等水平的高性能体验。
多平台 SIMD 加速
VectorChord 内置了对 x86_64、ARM 和 IBM 架构的 SIMD 加速支持。在运行时,我们会自动检测当前可用的最佳指令集(在支持的情况下自动启用 AVX512 等指令集)并直接加以利用,无需你手动调整编译标志或维护多份不同的二进制文件。
实验性的 DiskANN + RaBitQ
我们还提供了一种将 DiskANN 与 2 比特 RaBitQ 相结合的实验性索引类型。在某些数据集和召回率目标下,它可以提供比 IVF + RaBitQ 更高的 QPS。其代价则是索引构建和更新速度明显更慢,且更加复杂。
我们不建议将其作为默认选择。它是为那些拥有极其特定的工作负载、完全清楚自己在做什么,并且愿意为了在特定参数区间内换取更高 QPS 而付出更高运维成本的团队准备的。对于其他所有用户,IVF + RaBitQ 依然是推荐的主力方案。
提前终止扫描的相似度过滤
有时你不仅需要最近邻,还需要“找出在此半径范围内的所有结果,最多返回 N 行”。在 SQL 中最自然的写法是在 WHERE 子句中加上距离条件,并配合 ORDER BY 和 LIMIT:
这种写法虽然能返回正确结果,但当落入该半径范围内的数据点寥寥无几时,性能会非常糟糕。Postgres 仍然必须继续扫描索引,直到找齐 10 行或者穷尽整个搜索空间,因为这里的距离检查仅仅是在 ANN 扫描之后才应用的普通过滤器。
VectorChord 新增了一种“相似度过滤(Similarity Filter)”语法,允许将距离阈值直接下推到索引内部。你只需将查询向量和半径包装在 sphere() 值中,并使用 <<->> 操作符,索引就知道一旦搜索区域超出该球体范围即可立即停止扫描:
预过滤与后过滤,让查询贴合你的数据模型
在真实应用中,向量搜索几乎从不孤立存在。你通常会按租户、权限、时间范围或内容类型进行过滤,然后再按向量相似度排序,有时顺序则反过来。
VectorChord 允许你在索引级别自由选择预过滤(Prefiltering)和后过滤(Postfiltering)。在低选择性(匹配结果较少)场景下,预过滤可以大幅缩减候选集,带来最高约 5 倍的 QPS 提升;而在其它情况下,你可能希望先进行向量搜索,再仅对排名前列的结果进行过滤,以获得更好的召回率。关键在于,你可以在 Postgres 中自然地表达这两种模式。
在当前会话中启用预过滤只需一条 SQL 语句:
基于 VectorChord-BM25 的文本搜索
最后,我们新增了 VectorChord-BM25 扩展,将强大的全文搜索能力直接引入你的 Postgres 实例。它支持多语言和高级分词(Tokenization),旨在为众多工作负载提供堪比 ElasticSearch 级别的相关性排序能力。
我们的初衷并不是要取代所有的专用搜索引擎,而是让你能够构建将 BM25 与向量搜索并肩部署在同一个数据库中、并复用同一套运维工具的系统。对许多团队而言,仅此一项就能免去大量的部署与维护负担。
在实际使用中,你可以通过纯 SQL 直接调用它,将其与向量嵌入结合,并按统一得分进行排序。例如:
结语
人们很容易将 VectorChord 1.0 简单概括为“在 1 亿向量上索引速度比 pgvector 快 100 倍”。这个标题确实不假,但它并不是全部的故事。
我们的目标是让 VectorChord 成为在 Postgres 上进行检索的最佳方式之一——无论是从最初的原型验证,还是扩展到十亿级规模的数据集。如果你已经在使用 pgvector,我们非常欢迎你在真实业务负载上试用 VectorChord 1.0,并告诉我们它在哪些地方帮到了你、在哪些地方还可以做得更好。最后,我们也要向 EnterpriseDB 团队在整个研发过程中提供的宝贵反馈致以诚挚的谢意。
3 - VectorChord 0.5:全新的 RaBitQ 赋能 DiskANN 索引与持续召回率评估
我们非常激动地宣布发布 VectorChord 0.5!此次发布标志着我们在提供更灵活、更强大、更可控的向量搜索能力这一使命上迈出了重要一步。在 0.5 版本中,我们引入了两项重大更新:对 DiskANN 图索引的实验性支持,以及全新的用于主动监控 IVF+RaBitQ 索引健康状况的召回率评估工具。
全新索引预览:RaBitQ 赋能的 DiskANN 索引
从第一天起,VectorChord 的核心索引方案就建立在一个强大的组合之上:基于聚类的 IVF 算法与 RaBitQ 量化——也就是我们提供的 vchordrq (IVF+RaBitQ)。这一方案在广泛的应用场景中始终保持着出色的低延迟与高召回率表现,并且仍然是我们在绝大多数场景下的默认推荐方案。
与此同时,我们也认识到,在某些特定数据集以及特定(通常是更高)的召回率目标下,基于图的索引(Graph-Based Indexes)能够展现出比 IVF+RaBitQ 更优的性能。为了让你在面对不同任务时都能拥有最趁手的工具——也因为我们的目标是成为向量搜索的一站式解决方案——VectorChord 0.5 引入了对 DiskANN 算法的实验性支持作为额外选项。
什么是 DiskANN?它为何重要?
传统的顶尖图算法(如 HNSW 和 NSG)通过将整张图保存在内存中来实现高速检索,但这推高了硬件成本,并限制了单节点的可扩展规模。SSD 虽然价格低廉,但过去其随机 I/O 特性使得磁盘图索引难以在不付出高昂延迟代价的情况下投入实用。
DiskANN 的使命正是打破这一内存壁垒。它是一种从零开始设计的图近似最近邻(ANN)算法,旨在使用廉价的 SSD 存储和搜索十亿级规模的数据集,同时保持极具竞争力的召回率和低延迟。
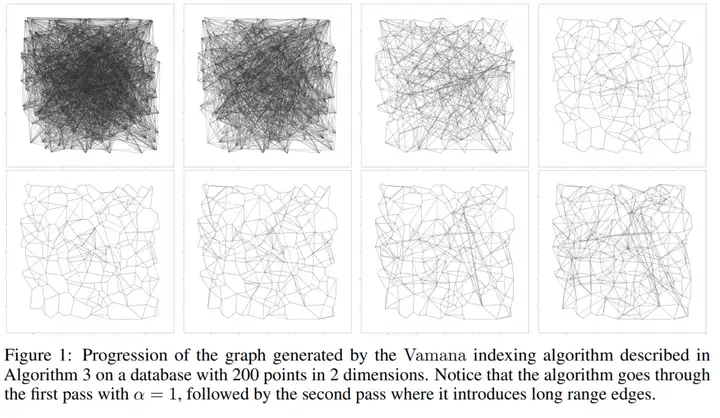
来自 DiskANN 原论文的可视化示意图。
我们的变体有何不同
我们实现了原始 DiskANN 设计的一个变体:我们没有采用原论文默认的乘积量化(Product Quantization, PQ),而是使用 RaBitQ 作为量化层。RaBitQ 精度更高且具备理论误差界保证,这帮助我们实现了比原版实现中使用的普通 PQ 更优的召回率—延迟权衡。在实际应用中,这一改进使我们能够在相同的存储占用下获得更高的精度,或者在相同的召回率下实现更快的查询。
在 VectorChord 0.5 中,我们将 DiskANN 集成到了现有生态系统中,方便你将其与 vchordrq 进行并排对比评估。
DiskANN 大放异彩的场景
-
取决于工作负载与目标的收益:对于某些模型家族(例如 OpenAI/Cohere 风格的嵌入)以及高召回率设置,在相同硬件上,DiskANN 可以提供比 IVF+RaBitQ 更低的延迟和/或更高的召回率。
-
稳定且可预测的构建内存:它避免了 IVF 的 KMeans 聚类阶段,减少了索引构建期间的内存波动,简化了容量规划。
-
生态系统兼容性:依然可以使用 VBase 进行元数据过滤,并利用 RaBitQ 量化实现更小的存储占用和更快的重排序。
重要注意事项(请先阅读)
DiskANN 在 VectorChord 中目前仍处于实验阶段,而且与所有图 ANN 方法一样,它也伴随着一定的权衡:
-
更新与构建速度:索引构建和更新的速度明显慢于 vchordrq (IVF+RaBitQ)。如果你的业务有频繁的插入/删除操作,或者需要快速重建索引,vchordrq 是更好的选择。
-
动态数据性能:修改图的连通性在计算上比更新 IVF 倒排列表更重;对于频繁变动的数据集,vchordrq 能提供更好的运维体验。
-
运维简洁性:对于大多数团队而言,vchordrq 通常更容易调优和运维。
我们的建议:对于绝大多数应用场景,请优先使用 vchordrq (IVF+RaBitQ)。当你在相对静态的数据集上追求极致的召回率、希望在高召回率下获得更紧凑的长尾延迟,或者对索引构建期间的内存可预测性有硬性要求时,可以考虑尝试 DiskANN。你的反馈将帮助我们进一步打磨这一选项,使其达到生产级成熟度。
如何快速开始
关于配置和使用新图索引的详细说明,请查阅我们的官方文档:VectorChord 图索引使用指南
主动监控:面向 IVF+RaBitQ 的召回率评估工具
向量搜索索引面临的一个潜在挑战是“数据分布漂移(Data Distribution Drift)”。随着你持续写入新数据——尤其是当新数据的向量分布与初始数据集存在显著差异时——索引的召回率可能会随时间推移而下降,进而影响查询质量。
过去,量化这种退化非常困难,往往只能依赖直觉或复杂的离线评估来决定何时需要重建索引。
为了让你能够主动、轻松地监控索引的健康状况,0.5 版本引入了一个强大的新函数:vchordrq_evaluate_query_recall。
该函数允许你利用一小批具有代表性的查询向量及其真实最近邻(Ground Truth),快速、准确地评估当前 IVF+RaBitQ 索引的实际召回率。
它能为你带来什么:
-
量化性能:将对索引质量的“主观感觉”转化为确凿、可衡量的数字指标。
-
辅助决策:通过定期运行评估,你可以清晰地看到召回率的变化趋势,并基于数据做出何时重建索引以保持最佳性能的决策。
-
提升服务质量:确保线上向量搜索服务持续满足质量 SLA,防止因索引静默退化而影响业务。
如何使用
下面是具体的使用方法:
关于更多细节与配置说明,请参阅评估 IVF+RaBitQ 索引的召回率。
自动记录查询以进行召回率追踪
维护高质量的向量搜索服务不仅在于单次测量召回率,更在于针对真实线上流量进行持续测量。从 v0.5.2 开始,VectorChord 可以自动记录(采样)你的生产查询,让你能够直接使用用户实际搜索的向量来评估召回率。
为什么这很重要
-
免维护的数据收集:无需编写自定义日志流水线,也无需修改应用代码。
-
具代表性的信号:在系统生产环境实际面对的数据分布上评估召回率。
-
兼顾隐私与轻量:你可以完全控制何时启用采样以及收集多少样本。
启用查询采样
启用后,正常执行你的向量搜索(例如 SELECT * FROM items ORDER BY embedding <-> '[3,1,2]' LIMIT 10;)。VectorChord 会自动捕获每条采样查询的核心要素:模式名(schema)、索引名(index)、表名(table)、列名(column)、操作符(operator)以及向量值(value)。
查看已记录的查询
在已记录的查询上评估召回率
注意:如果你在主备架构下运行 PostgreSQL 流复制,采样的查询不会通过复制或备份进行同步。每台服务器仅根据其自身处理的流量记录各自的查询。
总结
VectorChord 0.5 为用户带来了前所未有的灵活性。实验性的 DiskANN 支持为特定工作负载提供了全新的高性能选项,而召回率评估工具则让你能够对现有 IVF 索引的运行健康状况进行细粒度监控。
我们坚信,赋予用户更多选择和更强的控制力是推动 VectorChord 不断演进的核心动力。我们诚挚邀请你试用新版本并分享你的反馈,特别是 DiskANN 在你的真实业务场景中的表现。
-
在 GitHub 上下载 / Star: https://github.com/tensorchord/VectorChord
准备好亲自体验了吗?立即前往我们的 GitHub 仓库下载最新版本,看看 VectorChord 0.5 能为你带来怎样的惊喜!
%[https://github.com/tensorchord/VectorChord/]
4 - VectorChord 0.4:凭借高级 I/O 与预过滤实现更快的 PostgreSQL 向量搜索
我们很高兴地宣布发布 VectorChord 0.4,这是一次全面增强 PostgreSQL 高性能向量搜索能力的重要更新。我们相信,此次发布进一步拓展了 PostgreSQL 向量搜索的能力边界,引入了多项关键架构改进,旨在为严苛的真实业务负载降低延迟并提升吞吐量。
如果你正在 PostgreSQL 上构建相似度搜索、RAG 流水线或其他 AI 驱动的应用,这些更新正是为你量身打造的。我们重点聚焦于两大领域:利用 PostgreSQL 不断演进的底层能力大幅提升冷查询(Cold Query)的 I/O 效率,以及深度优化带过滤条件的向量搜索。
🚀 重大改进 1:面向磁盘索引的高级 I/O(冷查询延迟降低 2 到 3 倍!)

VectorChord 自早期版本起就支持基于磁盘的索引(Disk-Based Indexing)。但此前的一大挑战在于 I/O 效率:受限于 PostgreSQL 较旧的内部缓冲区操作 API,全精度向量只能逐个读取。
VectorChord 0.4 通过重写页面布局并采用现代流式 I/O(Streaming I/O)技术解决了这一问题。我们很自豪地成为首批(甚至可能是第一个)采用这些全新流式 I/O API 的 PostgreSQL 扩展。这使我们能够将 I/O 与计算进行流水线化并行处理,并更高效地发起磁盘 I/O 操作。作为这项工作的一部分,我们还向 pgrx 框架贡献了初步的 PostgreSQL 18 支持,以便针对这些即将到来的异步 I/O(AIO)能力进行测试和开发,从而惠及更广泛的 PostgreSQL 社区。
我们的实现方案会自动适配你的 PostgreSQL 版本:
-
在 PostgreSQL 17(及设置
io_method=sync的更新版本)上:利用madvise进行预取。当 VectorChord 调用 PostgreSQL 的新流式 I/O API 时,PostgreSQL 在 PG17(或设置io_method=sync的 PG18)上的底层实现会在内部使用madvise(MADV_WILLNEED)。这会向操作系统内核提示即将发生的数据读取需求,使磁盘数据提前被读取并缓存到内存的页缓存(Page Cache)中。当实际发生 I/O 时,PostgreSQL 可以直接从页缓存读取,而无需等待磁盘 I/O。 -
为异步 I/O 做好准备:PostgreSQL 18 与
io_uring。展望配备基于io_uring的真正异步 I/O(AIO)的 PostgreSQL 18,VectorChord 0.4 在架构设计上已做好集成准备。这将允许数据以极低的开销和极高的效率直接预取到 PostgreSQL 的共享缓冲区(Shared Buffers)中。 -
在较早的 PostgreSQL 版本(PG17 之前)上:用于预取的兼容流式 I/O 接口。对于使用旧版本 PostgreSQL 的用户,我们在 VectorChord 内部实现了一套类似的流式 I/O 接口以保持向后兼容。虽然它不依赖内核级 AIO 或最新的 PostgreSQL 内部 API,但该接口同样能够实现高效的缓冲区预取。这意味着使用早期 PostgreSQL 版本的用户在读取全精度向量时,也能受益于改进的 I/O 模式和更低的延迟。
高级 I/O 对磁盘索引的影响:在我们的基准测试中,这些 I/O 增强使冷查询的延迟降低了 2 到 3 倍。这直接改善了长尾延迟(Tail Latency),尤其是在查询需要使用驻留在磁盘上的向量进行重排序时效果更为显著。

🎯 重大改进 2:通过预过滤加速带条件搜索(最高提速 3 倍!)

向量搜索通常需要与元数据过滤结合使用。如何高效处理这一场景一直是我们关注的重点。我们是最早在 pgvecto.rs 中通过引入 VBASE 风格过滤来解决 PostgreSQL 向量过滤难题的团队之一,当时的表现在 pgvector 的基础上实现了大幅提升。
现在,在 VectorChord 0.4 中,我们通过引入强大的预过滤(Prefiltering)支持,将性能推向了新的高度。
-
后过滤(Post-filtering,此前的方法):先找出 Top-K 个向量,再进行过滤。当过滤条件选择性较高(即匹配行较少)时效率低下。
-
预过滤(Pre-filtering,0.4 新增):基于比特向量扫描结果,首先识别出满足元数据过滤条件的行,然后仅在这个较小的候选集上执行向量距离计算。
现在,我们利用高效的机制配合量化比特向量扫描,在执行向量距离计算之前先识别出匹配的行。由于过滤检查的开销远小于距离计算,这带来了显著的速度提升。用户可以通过 SET vchordrq.prefilter=ON 启用此功能。
**实际效果:**我们的基准测试表明,在适用预过滤的场景下,相比我们已经高度优化的 VBASE 后过滤方法,搜索性能最高可提升 3 倍。这为复杂查询带来了可观的优势。

✨ 其他值得关注的改进:
-
优化残差量化(QPS 提升约 20%):感谢 Jianyang(RaBitQ 作者),我们改进了残差量化(Residual Quantization)。通过将
<o, q-c>重构为<o, q> - <o, c>,查询向量q只需量化一次,从而带来了约 20% 的 QPS 提升。我们现在推荐用户在 L2 距离场景下启用残差量化。 -
优化旋转矩阵并简化配置:同样感谢 Jianyang,全新的快速哈达玛变换(Fast Hadamard Transform)优化了旋转矩阵,并移除了
prewarm_dimGUC 参数,在简化配置的同时略微加快了处理速度。 -
全面重写文档:我们全面重写了官方文档,现在提供更详尽的用户指南和 API 参考,帮助你充分发挥 VectorChord 的潜力。欢迎访问 https://vchord.pgsty.com/zh/docs/。
立即体验 VectorChord 0.4!
我们相信此次发布将显著增强 PostgreSQL 中的向量搜索能力。
-
在 GitHub 上下载 / Star: https://github.com/tensorchord/VectorChord
-
加入社区: https://discord.gg/KqswhpVgdU 我们欢迎你试用 VectorChord 0.4,在你的实际工作负载下进行基准测试,并分享你的宝贵反馈。
祝你向量搜索愉快!
5 - VectorChord 0.3:在 PostgreSQL 中实现高效的多向量上下文晚期交互
我们非常激动地宣布发布 VectorChord 0.3!这一重要里程碑直接在你的 Postgres 数据库内部显著提升了高级向量搜索技术的性能与适用性。在带来 ARM 支持与更快索引构建的 0.2 版本基础上,0.3 版本攻克了现代检索领域的最大难关之一:具备晚期交互(Late Interaction)能力的高效多向量搜索。
超越单向量:为什么多向量如此强大
多年来,向量搜索主要将整篇文档或整个查询表示为单个稠密向量(Dense Vector)。这种方法虽然强大,但需要将复杂的信息平均或压缩为单一表示,不可避免地会导致细节语义的丢失。试想一下,如果用一句话概括一篇详尽技术文档的全部含义,你必然会丢失大量细节!
为此,以 ColBERT 等模型为代表的**多向量表示(Multi-Vector Representations)与晚期交互(Late Interaction)**应运而生。这些模型不再为每个条目生成单个向量,而是生成多个向量——通常每个词元(Token,即单词或子词)对应一个向量。真正的魅力体现在搜索过程中:
-
查询编码(Query Encoding):你的搜索查询同样被拆分为多个词元向量(记为 q1, q2, …, qN)。
-
文档编码(Document Encoding):同样地,文档也由其词元向量(d1, d2, … dM)表示。
-
晚期交互与 MaxSim 聚合(Late Interaction & MaxSim Aggregation):我们不再只做一次整体比较,而是执行细粒度匹配。其核心思想是最大相似度(MaxSim)运算。对于每一个查询词元向量(如 q_i),我们在文档的所有词元向量(d1 到 dM)中找出与之具有最高相似度(例如余弦相似度或点积)的文档词元向量(d_j)。对每个查询词元(q1, q2, …, qN)重复这一过程后,将每个查询词元所获得的最大相似度值相加,即可计算出该文档的最终相关性得分。这一运算天然是非对称的,重点衡量查询中的各个部分在文档某处得到体现的程度。
为什么这种方式更好?
-
保留上下文细节:基于 MaxSim 的晚期交互使模型能够捕捉细粒度的语义关系。它能够识别查询中的特定重要词汇是否与文档的特定部分强烈匹配,而不是依赖可能被稀释的整体平均相似度。
-
显著提升相关性:通过考虑聚焦于词元级别的交互并汇总每个查询词的最佳匹配,ColBERT 等模型实现了最先进的检索质量。这种细粒度方法对于包含多个词汇、内容丰富的查询尤为强大,能够更准确地理解用户意图。在 BEIR 基准测试中,这转化为显著的性能提升:基于相同的 ModernBert 模型,ColBERT 变体取得了 51.6 的 NDCG@10 得分,而稠密单向量变体仅为 41.6。
我们之前的博客文章曾探讨过使用 ColBERT 进行重排序(Reranking),展示了它的强大实力:
在 PostgreSQL 中利用 ColBERT Rerank 为向量搜索加速
VectorChord 0.3:受 WARP 启发,将高效 MaxSim 引入 Postgres
VectorChord 0.3 直面晚期交互高昂的计算成本。受突破性的 WARP 引擎(论文:WARP: An Efficient Engine for Multi-Vector Retrieval,代码:jlscheerer/xtr-warp)启发,我们在核心 Rust 引擎中集成了高度优化的多向量晚期交互 MaxSim 操作符与索引。
WARP 方法的精妙之处在于一个根本性的洞察:复杂的多向量 MaxSim 计算(将 N 个查询向量与 M 个文档向量进行比较)可以巧妙地分解为多个独立的单向量搜索过程。WARP 不再进行庞大的 N × M 全量比较,而是针对每个查询词元向量,在已建立索引的文档向量上分别执行 N 次独立搜索,以找出各自的最佳匹配。

VectorChord 0.3 中 MaxSim 扫描器的核心改进正是建立在这一理念之上。我们通过复用并编排 VectorChord 现有的、高度优化的单向量搜索基础设施来实现 MaxSim。当使用索引执行 MaxSim 查询时,VectorChord 会利用底层索引结构(IVF 结合 RaBitQ)执行多次单向量搜索——每个查询向量对应一次。随后,它会根据 MaxSim 求和规则高效地聚合结果。对于缺失值的估计,我们采用了 WARP 的方法,利用到聚类中心(Centroid)的距离以及累积簇大小来估计潜在候选文档的 MaxSim 得分。

复用经过优化的单向量搜索组件,确保了 MaxSim 能够直接受益于现有的性能调优与稳定性。对于用户而言,更重要的是它提供了无缝的使用体验:你可以对单向量搜索和多向量 MaxSim 搜索使用相同且熟悉的索引类型(带 RaBitQ 的 IVF),而无需维护独立的系统。VectorChord 0.3 自豪地成为首个提供这种高效分解式 MaxSim 实现的 Postgres 扩展,让最先进的多向量检索直接在你的数据库中变得实用且高效。
解锁强大的应用场景
这一全新效率为前沿技术的实际落地打开了大门:
-
高性能 ColBERT 重排序:对更快的初筛检索(如传统单向量搜索或关键词搜索)召回的候选集应用 ColBERT 卓越的相关性排序,而不会产生高昂的延迟代价,兼得速度与质量。
-
免 OCR 文档搜索(ColPali/ColQwen):试想一下,直接在扫描文档、PDF 或图像中进行搜索,而无需经过独立且容易出错的 OCR(光学字符识别)步骤。ColPali 或 ColQwen 等模型可以直接从图像块(Image Patches)生成词元嵌入。借助 VectorChord 0.3 的高效 MaxSim,你现在可以直接在 Postgres 中对这些视觉词元嵌入执行晚期交互搜索,从而对以往纯文本方法无法处理的文档实现强大的检索能力。
敬请期待!我们即将发布另一篇深度文章,详细介绍 VectorChord 0.3 如何赋能革命性的免 OCR RAG 流水线。
性能亮点
我们在 FiQA(金融观点挖掘与问答)数据集上对 VectorChord 0.3 的全新多向量 MaxSim 能力进行了测试。该标准基准测试集包含 57,000 篇文档,累计约 1,500 万个词元。
基于 VectorChord 优化引擎驱动的 ColBERTv2 初步基准测试结果展现了令人瞩目的性能:
-
相关性:我们达到了 34.1 的 NDCG@10 得分,优于原始 WARP 论文在同一数据集上报告的 33.6 NDCG@10。
-
速度:查询执行极为高效,平均每次查询仅需 35 毫秒。
虽然这些只是我们在持续优化过程中基于单个数据集得出的初步结果,但它们充分证明了 VectorChord 0.3 的潜力。用户现在可以直接在 Postgres 数据库内部,以接近简单单向量方法的低延迟,享受多向量搜索与晚期交互带来的高级相关性检索能力。
快速上手 VectorChord 0.3
前提条件:
- 安装了 VectorChord v0.3 的 PostgreSQL 服务器
你可以使用我们的 VectorChord-Suite 镜像:
步骤 1:创建多向量数据表
首先,定义一张表来存储数据。关键区别在于对向量列使用数组类型(vector[]),以便在每行中保存多个向量。
步骤 2:插入多向量数据
向表中插入数据。vecs 列接收包含 vector 类型的 PostgreSQL 数组。
步骤 3:创建支持 MaxSim 的 vchordrq 索引
为了加速 MaxSim 搜索,使用 vchordrq 方法创建索引,并指定 vector_maxsim_ops 操作符类。这里的一个关键参数是 build.internal.lists。
- 计算
n:估算整个数据集中所有独立向量的总数。
- 设置
lists:build.internal.lists的推荐范围为
在此范围内选择一个值(通常 2 的幂次方效果较好)。
步骤 4:配置搜索参数(可选但推荐)
在查询之前,你可以调整运行时参数以平衡性能与精度:
-
vchordrq.probes:控制搜索期间检查多少个索引列表(聚类簇)。较高的值会提高精度(召回率),但会减慢搜索速度。对于查找前 10 个结果(LIMIT 10),常用的起始值为 32。 -
vchordrq.maxsim_refine:限制对每个候选查询词元向量使用原始精度重新计算的向量对数量(其余情况将使用比特距离)。它与probes相关,通常设为探测向量数量的 20% 即可。
步骤 5:执行 MaxSim 相似度搜索
现在你可以使用 @# MaxSim 操作符进行查询了。将你的查询向量作为 vector 类型的 PostgreSQL 数组传入:
恭喜!你已经成功建表、建立多向量 MaxSim 搜索索引,并使用 VectorChord 0.3 的 MaxSim 操作符执行了第一条查询!你可以尝试调整 probes 和 max_maxsim_tuples 参数,为你的具体业务场景找到速度与精度的最佳平衡点。
%[https://github.com/tensorchord/VectorChord/]
6 - VectorChord 0.2:支持 60,000 维向量,ARM 架构下索引速度提升 50%
今天,我们非常激动地向大家分享 VectorChord 0.2——这是一个凝聚了社区反馈、旨在应对 PostgreSQL 向量搜索不断演进的挑战而打造的新版本。
%[https://github.com/tensorchord/VectorChord/]
优化存储布局:支持高达 60,000 维向量
在 PostgreSQL 中,基础存储单元是 8KB 的数据页(Page)。虽然这种设计对于大多数常规负载非常稳健,但它也给高维向量搜索等现代应用场景带来了限制。例如,受限于固定的页面大小,pgvector 每个向量的维度硬性上限为 2000 维,因为更大的向量无法在单个页面内建立索引。
为了解决这一问题,我们在 VectorChord 中重构了向量存储架构。通过重新设计向量的内部存储布局,我们实现了对存储分配的精细控制,允许向量在需要时跨越多个页面存储。现在,我们可以支持最高达 60,000 维的向量。
| 系统 | 向量维度上限 |
|---|---|
| VectorChord 0.2 | 60000 |
| VectorChord 0.1 | 1600 |
| pgvector | 2000 |
这种跨页能力不仅打破了 2000 维的壁垒(现已在 v0.2 中支持),还优化了存储效率。举例来说,一个 1200 维的向量(约占 4.8KB)在传统 PostgreSQL 存储方式下会浪费近一半的页面空间,因为每个 8KB 页面只能容纳一个这样的向量,导致存储利用率仅为约 58.5%(1200 维 × 4 字节 ÷ 8192 字节)。通过跨越页面边界紧密打包向量,VectorChord 最大限度地减少了未使用的空间,显著提高了存储密度。

虽然这只是向前迈出的一小步,但我们对它为可扩展向量负载所解锁的无限可能感到兴奋。
Float16 与 ARM 架构优化
在 0.2 版本中,我们很高兴地引入了 Float16 支持,让用户能够灵活地在存储效率与召回精度之间取得平衡。选择 Float16 可以将向量存储需求减少 50%,仅需在召回性能上做出微小的权衡。需要说明的是,该优化仅适用于原始向量——量化后的向量仍然需要每维度 1 比特来忠实表示原始数据。此次更新让用户能够根据自身对精度和存储的具体需求做出合理选择。
我们还优先针对 ARM 架构进行了性能改进。通过使用 ARM 的**可扩展向量扩展(SVE)**指令集重写距离计算和快速扫描(Fast Scan)逻辑,VectorChord 现在能够在基于 ARM 的系统上提供出色的优化性能。这一增强确保了使用 AWS 最新 i8g 实例(搭载 Graviton4 处理器)等平台的用户,能够在与旧款 i4i 实例相同的成本下获得更高的吞吐量。虽然这些优化是渐进式的,但我们很高兴能帮助各团队在现代云环境中高效地实现扩展。

如结果所示,运行在 i8g.xlarge(ARM64)上的 VectorChord 与价格相近的 i4i.xlarge 相比,吞吐量提升了约 30%。另一方面,价格高出 50% 的 i7ie.xlarge 相比 i8g 仅提供了约 15% 的性能提升——远不足以证明其高昂价格的合理性。此外,基于 ARM 的 i8g 上的索引构建时间也快得多,这是一个令人惊喜且深受欢迎的优势。
我们的基准测试为注重成本的用户揭示了一些重要洞察:在 AWS 的 i8g.xlarge(ARM64)上运行 VectorChord,与价格相仿的 i4i.xlarge 相比可实现约 30% 的吞吐量提升,充分展示了现代 ARM 架构如何在不增加成本的情况下带来可观的性能收益。相比之下,售价比 i8g 高 50% 的 i7ie.xlarge 仅带来 15% 的性能提升——对于追求成本效益的团队而言,这种权衡显然不够划算。
同样令我们感到惊喜的是,基于 ARM 的 i8g 实例在索引构建速度上也有显著提升。虽然这并非我们此次优化的首要目标,但它凸显了 ARM64 和 SVE 在向量工作负载领域的广阔潜力。当然,我们也深知这些结果只是庞大生态系统中的一部分,并期待与社区携手进一步完善这些基准测试。
归根结底,我们的目标是赋能用户做出数据驱动的决策。i8g 出色的性价比以及令人惊喜的索引构建速度优势,使其成为在生产环境中扩展向量搜索的极具吸引力的选择。这一切都离不开我们所依托的卓越开源生态系统。感谢社区一直以来的支持与反馈,我们将继续针对真实业务负载不断打磨 VectorChord。
快速开始
你可以使用 Docker 体验 VectorChord 0.2:
所有的查询语法均与 VectorChord 0.1 保持一致!
总结
VectorChord 0.2 在前代版本的基础上更进一步,实现了索引体积缩小 30%、索引构建速度提升 50%。Float16 支持将原始向量存储空间减半,而 60,000 维向量支持和 ARM64 优化等新特性则带来了更加流畅的 PostgreSQL 向量检索体验。这些更新共同帮助用户在不牺牲性能的前提下实现高效扩展。
我们热忱欢迎社区探索 VectorChord 0.2!无论你是使用 Float16 优化存储、扩展高维工作负载,还是利用 ARM 的高性价比优势,我们都将全力支持你的探索之旅。你的反馈将决定我们的下一步方向——让我们一起构建更智能的向量搜索。🚀
如果你想更进一步,欢迎体验 VectorChord Cloud,我们提供省心的托管服务和免费试用,助你快速启动项目。无论你是优化存储、扩展复杂负载,还是发挥 ARM 的高能效优势,我们的云平台都能为你托管底层基础设施,让你专注于业务创新。
7 - pgvecto.rs 0.2:在 PostgreSQL 中统一关系型查询与向量搜索
我们很高兴地宣布发布 pgvecto.rs 0.2,这是弥合 PostgreSQL 中关系型查询与向量搜索之间鸿沟的重要里程碑。此次更新将两者的强大能力融为一体,不仅提升了执行效率,还支持在 PostgreSQL 内部直接运行复杂的混合查询。
过去,开发者和数据科学家不得不面对分别管理关系型查询系统和向量搜索系统的严峻挑战,这带来了额外的系统复杂度与资源开销。而在 pgvecto.rs 0.2 中,我们通过集成来自 OSDI 2023 的前沿 VBASE 方法解决了这一难题,大幅提升了 PostgreSQL 内部向量搜索的效率。


真实世界应用:Immich
真实世界的应用往往需要超越简单近似最近邻(ANN)搜索的复杂查询。为了探讨这类应用的实际案例,我们来看看 immich——这是一款自托管的照片与视频备份解决方案,充分体现了高级向量查询与传统关系型查询相结合的重要性。

immich 利用高级的向量查询与关系型查询提供智能搜索功能。借助 immich,你可以根据视觉相似度、元数据和用户自定义标签高效地搜索并发现相关媒体文件,而支撑这一功能的底层技术正是 pgvecto.rs。
下面我们简要介绍 immich 中的搜索功能。假设数据库包含三张表:
其中,AssetEntity 表存储图像的基本信息,包括唯一标识符(id)、所有者(ownerId)、创建和更新时间戳(createdAt 和 updatedAt)以及其他相关属性。
ExifInfo 表包含图像特有的 EXIF 数据信息,例如纬度(lat)、经度(long)、城市、州/省、国家和描述。该表中的 assetId 列与 asset_entity 表建立关联。
此外,ImageEmbedding 表存储每张图像的向量嵌入(Embedding)。embedding 列是表示图像嵌入向量的浮点数数组,该表中的 assetId 列同样与 asset_entity 表建立关联。
下面的查询语句用于根据特定条件搜索图像,并按图像嵌入的相似度进行排序。它将 AssetEntity、ImageEmbedding 和 ExifInfo 三张表进行连接(Join),根据 ownerId、isArchived、isVisible、createdAt 以及 EXIF 信息中的 city 等条件过滤结果,最后按给定嵌入向量的相似度对图像排序,并根据指定的限制返回一定数量的结果。
这可以看作是一个典型的**单向量 TopK + 过滤(Filter)+ 连接(Join)**操作场景。pgvector 在支持此类操作时的局限性,凸显了引入 VBASE 的必要性。
在单向量 TopK 操作方面,pgvector 难以提供理想的性能。TopK 查询需要找到与目标向量最接近的 K 个近邻,但 pgvector 很难预测最优的 K 值,从而导致查询性能不佳。相比之下,VBASE 利用松弛单调性(relaxed monotonicity)克服了这一限制,带来了显著更高的效率,为单向量 TopK 查询提供了更准确、更高效的解决方案。
此外,pgvector 对向量查询结合 Filter 和 Join 操作的支持也十分有限。涉及在标量和向量数据上同时进行过滤或连接的复杂查询,在 pgvector 中很难高效执行。而 VBASE 专为无缝处理这类查询而设计:它将向量搜索系统与关系型数据库深度集成,支持在标量和向量属性上高效执行包含过滤与连接的复杂查询。这一能力使 VBASE 成为需要此类操作的应用的理想选择。
基准测试
为了评估性能,我们可以通过基准测试来衡量两套系统的效率与效果。由于目前缺乏全面的关系型向量基准测试集,我们采用衍生自 LAION 2B 图像集的 laion-768-5m-ip-probability 数据集进行测试。该数据集包含 5,000,000 个向量和 10,000 条查询。
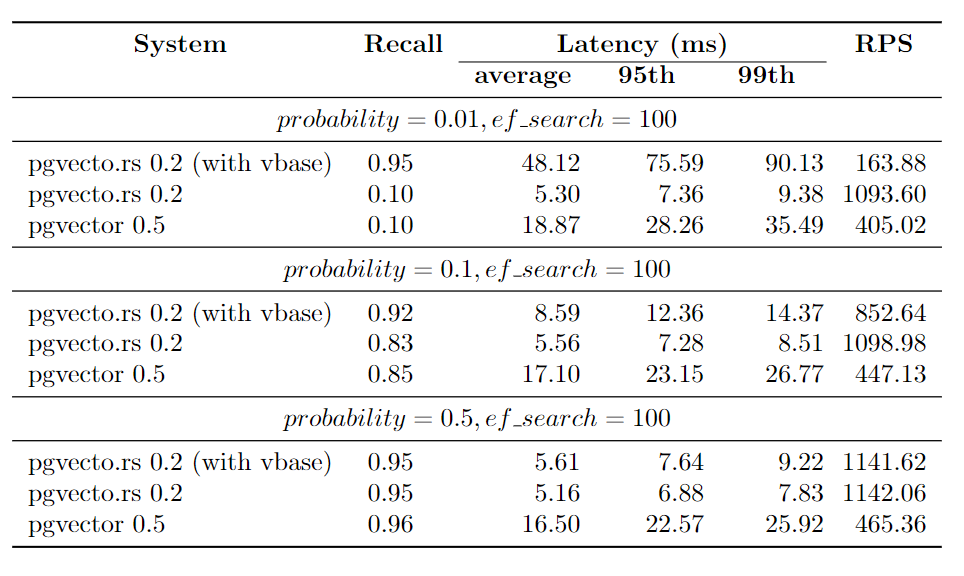
该数据集包含一个 probability 列,存储由 0 到 1 之间的均匀分布生成的随机浮点值。0.01 的比例意味着每次查询覆盖数据集的 1%(即 0.01 倍),便于进行针对性分析。
我们在保持 ef_search 不变的情况下,展示了不同 probability 范围下的召回率(Recall)、延迟(以毫秒为单位)和 RPS(每秒请求数)。ef_search 参数表示 k-NN(k 最近邻)搜索期间使用的候选列表大小,决定了搜索精度与查询处理时间之间的权衡。
结合 VBASE 使用时,pgvecto.rs 始终能够获得更高的召回率,尤其是在处理低过滤率(低 probability 值)查询时表现尤为突出。
其他特性
除了集成 VBASE 之外,pgvecto.rs 0.2 还引入了以下核心特性与改进:
-
FP16 支持:用户现在可以使用 float32 一半的存储空间在 PostgreSQL 中保存向量嵌入,从而显著降低延迟。该优化对最终召回率的影响微乎其微,损失不到 1%。
-
异步索引构建:插入操作现在是非阻塞的,确保数据插入和索引构建过程更加平滑高效。
-
查询性能翻倍:pgvecto.rs 0.2 的查询性能是上一版本(0.1)的两倍,标志着系统效率的重大飞跃。
-
可观测性:全新的
pg_vector_index_stat视图为 pgvecto.rs 的索引内部状态提供了透明的可视化窗口。用户可以实时监控索引构建进度、配置调整以及详细的统计分析,从而获得更加直观、可控的运维体验。
快速开始
要开始体验 pgvecto.rs 0.2,你可以在 Docker 容器中直接运行它:
更多详情请查阅我们的文档。我们欢迎你试用 pgvecto.rs,在你的实际业务负载下进行基准测试,并贡献你的索引创新。欢迎加入我们的 Discord 社区,与致力于改进 pgvecto.rs 的开发者及广大用户交流互动!