PostgreSQL 向量搜索:内存与磁盘方案对比分析
引言:真实场景中的挑战
并非所有场景都需要专用的向量数据库。借助 pgvector、pgvectorscale、VectorChord(演进自 pgvecto.rs)等 PostgreSQL 扩展,您可以在无需额外基础设施的情况下同时获得向量搜索与关系型数据库的能力。但实际落地并非总是顺风顺水,以下是真实用户的反馈:
首次查询耗时 30 秒,而重复查询只需 100 毫秒。问题出在极其缓慢的 I/O 上。
为 1,200 万行 75 维向量构建索引需要 3 个小时,这正常吗?
在为 2 亿条 75 维向量构建索引 13 个小时后,我注意到进度到 30% 时内存占用高达 100GB/124GB,最终服务器直接崩溃了。
我们遇到了一些挑战,特别是频繁的索引更新需求、吞吐量瓶颈、缺乏并行索引扫描以及没有内置量化支持。
在本文中,我们将深入探讨这些问题,帮助您不仅了解这些工具“是什么”,更理解其背后的“为什么”,从而做出明智的决策。让我们一起探索如何应对这些复杂挑战,并挑选最适合您需求的解决方案。
我们在向量数据库中最看重什么?
在 PostgreSQL 中,
shared_buffers是一个关键的内存区域,充当数据页(包括表数据和索引)的主缓存。通过将频繁访问的向量索引块存储在该内存缓冲区中,PostgreSQL 可以大幅减少缓慢的磁盘 I/O。当查询需要数据时,PostgreSQL 首先检查shared_buffers。如果数据已在其中,即可直接快速读取而无需访问磁盘;如果不在,则从磁盘读取数据并加载到shared_buffers中以供后续查询使用。要配置此参数,可在 psql 中执行ALTER SYSTEM SET shared_buffers = 'xGB'并重启服务器。
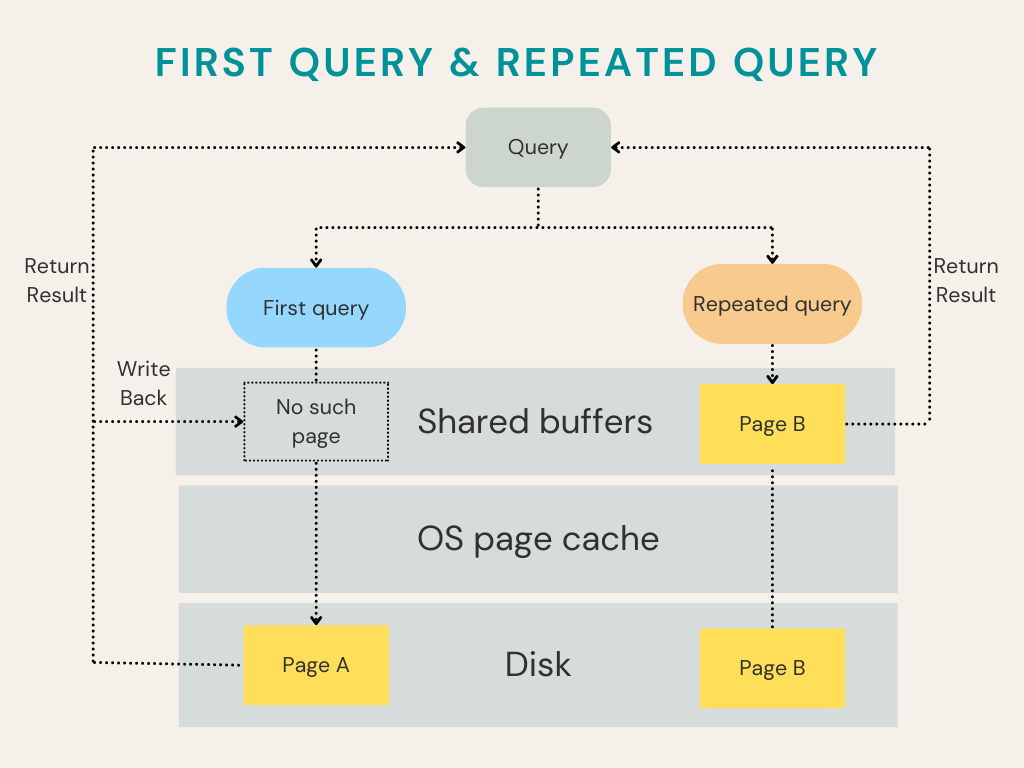
假设您的表中已经存储了一些向量,索引构建完成后,就可以开始执行查询了。即便您已经为 PostgreSQL 配置了足够大的 shared_buffers,在执行首次查询(first query)时,系统仍然需要从磁盘读取索引。然而,对于重复查询(repeated query),由于向量可以直接从 shared_buffers 中获取,查询速度会快得多。
虽然冷启动或索引变更后的首次查询表现很重要,但系统的持续性能往往取决于索引中“热点”或频繁访问的部分被缓存到内存(shared_buffers)之后的查询执行速度——这正是重复查询所模拟的场景。因此,针对缓存命中的性能进行优化,对于许多真实生产应用而言至关重要。
在本文中,我们将对比各向量相似度搜索扩展在以下两种场景下的性能表现:
-
内存充足时的查询性能
-
内存受限且磁盘成为瓶颈时的查询性能
我们还将探讨与索引构建相关的其他维度,例如:
-
索引构建速度(Index build speed):构建索引需要多长时间?如果实例拥有多个 CPU 核心,能否充分利用多核来加速构建? -
内存占用(Memory usage):创建索引需要预留多少内存?这是选择云实例规格时最重要的考量因素。 -
磁盘占用(Disk usage):给定磁盘空间可以容纳多少向量?在选择配备不可扩展本地 NVMe SSD(一种高性能固态硬盘)的实例时,这也是一个重要考量。 -
易用性(Ease of use):能否使用一条简单的CREATE INDEX命令创建索引?针对查询性能进行调优有多难?
最后,我们将讨论索引构建完成后的插入性能(insertion performance)。如果用户的业务包含流式数据并会触发频繁的索引更新,这一指标就显得尤为关键。
实验环境设置
下表展示了后续所有实验所使用的硬件配置与数据集信息:
| 内存中的向量 | 磁盘上的向量 | 索引构建 | 插入性能 | |
|---|---|---|---|---|
| 实例类型 | I4I Extra Large |
C6ID Large |
I4I Extra Large |
I4I Extra Large |
| vCPU 数量 | 4 | 2 | 4 | 4 |
| 存储 | 937 GB NVMe SSD | 118 GB NVMe SSD | 937 GB NVMe SSD | 937 GB NVMe SSD |
| 内存 | 32.0 GiB | 4.0 GiB | 32.0 GiB | 32.0 GiB |
| PostgreSQL shared_buffers | 24.0 GiB | 2.0 GiB | 1.0 GiB | 24.0 GiB |
| 插入行数 | 5,000,000 | 5,000,000 | 5,000,000 | 索引创建后插入 100k 行 |
| 距离度量 | L2 距离 | L2 距离 | / | / |
| 测试查询数 | 10,000 | 10,000 | / | / |
下表列出了我们在实验中使用的各个扩展的版本信息:
| 版本 | 镜像 | |
|---|---|---|
| VectorChord | v0.2.2 | tensorchord/vchord-postgres:pg17-v0.2.2 |
| pgvector | v0.8.0 | tensorchord/vchord-postgres:pg17-v0.2.2 (已安装 pgvector v0.8.0) |
| pgvectorscale | v0.6.0 | timescale/timescaledb-ha:pg17.4-ts2.18.2-oss |
内存中的向量:面向小规模数据
对于向量搜索系统而言,如果追求最佳性能,确保整个索引缓存在 shared_buffers 中至关重要,这通常更适合运行在内存优化型实例上。在这种情况下,shared_buffers 的大小理想情况下应当足以容纳整个索引。
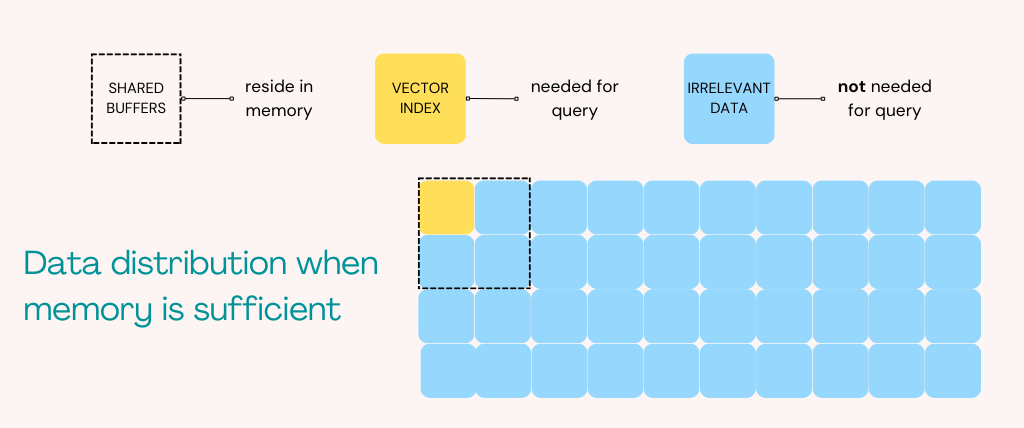
在本次实验中,我们选择了一个中等规模的数据集 LAION-5m,其中包含 500 万条 768 维向量。为了将 LAION-5m 容纳在 shared_buffers 中,我们选用了配备 937GB NVMe SSD 和 32GB 内存的 AWS I4I Extra Large 实例。
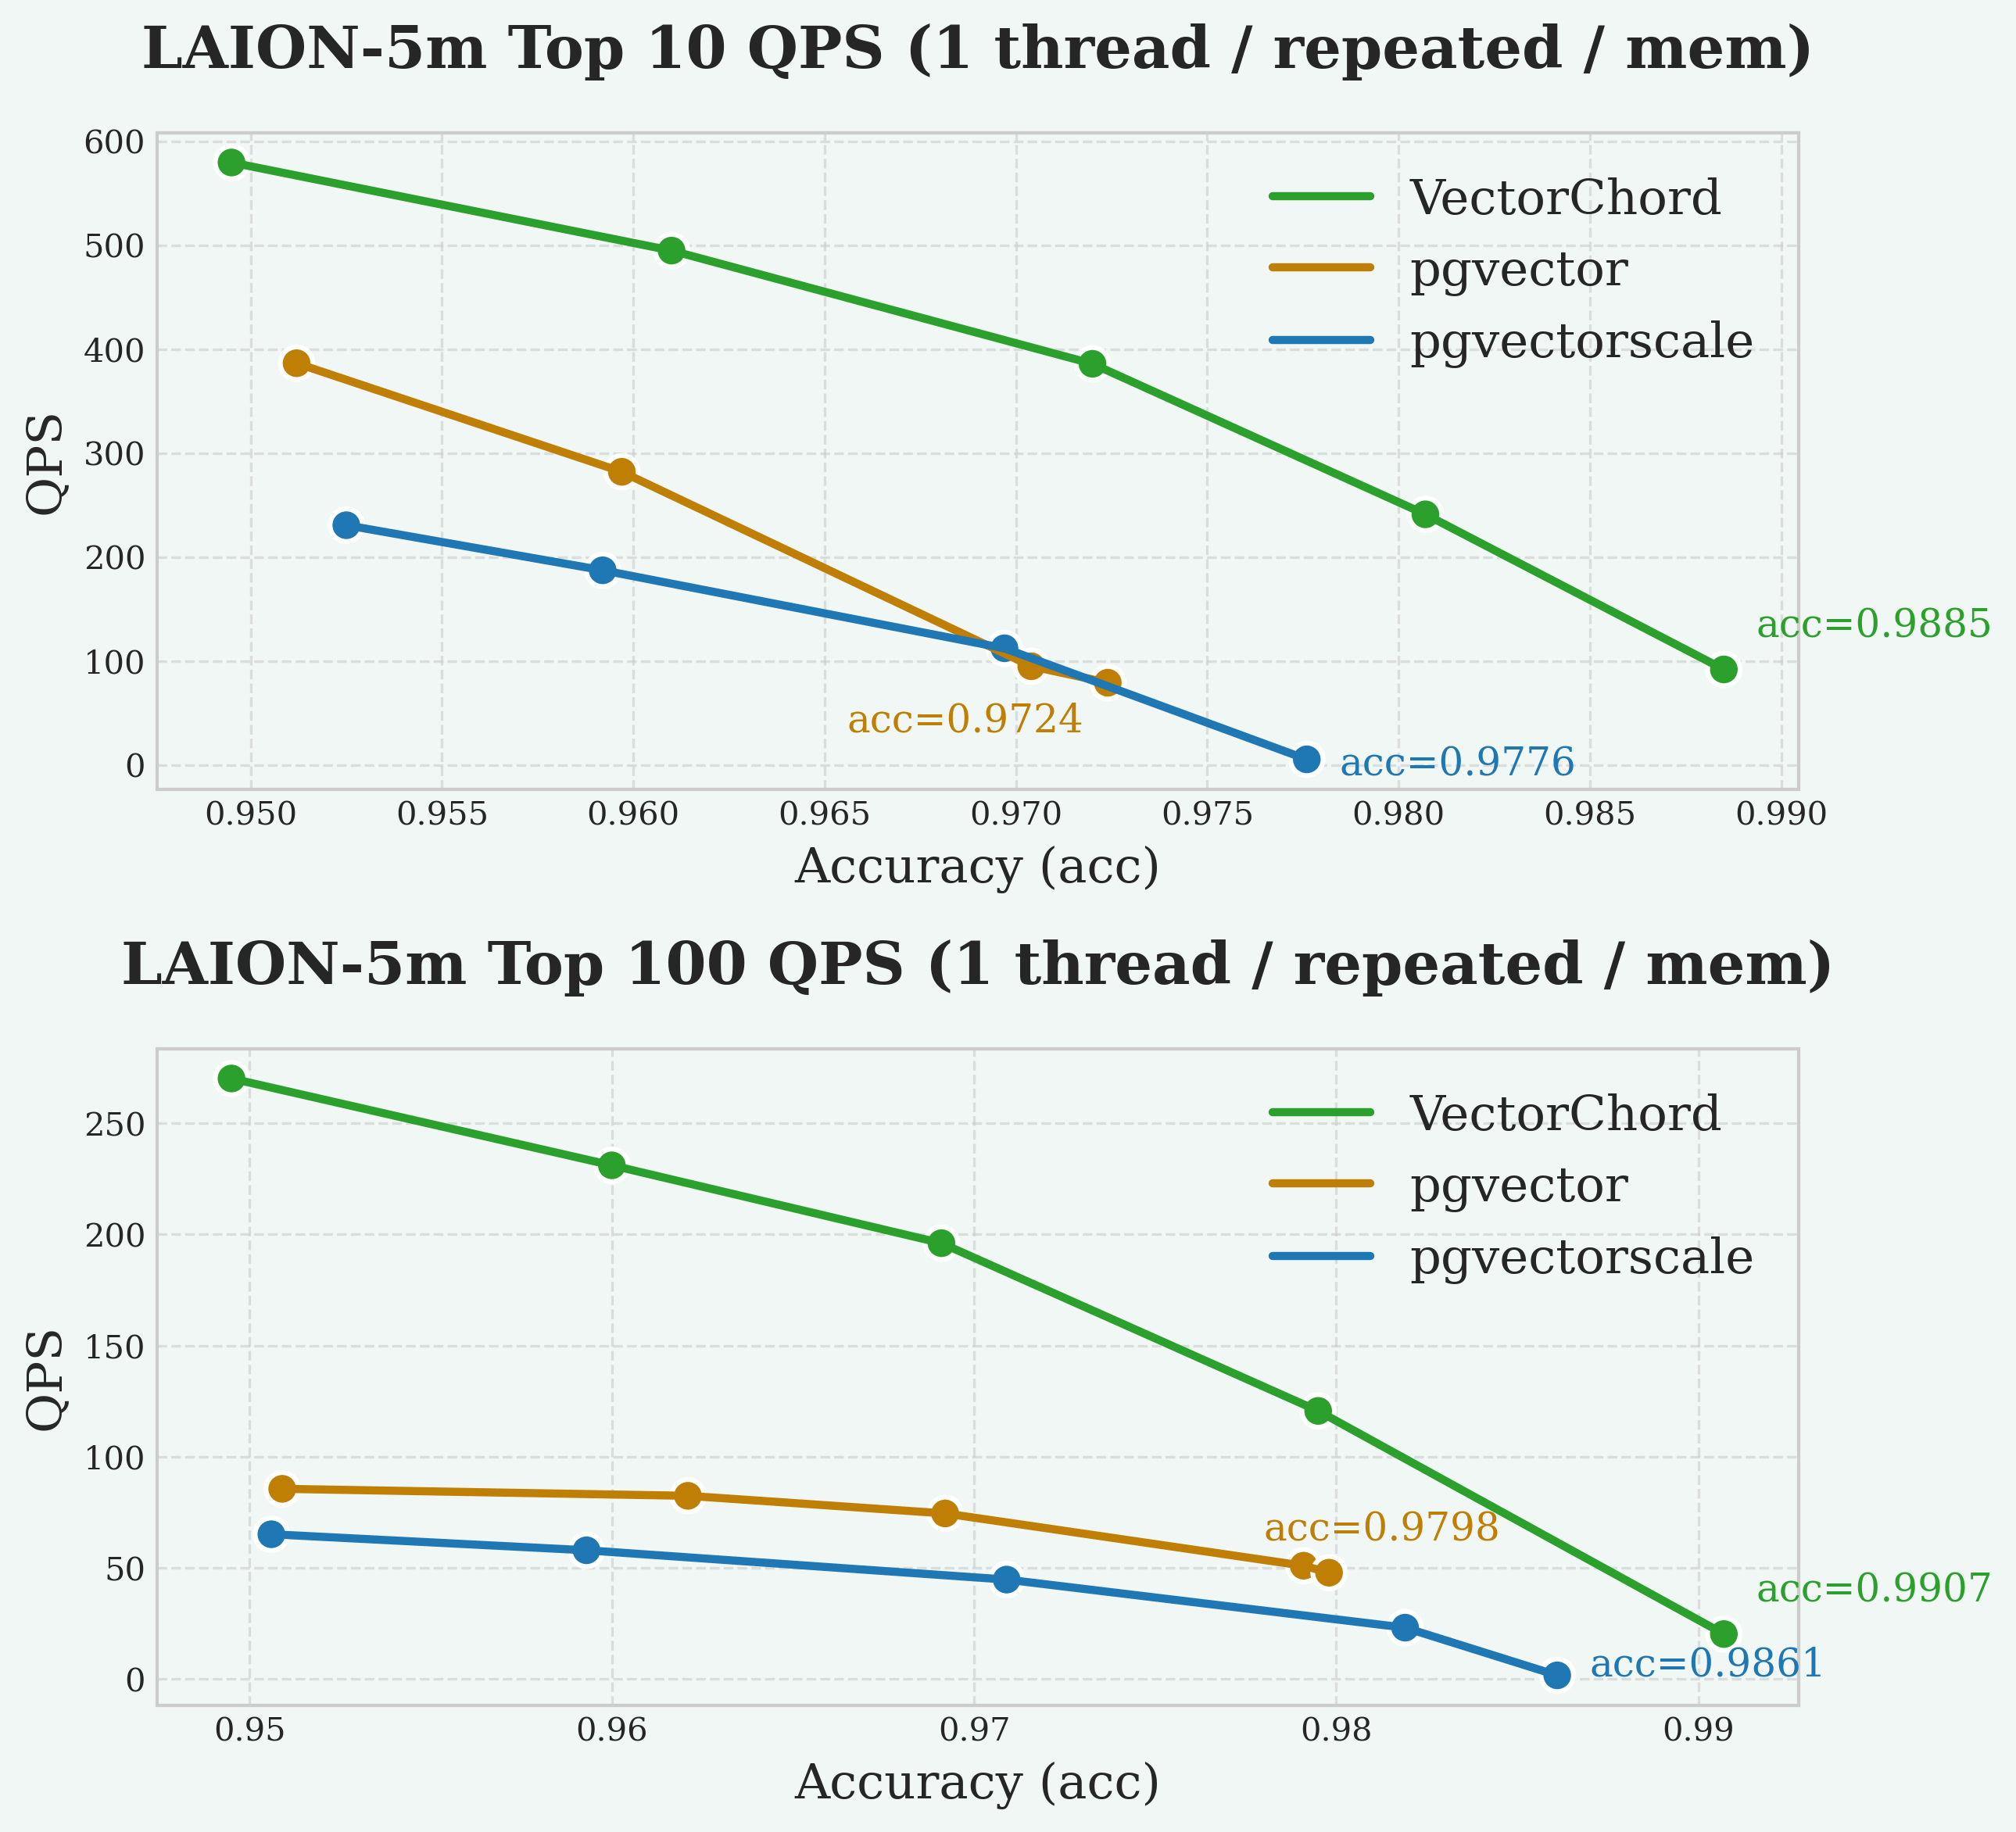
在这台机器上,我们将 shared_buffers 设置为 24GB,先后测量首次查询和重复查询的性能。以下是 pgvector、pgvectorscale 和 VectorChord 在重复查询下的性能对比结果。
下图展示了查询速度(QPS)与搜索质量(Recall@10/100)之间的权衡关系。Recall@10 衡量在返回的前 10 个结果中找到真实最近邻的比例。通常来说,可以通过牺牲一定的召回率来换取更高的 QPS,反之亦然。更优秀的系统能够在相同 QPS 下实现更高的召回率,或者在相同召回率水平下提供更高的 QPS。我们的目标通常是在保持高召回率目标(例如 95%)的前提下最大化 QPS。
为什么 VectorChord 如此之快?
VectorChord 的 RabitQ 索引通过优化的向量压缩技术实现了极速查询,从而大幅加快了距离计算。这种压缩技术最大限度地减少了数据移动,实现了高效的硬件利用率和卓越的查询性能。
为了测量首次查询性能,我们在顺序执行 10,000 条测试查询之前清空了 shared_buffers。尽管缓冲区初始为空,但在同一次测试运行中,前序查询加载到缓存中的索引/数据页有时会被后续查询复用,这会导致瞬时 QPS 在运行过程中逐步上升。因此,我们报告全部 10,000 条查询的平均 QPS,以此作为冷缓存下性能的代表性指标。
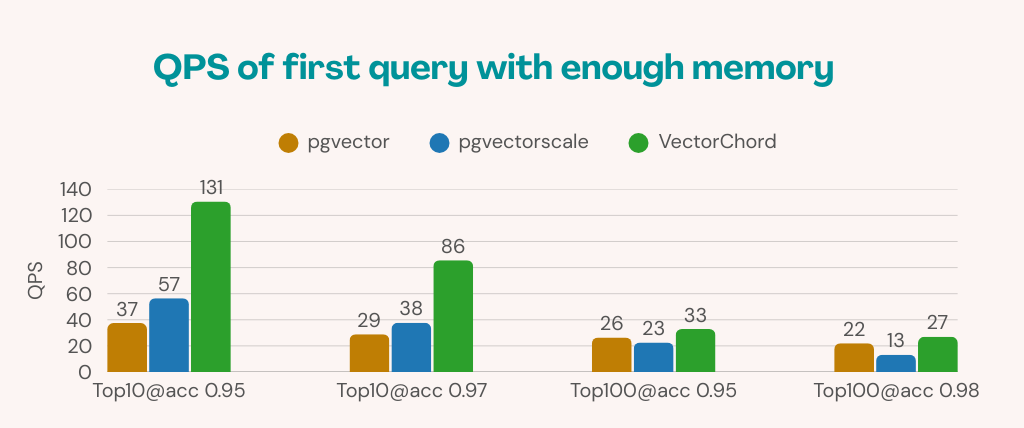
总而言之,与其他扩展相比,VectorChord 在高召回率水平(例如 >95% Recall@10)下始终能实现更高的 QPS。至于另外两款扩展,pgvectorscale 在首次查询时表现更好,但一旦数据被缓存到内存中,pgvector 的表现则会反超。
磁盘中的向量:面向大规模数据
但在某些场景下情况会截然不同。面对数十亿规模的向量,单台机器的内存根本无法容纳整个索引。当待读取向量的体积超过内存大小时,shared_buffers 的加速效果会大幅减弱,绝大部分数据都必须从磁盘读取。
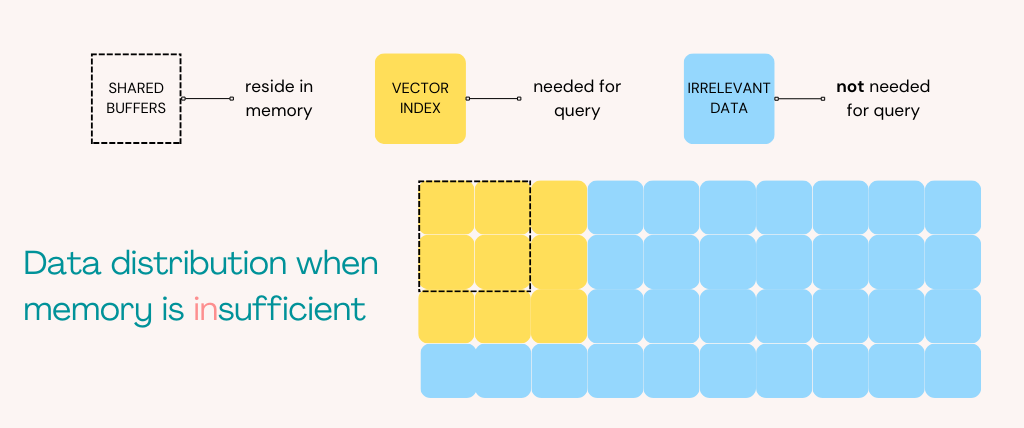
虽然此时 shared_buffers 的作用下降,但操作系统的页缓存(page cache)仍能提供一定的缓存加速,不过其性能通常低于 shared_buffers。
索引构建与数据迁移
VectorChord 的内部构建(internal build) 和 pgvectorscale 在构建索引时需要额外的内存,因此无法在仅有 4GB 内存的小型实例上直接构建索引。为了解决这一问题,我们先在另一台配备 24GB 内存的 I4I Extra Large 实例上完成索引构建,随后通过 AWS S3 对所有扩展的数据库数据目录进行备份和恢复。
为了模拟这种场景,我们将 LAION-5m 部署在一台配置小得多的 C6ID Large 机器上(仅配备 4GB 内存,并将 shared_buffers 设为 2GB)。这一配置确保内存处于不足状态,迫使绝大多数查询访问磁盘。
在这种情况下,由于内存不足,首次查询与重复查询之间的性能差异会小得多。因此,仅评估各扩展的重复查询性能即可反映真实水平。
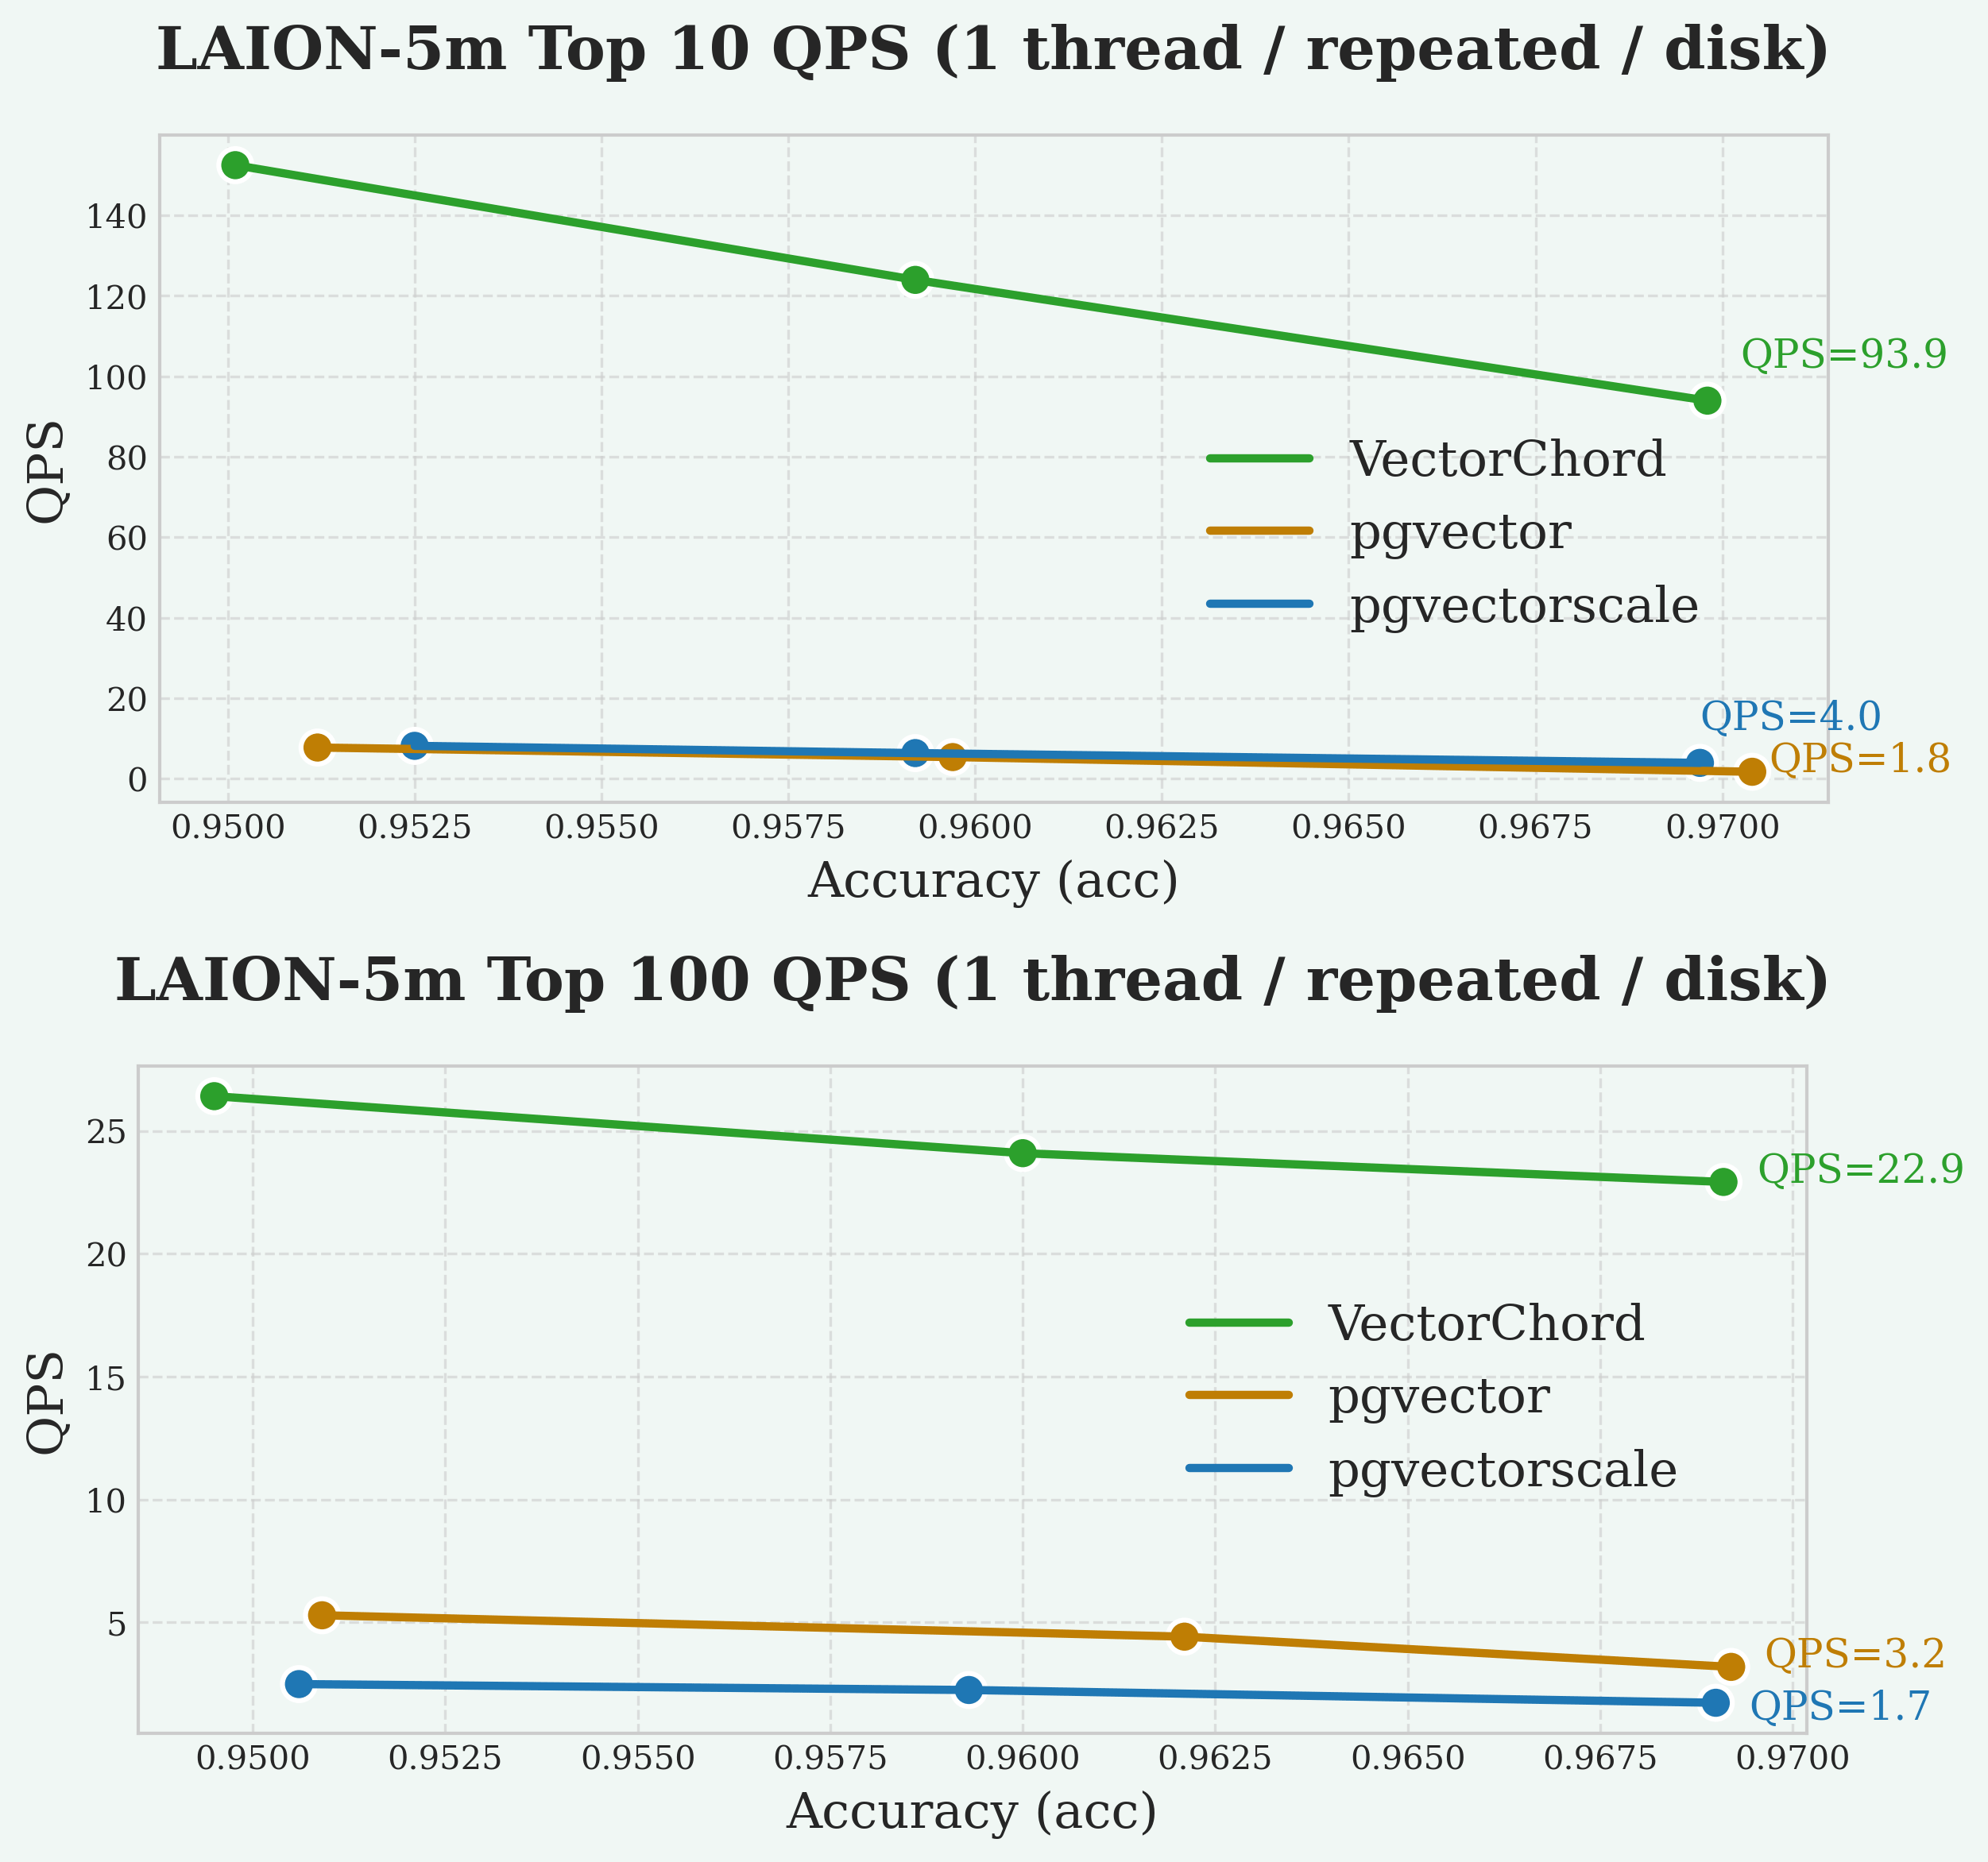
一如既往,在高召回率水平(例如 >95% Recall@10)下,VectorChord 依然取得了远高于其他扩展的 QPS,而 pgvector 和 pgvectorscale 的 QPS 则较为接近。
索引构建体验
正如前文所述,用户同样十分关注索引构建阶段的各项指标:索引构建耗时、内存占用、磁盘占用以及易用性。我们在上述 LAION-5m 数据集实验的 CREATE INDEX 阶段测量了这些指标:
-
CPU 核心利用率(Core utilization):索引创建期间有效利用的可用 CPU 核心百分比。数值越高表明并行度越好。 -
索引构建耗时(Index build time):SQL 命令构建索引所花费的时间。如果索引构建需要额外步骤(如VectorChord 外部构建),该步骤耗时也计入其中。 -
内存占用(Memory usage):索引构建期间的峰值内存使用量,包含分配给 PostgreSQL 的 1GBshared_buffers。 -
磁盘占用(Disk usage):索引构建完成后磁盘上PGDATA的总大小(包含向量表数据和索引)。
VectorChord 中的外部构建与内部构建对比
VectorChord 支持两种不同的索引构建方式:内部构建(internal build)和外部构建(external build)。内部构建的使用体验与 pgvector 和 pgvectorscale 类似,而外部构建则需要額外执行一步 k-means 聚类。外部构建通常能带来更优异的查询性能,也是为大规模向量构建索引的推荐方式。如果您想深入了解 VectorChord 的外部构建,请阅读我们之前的博客文章。
前文所有查询性能均是在使用配备 A10 GPU 的独立机器完成外部构建后测得的。如果您坚持使用同一台 I4I Extra Large 实例进行外部构建,索引构建耗时将增加至 50 分钟,但这依然极具竞争力。
在本测试中,我们将 shared_buffers 设置为 1GB,并记录了各扩展的峰值内存占用。VectorChord 的内部构建与外部构建均将 K-means 聚类迭代次数设置为 25 次(25 iters)。在易用性方面,pgvector、pgvectorscale 和 VectorChord 的内部构建语法相似,只需一条 SQL 语句即可完成索引构建;而 VectorChord 的外部构建则相对复杂一些。
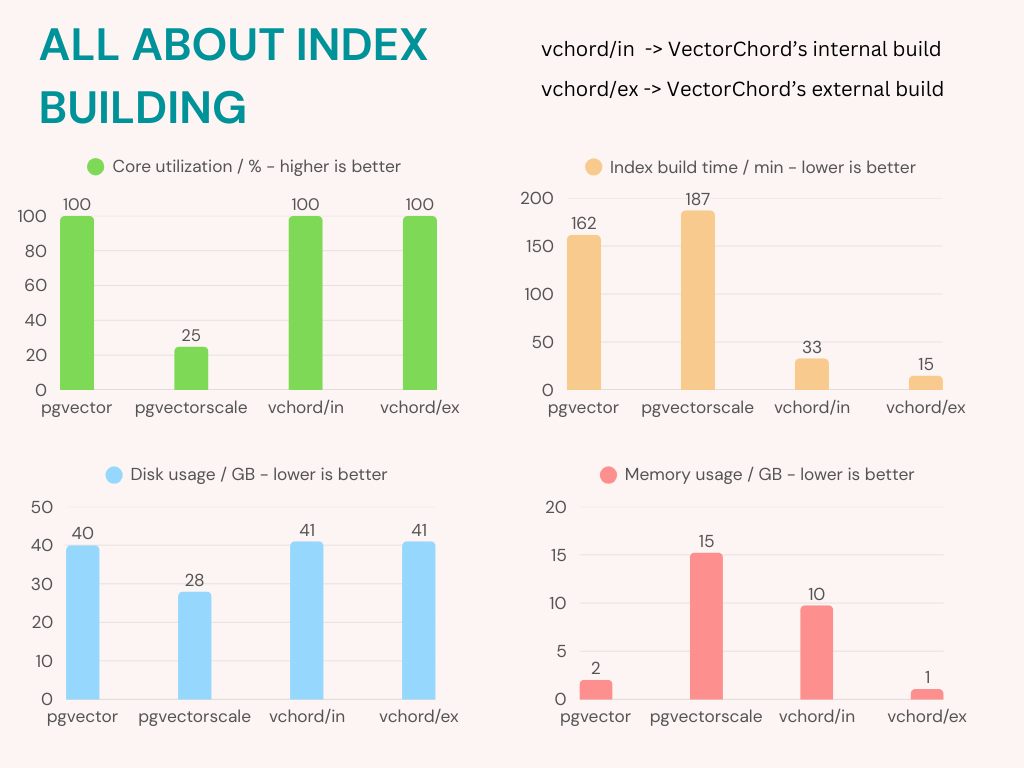
在大多数指标上,VectorChord 的外部构建均处于领先地位,但这在一定程度上牺牲了易用性,因为开发者需要在 PostgreSQL 外部实现额外的 K-means 聚类步骤并管理生成的质心。
如果您希望通过一条简单的 CREATE INDEX 命令直接上手,那么 VectorChord 的外部构建可能不是最省心的选择,您可以根据需求转向其他扩展或方式:
-
选择
VectorChord 的内部构建以获得更快的单命令索引构建速度 -
如果您的内存确实非常捉襟见肘,可以选择
pgvector -
选择
pgvectorscale以降低磁盘空间需求或获得更高的存储容量效率
插入性能:面向流式生成数据
面对流式生成的向量数据,插入速度会成为新的关注焦点。在实时数据分析系统中,每秒新写入的向量数量可能非常庞大。每当新向量添加到索引中时,索引自身也必须同步更新。这种能力通常被称为插入性能(insertion performance)。
为什么不同索引之间的插入性能存在差异?
对于基于图的索引(如 pgvector HNSW、pgvectorscale),每次索引更新通常都需要在图中执行多次搜索,并为新插入的向量建立新的边连接。而基于聚类的索引(如 VectorChord)只需找到对应的聚类分区并将新向量追加进去即可。
为此,我们设计了一项实验来检验各扩展的插入表现。在为 500 万条向量构建好索引之后,我们逐条向表中连续插入另外 100,000 条随机生成的向量,并统计全部插入完成所需的总时间。
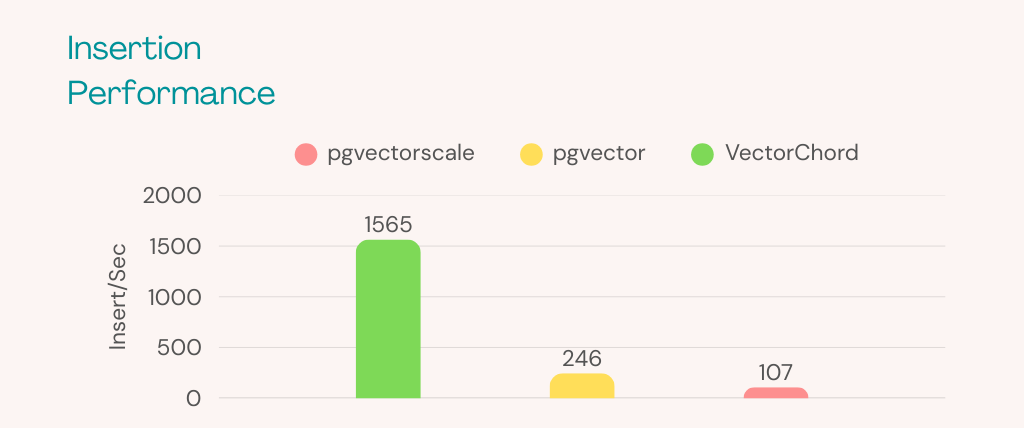
可以看到,在插入数据时,VectorChord(1565 Insert/Sec)的表现远优于 pgvector(246 Insert/Sec)和 pgvectorscale(107 Insert/Sec)。对于大多数工作负载而言,每秒 100 次插入已经绰绰有余;但如果您发现生产环境中存在大量持续写入的向量(例如达到 500 Insert/Sec),这就可能成为系统瓶颈。
总结
基于上述实验结果,下表汇总了三款扩展在各个维度的差异。我们可以看到,VectorChord 的核心优势集中在性能上,而 pgvector 和 pgvectorscale 则分别在易用性和存储容量效率方面各有千秋。
如果您希望了解更详尽的对比,下表展示了三款扩展在各个具体维度的表现:
| pgvector | pgvectorscale | VectorChord | |
|---|---|---|---|
| 易用性 | 简单 | 简单,与 pgvector 类似 | 简单(内部构建),较难(外部两阶段构建) |
| 支持索引的最大维度 | 2000 | 16000 | 16000 |
| 调优难度 | 简单 | 中等,需针对不同查询手动调整 query_rescore | 简单 |
| 可达到的最高召回率 | 较低梯队 | 中等梯队 | 第一梯队 |
| 重复查询 QPS | 中等梯队 | 较低梯队 | 第一梯队 |
| 首次查询 QPS | 中等梯队 | 第一梯队 | 第一梯队 |
| 磁盘索引 QPS | 中等梯队 | 中等梯队 | 第一梯队 |
| 索引构建速度 | 中等梯队,支持多核并行 | 较低梯队,不支持多核并行 | 第一梯队,支持多核并行 |
| 索引构建峰值内存占用 | 2.1 GB | 15.2 GB | 1.1 GB(外部构建),9.8 GB(内部构建) |
| 总磁盘占用 | 接近最大 | 最小 | 最大 |
想了解更多关于 VectorChord 与其他扩展的对比吗?在未来的博客中,我们将探索 PostgreSQL 向量扩展在更多场景下的差异,例如 BM25 混合搜索(将传统关键词搜索与向量相似度搜索相结合)以及带过滤条件的向量搜索(filtered vector search)。准备好在您的向量搜索场景中试用 VectorChord 了吗?欢迎下载扩展,加入我们的 Discord 社区,或通过 [email protected] 联系我们。
%[https://github.com/tensorchord/VectorChord]