pg_bestmatch.rs:用 BM25 全面提升 PostgreSQL 文本查询能力
更新提示:欢迎了解我们最新的扩展 VectorChord-BM25,它在 PostgreSQL 中实现了端到端的 BM25 排序。详情请阅读:https://vchord.pgsty.com/zh/blog/post/vectorchord-bm25-revolutionize-postgresql-search-with-bm25-ranking-3x-faster-than-elasticsearch/
%[https://github.com/tensorchord/VectorChord-bm25]
我们非常高兴地宣布发布 pg_bestmatch.rs——一款将 Best Matching 25(BM25)文本查询能力引入 PostgreSQL 数据库的扩展,助你执行更高效、更精准的文本检索。借助该扩展,用户可以根据文本生成 BM25 统计稀疏向量,在数据库中直接发挥 BM25 在各类基准测试任务中久经验证的卓越表现。
为什么选择 BM25?
BM25(Best Matching 25)是信息检索中广泛使用的一种概率排序函数,用于评估文档与查询之间的匹配程度。它基于词频(TF)和逆文档频率(IDF)计算相关性得分,并通过文档长度归一化加以平衡。该公式确保在文档内部高频出现的词项(TF)以及在整个语料库中罕见的词项(IDF)获得恰当的权重,从而显著提升搜索准确度与相关性。
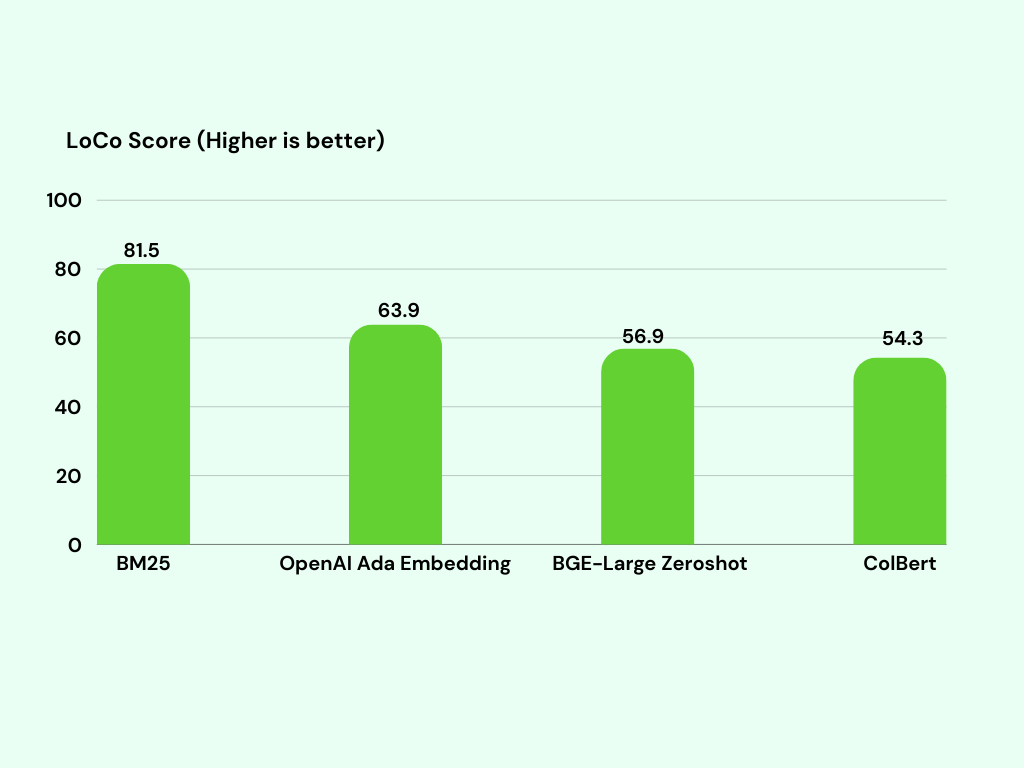
在众多 RAG 基准测试任务中,BM25 的表现已被证明优于单纯基于稠密向量的检索方法。通过将 BM25 集成到 PostgreSQL 中,你可以获得更出色的搜索性能与相关性,尤其适合对文本检索质量要求较高的应用场景。同时,你还可以将它与向量搜索结合,构建强大的混合搜索(Hybrid Search)方案。
核心特性
-
BM25 统计稀疏向量:基于你自己的文本数据,为文本生成 BM25 稀疏向量表征。
-
与向量搜索扩展无缝集成:兼容
pgvecto.rs和pgvector,在 PostgreSQL 中实现高效的向量检索。 -
开箱即用的分词能力:采用 Huggingface 的
bert-base-uncased词表与字节对编码(BPE)分词器,通过子词(subword)切分显著提升检索效果。
工作原理
BM25 的计算过程可以分解为查询(query)和文档(document)两个独立的部分。最终的相关性得分等价于查询稀疏向量与文档稀疏向量之间的点积(dot product)。因此,我们巧妙地将 BM25 排序转化为基于点积距离的稀疏向量检索问题!
使用方法
下面是使用该扩展的分步指南:
-
创建 BM25 统计信息:使用
bm25_create函数为你的文档集合生成 BM25 统计信息。该函数接收表名、列名和统计名称作为参数,并创建一个物化视图来存储 BM25 统计数据。 -
生成文档稀疏向量:使用
bm25_document_to_svector函数将文档文本转换为稀疏向量表征。该函数接收 BM25 统计名称和文档文本作为输入。 -
生成查询稀疏向量:对于每次搜索查询,使用
bm25_query_to_svector函数生成对应的查询稀疏向量。该函数同样接收 BM25 统计名称和查询文本作为输入。 -
计算相关性得分:通过计算查询稀疏向量与文档稀疏向量之间的负点积(
<#>),得出文档对于给定查询的相关性得分。该得分反映了文档与查询的匹配程度。
加入社区
我们诚邀你试用 pg_bestmatch.rs 并分享你的反馈。在我们持续改进和打磨这一扩展的过程中,你的贡献与建议至关重要。欢迎为我们的 GitHub 仓库点亮 Star,并加入我们的 Discord 服务器,成为我们不断壮大的社区中的一员!
立即使用 pg_bestmatch.rs 体验 PostgreSQL 中 BM25 文本查询的强大威力——你高效、精准文本检索的全新得力工具。