pgvecto.rs 0.2:在 PostgreSQL 中统一关系型查询与向量搜索
我们很高兴地宣布发布 pgvecto.rs 0.2,这是弥合 PostgreSQL 中关系型查询与向量搜索之间鸿沟的重要里程碑。此次更新将两者的强大能力融为一体,不仅提升了执行效率,还支持在 PostgreSQL 内部直接运行复杂的混合查询。
过去,开发者和数据科学家不得不面对分别管理关系型查询系统和向量搜索系统的严峻挑战,这带来了额外的系统复杂度与资源开销。而在 pgvecto.rs 0.2 中,我们通过集成来自 OSDI 2023 的前沿 VBASE 方法解决了这一难题,大幅提升了 PostgreSQL 内部向量搜索的效率。


真实世界应用:Immich
真实世界的应用往往需要超越简单近似最近邻(ANN)搜索的复杂查询。为了探讨这类应用的实际案例,我们来看看 immich——这是一款自托管的照片与视频备份解决方案,充分体现了高级向量查询与传统关系型查询相结合的重要性。

immich 利用高级的向量查询与关系型查询提供智能搜索功能。借助 immich,你可以根据视觉相似度、元数据和用户自定义标签高效地搜索并发现相关媒体文件,而支撑这一功能的底层技术正是 pgvecto.rs。
下面我们简要介绍 immich 中的搜索功能。假设数据库包含三张表:
其中,AssetEntity 表存储图像的基本信息,包括唯一标识符(id)、所有者(ownerId)、创建和更新时间戳(createdAt 和 updatedAt)以及其他相关属性。
ExifInfo 表包含图像特有的 EXIF 数据信息,例如纬度(lat)、经度(long)、城市、州/省、国家和描述。该表中的 assetId 列与 asset_entity 表建立关联。
此外,ImageEmbedding 表存储每张图像的向量嵌入(Embedding)。embedding 列是表示图像嵌入向量的浮点数数组,该表中的 assetId 列同样与 asset_entity 表建立关联。
下面的查询语句用于根据特定条件搜索图像,并按图像嵌入的相似度进行排序。它将 AssetEntity、ImageEmbedding 和 ExifInfo 三张表进行连接(Join),根据 ownerId、isArchived、isVisible、createdAt 以及 EXIF 信息中的 city 等条件过滤结果,最后按给定嵌入向量的相似度对图像排序,并根据指定的限制返回一定数量的结果。
这可以看作是一个典型的**单向量 TopK + 过滤(Filter)+ 连接(Join)**操作场景。pgvector 在支持此类操作时的局限性,凸显了引入 VBASE 的必要性。
在单向量 TopK 操作方面,pgvector 难以提供理想的性能。TopK 查询需要找到与目标向量最接近的 K 个近邻,但 pgvector 很难预测最优的 K 值,从而导致查询性能不佳。相比之下,VBASE 利用松弛单调性(relaxed monotonicity)克服了这一限制,带来了显著更高的效率,为单向量 TopK 查询提供了更准确、更高效的解决方案。
此外,pgvector 对向量查询结合 Filter 和 Join 操作的支持也十分有限。涉及在标量和向量数据上同时进行过滤或连接的复杂查询,在 pgvector 中很难高效执行。而 VBASE 专为无缝处理这类查询而设计:它将向量搜索系统与关系型数据库深度集成,支持在标量和向量属性上高效执行包含过滤与连接的复杂查询。这一能力使 VBASE 成为需要此类操作的应用的理想选择。
基准测试
为了评估性能,我们可以通过基准测试来衡量两套系统的效率与效果。由于目前缺乏全面的关系型向量基准测试集,我们采用衍生自 LAION 2B 图像集的 laion-768-5m-ip-probability 数据集进行测试。该数据集包含 5,000,000 个向量和 10,000 条查询。
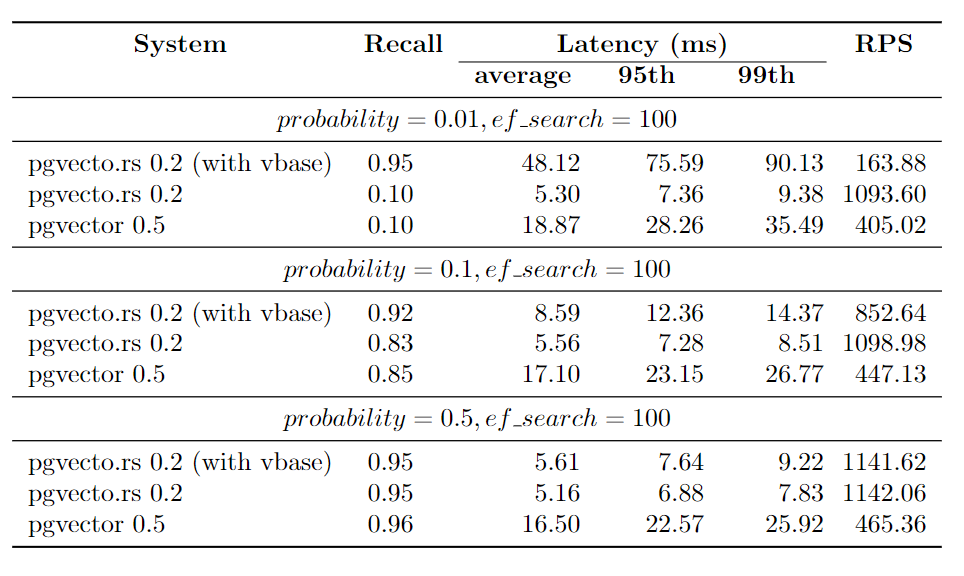
该数据集包含一个 probability 列,存储由 0 到 1 之间的均匀分布生成的随机浮点值。0.01 的比例意味着每次查询覆盖数据集的 1%(即 0.01 倍),便于进行针对性分析。
我们在保持 ef_search 不变的情况下,展示了不同 probability 范围下的召回率(Recall)、延迟(以毫秒为单位)和 RPS(每秒请求数)。ef_search 参数表示 k-NN(k 最近邻)搜索期间使用的候选列表大小,决定了搜索精度与查询处理时间之间的权衡。
结合 VBASE 使用时,pgvecto.rs 始终能够获得更高的召回率,尤其是在处理低过滤率(低 probability 值)查询时表现尤为突出。
其他特性
除了集成 VBASE 之外,pgvecto.rs 0.2 还引入了以下核心特性与改进:
-
FP16 支持:用户现在可以使用 float32 一半的存储空间在 PostgreSQL 中保存向量嵌入,从而显著降低延迟。该优化对最终召回率的影响微乎其微,损失不到 1%。
-
异步索引构建:插入操作现在是非阻塞的,确保数据插入和索引构建过程更加平滑高效。
-
查询性能翻倍:pgvecto.rs 0.2 的查询性能是上一版本(0.1)的两倍,标志着系统效率的重大飞跃。
-
可观测性:全新的
pg_vector_index_stat视图为 pgvecto.rs 的索引内部状态提供了透明的可视化窗口。用户可以实时监控索引构建进度、配置调整以及详细的统计分析,从而获得更加直观、可控的运维体验。
快速开始
要开始体验 pgvecto.rs 0.2,你可以在 Docker 容器中直接运行它:
更多详情请查阅我们的文档。我们欢迎你试用 pgvecto.rs,在你的实际业务负载下进行基准测试,并贡献你的索引创新。欢迎加入我们的 Discord 社区,与致力于改进 pgvecto.rs 的开发者及广大用户交流互动!