在 PostgreSQL 中用 30 亿向量守护地球
监测地球的健康状况是我们这个时代最严峻的挑战之一。我们的星球正面临巨大的环境压力,而要理解这些变化,就必须筛选超乎想象的海量卫星数据——持续不断捕获的 PB 级像素图像。从追踪亚马逊雨林的森林砍伐,到识别偏远地区的非法采矿作业,再到监测农业活动对敏感生态系统的影响,将这些原始数据转化为可落地的行动情报至关重要。
Earth Genome 打造的 Earth Index 平台正在正面迎击这一挑战。如今,它已实现全球覆盖,利用 AI 的力量让地球上的每一寸陆地表面都变得可搜索。这不仅是一项技术成就,更是一款旨在通过从卫星数据中提取易用、可操作的情报来赋能环境保护的全新工具。
%[https://www.earthgenome.org/]
在 VectorChord 团队,我们无比自豪地看到我们的 PostgreSQL 向量搜索扩展正在为这一宏伟而至关重要的使命提供核心动力。
Earth Index 在做什么?将像素转化为地球洞察
试想一下,要在覆盖数百万平方公里的卫星图像中,找出某种特定类型的小规模环境影响——比如一处未申报的采石场或一片新出现的森林砍伐区。传统上,分析这些数据需要深厚的专业知识和庞大的计算资源,这使得在广阔偏远的地区追踪特定威胁变得极其困难,对于预算有限的环保组织、调查记者和监管机构而言更是如此。下面的动画展示了 Earth Index 是如何高效地在亚马逊雨林中精准定位非法贩毒简易机场的——这无异于在足球场上找出一根牙签。
那么,Earth Index 是如何让在全球范围内寻找特定环境特征成为可能的呢?其中的奥秘在于一种前沿方法:使用通过对比学习(Contrastive Learning)训练的 AI 基础模型及其生成的向量嵌入(Vector Embeddings)。
以下是其创新工作流程的简要解析:
-
全球网格切片(Tiling the Globe):Earth Index 将地球的全部陆地表面划分为超过 32 亿个相互重叠的网格切片(Tiles),每个切片约占 10 公顷。
-
通过对比自监督学习“地球 DNA”:Earth Index 利用了 AI 领域的突破性进展,特别是使用自监督对比学习方法(如 DINO 目标函数)针对地球观测(Earth Observation, EO)训练的基础模型。该基础模型(例如 SSL4EO Vision Transformer)通过区分来自同一地理位置的图像对(正样本对)和来自不同地理位置的图像对(负样本对),学习卫星图像的基础视觉语言。这一过程在多样化的全球数据集(如 Harmonized Landsat Sentinel-2、Sentinel-1 雷达图像)上进行,无需人工显式标注“森林”或“城市”等特征。
-
生成向量嵌入(Generating Vector Embeddings):预训练完成后,该模型即作为编码器运行。将每个切片的图像输入其中,就会生成一个向量嵌入——这是一种丰富的数值表示或“数字指纹”,以高度压缩的格式(压缩率超过 10,000 倍)捕捉该切片的核心视觉与结构特征。这个高维向量就像是那片土地独一无二的“地球 DNA”。
-
打造可搜索的地球(Creating a Searchable Planet):这 32 亿个向量嵌入构成了 Earth Index 的核心。它们需要存储在一个专为快速查找数值相似向量而优化的系统中。用户只需提供一个想要查找的目标示例(例如在地图上点击一个已知的非法矿场或某种特定类型的农业基础设施),Earth Index 就会在这个海量数据集中进行搜索,找出全球(或特定区域内)具有相似向量指纹的其他位置。
真实世界的影响力:Earth Index 赋能环境保护实战
这一技术底座直接转化为了理解和保护环境的强大工具。它赋予了调查记者(如 Mongabay 和自由欧洲电台的记者)、原住民社区、环保及国际组织(如世界银行)以及研究人员前所未有的便捷与速度,去揭露隐蔽的环境变化、监测工业足迹,并为生态保护行动收集证据。下图展示了丰塞卡湾(Gulf of Fonseca)的养虾场分布。
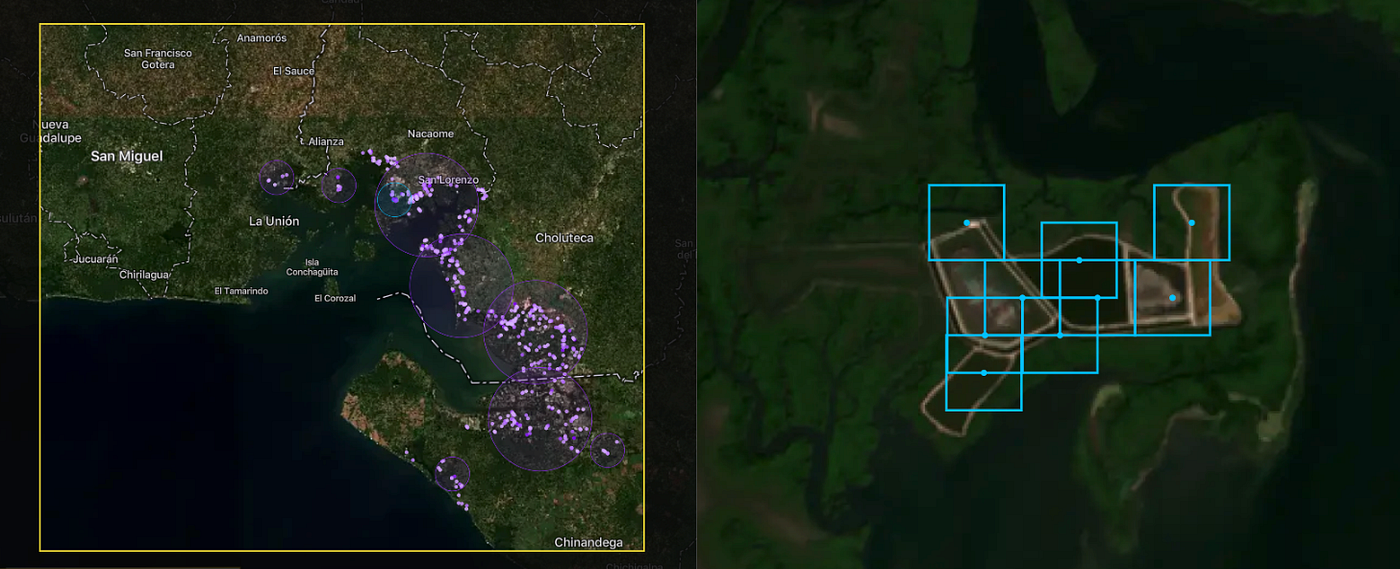
以下是 Earth Index 在实际应用中的几个典型案例:
-
打击森林砍伐与非法活动:在与 Mongabay 的合作中,Earth Index 穿透茂密的树冠层,成功识别出亚马逊雨林中隐蔽的非法贩毒简易机场。同样地,该平台还能快速定位非法采金留下的地表伤痕(例如正在破坏亚诺马米原住民领地的非法采矿点),帮助量化问题规模并指导执法行动。
-
监测资源开采:**自由欧洲电台(Radio Free Europe)**利用 Earth Index 在巴尔干半岛识别出 1,300 多个采石场,揭露其中约有一半缺乏合法许可证,凸显了潜在的环境破坏和无序开采问题。同样的方法也可用于监测水力压裂井场、橡胶加工厂或其他工业设施。
-
保护水质与生态系统:Earth Index 可以定位敏感水道附近的集中型动物饲养场(CAFO),以评估径流污染风险,或识别向关键红树林生态系统扩张的养虾场。
-
追踪农业扩张:通过搜索与新开垦土地或特定作物类型相关的特征模式,该工具能够帮助监测自然栖息地向农业用地的转化过程。
基础设施挑战:以可承受的成本搜索数十亿向量
生成 32 亿个高维向量只是挑战之一;如何高效地托管并搜索这些向量则是另一道巨大的难关。Earth Index 需要一套能够满足以下要求的解决方案:
-
应对超大规模:搜索数十亿向量需要专门的索引和查询能力。
-
与地理空间数据无缝集成:Earth Index 高度依赖地理空间操作(例如在特定行政边界内过滤结果,或筛选靠近河流的区域)。这使得配备 PostGIS 的 PostgreSQL 成为其核心数据库自然且不可或缺的选择。而独立的专用向量数据库通常缺乏所需的丰富地理空间特性。
-
保持高性能:用户需要相对快速地获得搜索结果,平台才能在调查和监测工作中发挥实效。
-
控制成本:存储和搜索数十亿向量(尤其是当纯内存索引需要海量 RAM 时)对于许多组织——特别是非营利组织——而言,硬件成本往往高得令人望而却步。
因此,Earth Index 需要一种原生运行在其选定的 PostgreSQL 环境中、能够大规模扩展、性能卓越,同时不会在硬件成本上超出预算的向量搜索解决方案。
为什么 PostgreSQL 是地球级规模向量搜索的理想之选
尽管市面上存在专用的向量数据库,但 Earth Index 面临着一个核心诉求:将向量相似度搜索与丰富的地理空间数据及操作无缝集成。这正是 PostgreSQL 结合扩展生态真正大放异彩的地方:
-
统一的数据平台:PostgreSQL(尤其是配合强大的 PostGIS 扩展)使 Earth Index 能够将向量嵌入与关键的地理空间元数据(切片位置、行政边界、与河流等地物的距离)保存在一起。这避免了为向量搜索和关系型/地理空间数据分别维护独立数据库所带来的复杂性以及潜在的数据同步问题。
-
充分发挥 SQL 与 PostGIS 的威力:Earth Index 可以在单一查询接口中,将向量相似度搜索与标准 SQL 过滤条件以及复杂的 PostGIS 空间查询(例如,“在此特定国家公园边界内或靠近该水系的范围内,查找与此示例相似的向量”)无缝结合。独立的向量数据库通常缺乏这种成熟的地理空间查询能力。
-
成熟度与生态系统:基于 PostgreSQL 构建意味着继承其数十年的研发积淀、享誉业界的稳定性、强大的工具链以及广泛的社区支持——这对于像 Earth Index 这样的关键任务平台至关重要。
然而,要高效地搜索 32 亿个向量,仅靠标准的 PostgreSQL 能力是远远不够的。
为什么 Earth Index 为了性能与性价比选择 VectorChord
虽然 PostgreSQL 生态系统提供了理想的底座,但在 32 亿向量的庞大规模下同时实现所需的性能与可承受的成本,依然是一项巨大的挑战。Earth Index 需要一种既能提供极速体验、又不会让预算爆表的解决方案。
要在性能、成本和集成度之间找到最佳平衡点并非易事。Earth Genome 首席技术官 Hutch Ingold 解释了他们的考量过程:
当我们为这 32 亿个向量评估解决方案时——充分考虑到日新月异的技术版图——标准 pgvector 在这一规模下无法满足我们的性能要求。像 Qdrant 这样的专用方案也面临困难:托管版本过于昂贵,而在我们的 Kubernetes 基础设施上自建集群部署在当时看来还不够成熟。我们也考察了云服务(例如 Google 的 Vertex AI Vector Search),但针对我们的数据集,每月高达 237,000 美元的目录报价实在令人望而却步。
这正是 VectorChord 成为关键赋能技术的原因:
-
超越原版 PGVector 的卓越性能:VectorChord 带来了亟需的速度提升——查询速度最高提升 5 倍、插入吞吐量提升 16 倍、索引构建速度提升 16 倍——彻底解决了标准 pgvector 在如此庞大规模下遇到的性能瓶颈。
-
基于磁盘索引实现高性价比扩展:至关重要的是,VectorChord 经过深度优化的磁盘索引(Disk-Based Indexing)(充分利用高性价比的 SSD)直接化解了 CTO 提到的高昂成本难题。它既避免了纯内存方案对海量 RAM 的苛刻需求,也避开了托管云向量服务天价的月度账单,使 32 亿向量的索引在财务上真正具备可行性。
-
原生集成与可扩展性:作为一款 PostgreSQL 扩展,VectorChord 直接在他们选定的数据库内部提供了这些优势,无需改动现有基础设施架构。它专为高效扩展而构建,在轻松应对 Earth Index 全球监测平台所需的数十亿向量的同时,依然保持了流畅的交互式性能。
VectorChord 在 Earth Index 所熟悉且强大的 PostgreSQL 环境中,直接提供了高性能、大规模可扩展性与高性价比的完美结合。
Earth Index:技术架构与部署配置
为了高效且经济地管理其地球级数据集,Earth Index 在由三台强大的 AWS EC2 i8g.16xlarge 实例组成的集群上构建了后端系统,这些实例搭载了最新的 Graviton4 ARM 处理器和 Nitro SSD。每台实例提供 512 GB 内存、64 个 vCPU 和 15 TB 的 NVMe 存储,为计算和磁盘 I/O 奠定了坚实的基础。这套架构每月成本约为 12,000 美元,相比同类托管云向量服务预计每月 237,000 美元的费用节省了巨额开支,使整个项目在经济上得以持续运转。这些实例运行着由 VectorChord 和 PostGIS 增强的 PostgreSQL,高效地同时承载向量数据和其他应用组件。

核心数据驻留在跨三个节点的分区表结构中。主表 globe24 存储了每个切片的唯一 ID、其地理空间点几何信息(geometry(Point, 4326))、分区键(partkey),以及至关重要的、以 halfvec(384) 高效存储的 384 维 AI 生成嵌入向量。这种分片设计将 32 亿行数据分布在集群中,支持高效的并行处理。
该架构的一大核心优势在于能够执行复杂的综合查询。Earth Index 经常执行的 SQL 语句,能够将 VectorChord 的快速向量搜索(embedding <=> '{vector}'::vector)与 PostGIS 地理空间过滤(st_within(geom, '{geom}'))以及分区裁剪(partkey IN (...))无缝结合。这让用户能够在特定地理边界内高效地查找视觉相似的位置。即便面对数十亿向量,这种一体化方法依然展现出了实用的高性能:对于返回前 500 个结果的典型搜索,中位查询延迟(p50)约为 761 毫秒。
赋能大规模环保行动
通过在 PostgreSQL 内部提供高性价比、可扩展且紧密集成的向量搜索解决方案,VectorChord 助力 Earth Index 开展了这项极具突破性的工作。它使团队能够以可承受的成本管理庞大的“地球 DNA”数据库,确保这一强大的环境监测工具能够真正惠及最需要它的组织与社区。
立即加入 Earth Index 候补名单,探索你周边的环境挑战,了解你的生态足迹,并成为守护地球全球行动的一份子。
看到 Earth Index 利用 VectorChord 将卫星数据转化为可落地的环境情报,我们感到无比振奋。他们的成功充分证明了将前沿 AI、稳健的数据库技术与高效的向量搜索相结合,在应对全球重大挑战时所能迸发出的巨大能量。
有兴趣将大规模向量搜索引入你的 PostgreSQL 数据库吗?欢迎进一步了解 VectorChord 或立即开始体验!
%[https://github.com/tensorchord/VectorChord]