2024 年 pgvector vs. pgvecto.rs:PostgreSQL 向量搜索全方位对比
pgvector 和 pgvecto.rs 都是旨在增强 PostgreSQL 向量检索能力的扩展。这些扩展彻底改变了数据库内部执行向量搜索的方式,提供了可扩展、低延迟且支持混合检索的解决方案。在这篇博客文章中,我们将详细阐述 pgvector 与 pgvecto.rs 之间的核心差异。
省流版(TL; DR):请直接跳转到文章末尾的总结小节,其中的对比表格汇总了两者之间的主要区别。
搜索能力(Search)
搜索是数据库的核心功能,在高效数据检索中扮演着至关重要的角色,能够帮助用户快速定位并访问所需信息。下面我们将展示两者的性能表现,并重点介绍 pgvecto.rs 和 pgvector 各自提供的功能特性。
过滤检索(Filtering)
虽然 pgvector 和 pgvecto.rs 都支持在 PostgreSQL 中进行向量相似度搜索,但 pgvecto.rs 更进一步,引入了来自 OSDI 2023 的 VBASE 方法。
真实业务负载往往涉及向量搜索与关系型查询的结合。向量搜索擅长相似度匹配与相似向量召回,而关系型查询则允许你在结构化数据上执行复杂的连接(JOIN)、过滤(Filter)和聚合操作。
pgvecto.rs 专为高效应对**单向量 TopK + 过滤 + 连接(Single-Vector TopK + Filter + Join)**场景而设计。
鉴于目前缺乏通用的关系型向量基准测试集,我们采用 laion-768-5m-ip-probability 数据集进行基准测试。该数据集衍生自 LAION 2B 图像数据集,包含 5,000,000 个向量和 10,000 条查询。
该数据集包含一个 probability 列,存储从 0 到 1 均匀分布中生成的随机浮点数。过滤比例为 0.01 意味着每条查询覆盖数据集的 1%(即 0.01 倍),便于进行针对性分析。
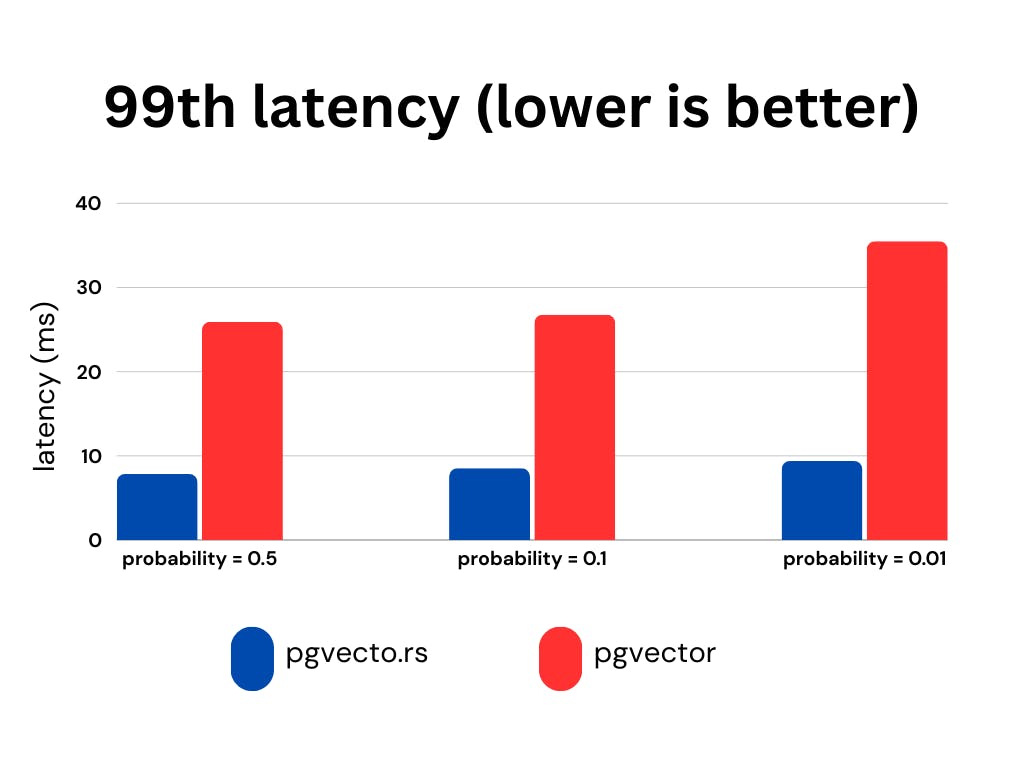
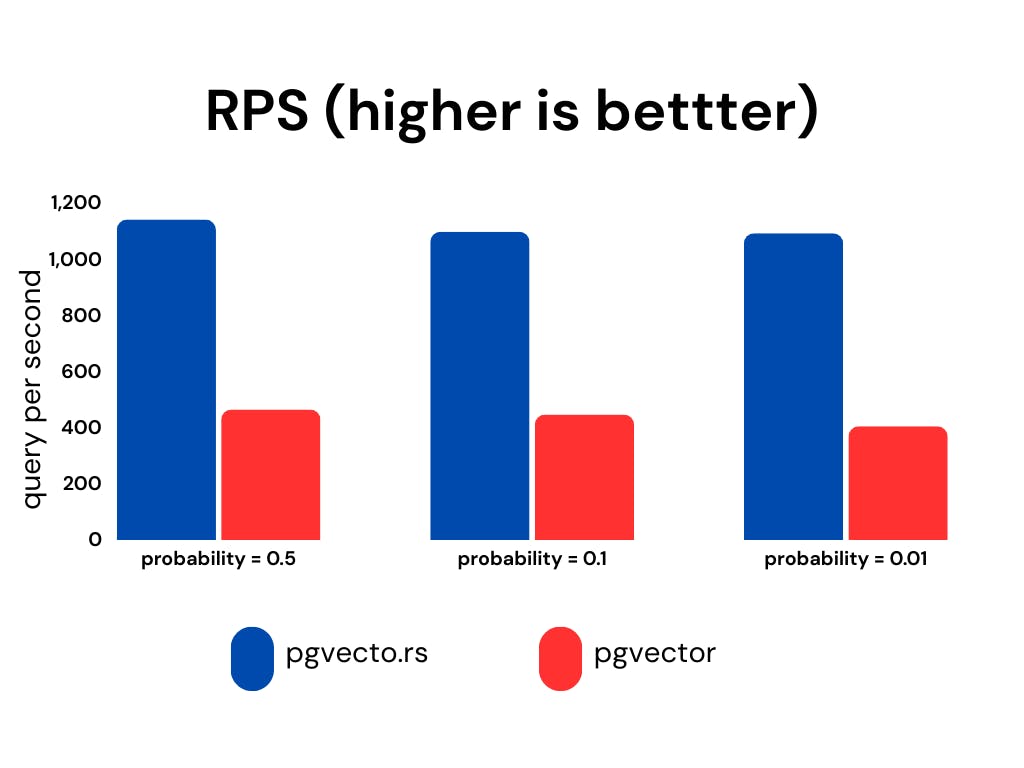
我们在保持 ef_search 恒定的前提下,展示了不同 probability 过滤范围下的召回率(recall)、延迟(毫秒)和每秒请求数(RPS)。ef_search 参数代表 k-NN(k 近邻)搜索期间维护的候选列表大小,决定了搜索精度与查询耗时之间的权衡。
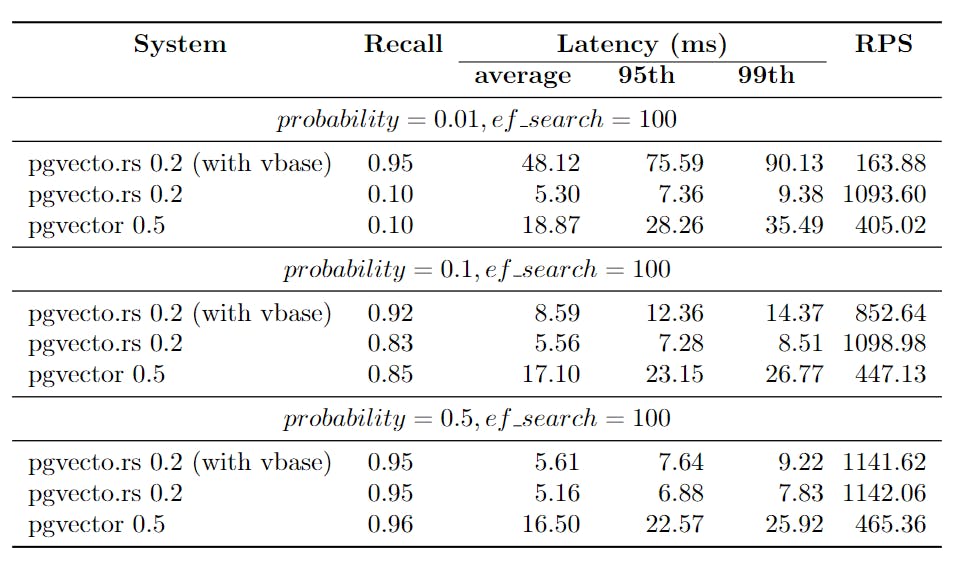
结合 VBASE 的 pgvecto.rs 始终能够带来更高的召回率,尤其是在过滤选择率较低(low probability)的场景下优势尤为明显。
稀疏向量搜索
稀疏向量(sparse vector)是仅包含极少数非零元素的高维向量,非常适合传统的信息检索场景。例如,一个拥有 32,000 个维度但只有 2 个非零元素的向量,就是典型的稀疏向量。
稠密向量(dense vector)则是来自神经网络的嵌入向量,通常由文本嵌入模型生成,其中绝大多数乃至所有元素均为非零值。它们的维度相对较少,例如 256 或 1536 维,远低于稀疏向量。
pgvector 对稠密向量搜索支持良好,但并无支持稀疏向量的计划(注:撰写本文时)。
相比之下,pgvecto.rs 同时支持稠密向量搜索和稀疏向量搜索。它提供了 svector 数据类型,用于构建稀疏向量索引并执行高效检索。
向量维度上限
pgvecto.rs 扩展支持最高 65535 维的向量,而 pgvector 扩展最高仅支持 2000 维。这一维度支持上的差异使得 pgvecto.rs 能够直接处理来自 OpenAI 最新嵌入模型的高维向量。
单指令多数据流(SIMD)
pgvecto.rs 会在运行时动态分派并充分利用用户机器上可用的 SIMD(单指令多数据流)指令集;而 pgvector 依赖编译器在编译期生成 SIMD 代码,无法在运行时自动选择更快的指令集。得益于更快的向量距离计算速度,pgvecto.rs 中的搜索性能更加出色。
数据类型(Data Types)
二值向量(Binary Vector)
bvector 是 pgvecto.rs 中的二值向量类型。它表示每个分量只能取两个可能值(通常为 0 和 1)的二值向量。
在特定嵌入模型(如 OpenAI 嵌入模型)中,二值向量具有显著优势:它能够在大幅降低内存占用的同时,保持令人满意的检索精度。
以下是 bvector 类型的性能基准测试结果。我们使用 dbpedia-entities-openai3-text-embedding-3-large-3072-1M 数据集,在 Google Cloud 的 n2-standard-8(8 vCPU,32 GB 内存)虚拟机上进行测试。
我们将 100 万个二值向量写入表中,随后对每个嵌入向量运行 KNN 查询。为 100 万个二值向量构建索引仅需约 600MB 内存,而使用标准 vector 类型为相同数量的向量构建索引则需要约 18GB 内存。如果我们采用自适应检索(adaptive retrieval),bvector 的准确率可以超过 95%。

FP16/INT8
除了二值向量外,pgvecto.rs 还支持 FP16(16 位浮点数)和 INT8(8 位整数)向量数据类型。
索引架构(Indexing)
与 pgvector 相比,pgvecto.rs 采用了截然不同的索引架构。它独立于 PostgreSQL 原生存储引擎来管理索引的存储与内存,而不是像 pgvector 那样依赖 PostgreSQL 的内置页面存储引擎。
这是一种架构上的权衡。在开发初期,我们也曾像 pgvector 一样,尝试使用 PostgreSQL 的页面存储(page storage)来实现 HNSW(Hierarchical Navigable Small World)索引。然而,我们遇到了诸多限制,阻碍了其性能与功能的发挥:
-
并行化挑战:PostgreSQL 采用“每条语句对应一个进程”的进程模型,且缺乏线程安全的内部 API,这给并行化带来了很大挑战。在构建向量索引这类计算密集型任务中,并行化可以显著提升性能。然而,当我们尝试并行化这一过程时,却频繁遭遇
Too many shared buffer locked(锁定的共享缓冲区过多)错误。 -
预写式日志(WAL)写放大:插入一个 2KB 的向量往往会产生超过 20KB 的 WAL 日志,这就是 WAL 写放大问题。这一问题源于 HNSW 算法本身的特性——插入单个数据点需要修改多条边,而 PostgreSQL 会在 WAL 中逐一记录每一次页面修改,从而导致 WAL 体积急剧膨胀。
-
锁竞争(Lock Contention):在遍历 HNSW 图进行读写时,必须对每个节点的边列表加锁,从而引发锁竞争。由于 HNSW 采用层次化结构,越往上层包含的节点越少,因此在索引高并发访问期间,上层节点极易成为锁竞争的瓶颈。当多个操作试图同时访问或修改同一个边列表时,就会导致延迟增加和并发度下降。
为此,pgvecto.rs 采用了类似于 FreshDiskANN 的设计,借鉴了日志结构合并树(LSM-tree)的思想。该架构由三个组件构成:写入段(writing segment)、增长段(growing segment)和封存段(sealed segment)。新插入的向量首先写入 writing segment;随后后台进程异步将其转换为不可变的 growing segment;最后,growing segment 会与 sealed segment 进行合并,类似于 LSM-tree 中的压缩(compaction)过程。这种设计带来了多项显著优势:
-
非阻塞插入:索引结构的修改操作不会阻塞前台的数据插入流程。
-
批量修改:将对 HNSW 图的修改分批聚合处理,显著提升了整体吞吐量。
-
消除读写锁竞争:由于 sealed segment 是不可变的,读写锁竞争问题得到了根本性缓解。
当然,这种方法也存在一定局限性。一个显著的不足是索引无法开箱即用地支持 PostgreSQL 原生的预写式日志(WAL)。这意味着依赖 WAL 的时间点恢复(PITR)和物理复制(Physical Replication)等功能暂无法直接作用于索引本身。不过,PostgreSQL 生态非常强大,允许扩展通过自定义资源管理器(Custom WAL Resource Manager)定义自己的 WAL。虽然实现这一机制需要额外的工程投入,但通过它完全可以克服这一限制,为索引提供完整的 WAL 支持。
总结
下表汇总了 pgvecto.rs 与 pgvector 之间的主要区别:
| 特性 | pgvecto.rs | pgvector |
|---|---|---|
| 过滤检索(Filtering) | 引入 VBASE 方法,高效支持向量搜索与关系型查询的结合(如单向量 TopK + Filter + Join)。 | 应用过滤条件时,返回结果可能不完整。例如原本希望 LIMIT 10,加上过滤条件后可能最终只返回 5 条结果。 |
| 稀疏向量搜索 | 同时支持稠密向量和稀疏向量搜索。 | 仅支持稠密向量搜索。 |
| 向量维度 | 最高支持 65535 维。 | 最高支持 2000 维。 |
| SIMD 优化 | 在运行时根据具体机器硬件能力动态分派 SIMD 指令,最大化性能。 | 依赖编译器在编译期生成的 SIMD 代码。 |
| 数据类型 | 额外引入二值向量(bvector)、FP16(16 位浮点数)和 INT8(8 位整数)数据类型。 | - |
| 索引架构 | 独立于 PostgreSQL 管理索引的存储与内存。 | 依赖 PostgreSQL 的原生存储引擎。 |
| WAL 支持 | 已支持数据级的预写式日志(WAL),索引级 WAL 支持正在开发中。 | 对索引和数据均提供原生 WAL 支持。 |