二值向量:`bvector`
bvector 是 pgvecto.rs 中的二值向量类型,其每个分量仅取 0 或 1 两个可能值,并针对存储和距离计算进行了深度优化。
bvector 类型是 pgvecto.rs 中的二值向量(Binary Vector)类型。在二值向量中,每个分量只能取两个可能的值(通常为 0 和 1)。
以下是创建包含 bvector 列的表并插入数据的示例:
同样可以在 bvector 类型上创建索引:
我们支持四种用于计算两个 bvector 值之间距离的操作符:
<->(bvector_l2_ops):平方欧氏距离,定义为 。对于二值向量,汉明距离(Hamming distance)与平方欧氏距离完全等价。<#>(bvector_dot_ops):负点积,定义为 。<=>(bvector_cos_ops):余弦距离,定义为 。<~>(bvector_jaccard_ops):杰卡德距离(Jaccard distance),定义为 。
此外,还提供了 binarize 函数用于从 vector 构造 bvector,它会将向量元素二值化为 0 或 1:
性能表现
bvector 类型针对存储和计算性能进行了深度优化。它采用按位紧缩(bit-packed)的表示方式存储二值向量,并且距离计算也专门针对位运算进行了加速优化。
以下是 bvector 类型的性能基准测试结果。测试使用 dbpedia-entities-openai3-text-embedding-3-large-3072-1M 数据集,运行在 Google Cloud 的 n2-standard-8(8 vCPU,32 GB 内存)虚拟机上。
我们向表中插入了 100 万条二值向量并运行 KNN 查询。为 100 万条 3072 维二值向量建立索引仅需约 600MB 内存,而使用标准 vector 类型对相同数量的向量建立索引则需要约 18GB 内存。
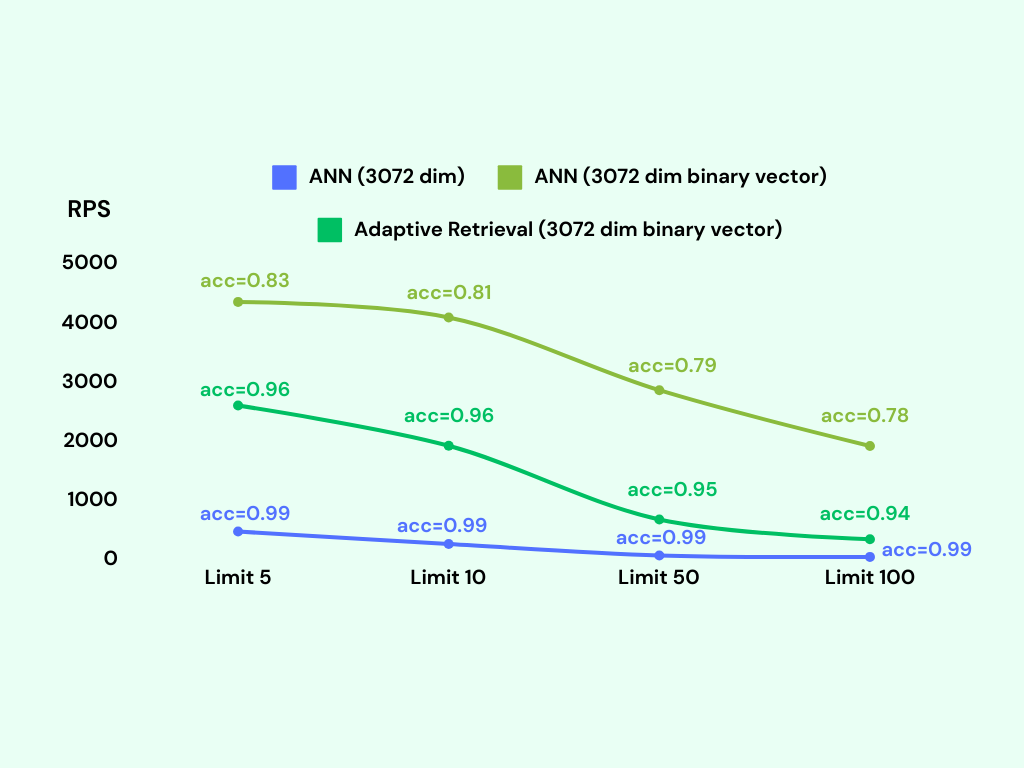
可以看到,单纯使用 bvector 的准确率虽不及 vector 类型,但如果结合采用自适应检索(Adaptive Retrieval),其准确率即可超过 95%。