了解为什么需要 BM25,安装 vchord_bm25 与 pg_tokenizer,并运行你的第一条全文排序查询。
这是本节的多页打印视图。 .
vchord_bm25 文档
面向 PostgreSQL 的原生 Okapi BM25 排序索引与 Block-WeakAnd 全文检索扩展(
vchord_bm25)。- 1: 快速上手
-
2: 使用指南与混合检索
- 2.1: 索引构建与维护
- 2.2: 查询与相关性评分
- 2.3: 过滤检索与预过滤
- 2.4: 混合检索 (BM25 + VectorChord)
- 2.5: BM25 与 Block-WeakAnd 内部原理
-
3: 参考手册与基准测试
- 3.1: SQL 参考手册
- 3.2: GUC 与索引参数
- 3.3: 性能与精度基准测试
- 3.4: 迁移到 0.4.0
- 3.5: 版本历史与 API 演进
重要
当前源码面向 0.4.0(尚未发布),使用原生 tsvector 和新的索引格式。标注 0.3.x 的 bm25vector 示例仅适用于旧版。两者不能原地升级;请先阅读0.4.0 迁移指南。
vchord_bm25(由 Pigsty 在 pgsty/vchord_bm25 维护)是一个使用 Rust(pgrx)构建的原生 PostgreSQL 扩展,在 PostgreSQL 内部实现了 Okapi BM25 相关性排序算法以及 Block-WeakAnd(Block-Max WAND) Top-K 索引扫描访问方法。
配合 pg_tokenizer(由 Pigsty 在 pgsty/pg_tokenizer 维护,提供可定制的多语言分词与词表模型)或 PostgreSQL 内置的 tsvector 分析器,vchord_bm25 将 Elasticsearch/Lucene 级别的词法全文检索排序能力直接带入关系型数据库,并能与 vchord 和 pgvector 无缝结合,实现语义 + 词法混合检索。
构建 bm25 索引、执行 Top-K Block-WeakAnd 查询、使用 WHERE 预过滤与检查索引页。
完整的 SQL 类型、操作符、函数、GUC 参数、版本演进历史以及 BEIR 基准测试结果。
从 bm25vector + pg_tokenizer(0.3.x)架构迁移至 0.4.0 原生 tsvector 索引格式的分步指南。
配置文本分析器、词干提取器、停用词、同义词、HuggingFace 模型、中文结巴(Jieba)与日文 Lindera 分词。
核心特性
- 纯正的 Okapi BM25 评分:完整支持逆文档频率(IDF)、词频饱和度控制()以及单字节量化的文档长度归一化( 与平均文档长度 ),从根本上解决了 PostgreSQL 原生
ts_rank的相关性排序局限。 - Block-WeakAnd 索引加速:使用差分位打包(Delta-Bitpacking)存储压缩倒排链表,并在每个块中记录最大得分上界,在 Top-K 查询期间直接跳过缺乏竞争力的文档块,无需扫描整条倒排链。
- 多语言分词支持:在
v0.1–v0.3中可配合pg_tokenizer(支持llmlingua2、bert_base_uncased、wiki_tocken、gemma2b、自定义语料训练模型、中文jieba、日文lindera)使用;在新一代main架构中更可直接支持 PostgreSQL 原生tsvector。 - 与 Vchord 原生混合检索:在单条 SQL 查询中同时运行词法 BM25 检索(
vchord_bm25)与稠密向量检索(vchordrq),支持倒数排序融合(RRF)或 ColBERT MaxSim 重排序。
1 - 快速上手
vchord_bm25 与 pg_tokenizer 的架构概览、安装方式与快速入门指南。
在 PostgreSQL 中快速上手 vchord_bm25:
1.1 - 架构概览
了解 VectorChord-BM25 如何为 PostgreSQL 带来原生 Okapi BM25 评分与 Block-WeakAnd Top-K 检索。
PostgreSQL 通过 tsvector、tsquery、ts_rank 和 GIN 索引提供了内置的全文检索能力。虽然它在布尔关键词匹配(@@)方面表现良好,但在现代搜索与检索增强生成(RAG)工作负载下,PostgreSQL 内置的相关性排序存在两个结构性局限:
- 排序公式不理想(
ts_rank):PostgreSQL 的ts_rank和ts_rank_cd不会在索引中维护全语料库级别的逆文档频率(IDF)或平均文档长度()。常见词与罕见的高信息量词被赋予相同的权重,且词频(TF)缺乏合理的饱和度控制。 ORDER BY ... LIMIT K必须全量扫描:PostgreSQL 的GIN索引只能加速布尔匹配(WHERE tsv @@ tsquery)。为了返回得分最高的 Top-10 文档,PostgreSQL 必须从堆表(Heap)中取出所有匹配行,逐一计算ts_rank,再对整个结果集进行排序。
VectorChord-BM25 如何解决这两个问题
VectorChord-BM25 (vchord_bm25) 引入了专为 Top-K 词法检索设计的 PostgreSQL 索引访问方法(USING bm25)和稀疏 BM25 评分操作符(<&>):
| 能力维度 | PostgreSQL 内置 (GIN + ts_rank) |
VectorChord-BM25 (vchord_bm25) |
|---|---|---|
| 排序模型 | 局部词频 / 词距 (ts_rank) |
全语料库 Okapi BM25(、、、) |
| Top-K 执行方式 | 取出并计算所有匹配元组后再排序 | 索引内 Block-WeakAnd (Block-Max WAND) 提前剪枝 |
| 倒排链压缩 | 未压缩或基础变长整数 TID 列表 | 128 文档分块、对 SIMD 友好的差分位打包(Delta-Bitpacking) |
| 文档长度归一化 | 可选的粗粒度位掩码标志 | 单字节 Fieldnorm 量化(256 项查找表) |
| 查询语义 | 要求布尔 AND/OR 精确匹配 |
跨所有查询词的非合取(Non-conjunctive)Top-K 相关性排序 |
| 分词能力 | 内置 ts_debug / Snowball |
pg_tokenizer(LLM 分词器、jieba、lindera、自定义词表)或原生 tsvector |
架构概览
flowchart LR
    subgraph Tokenization["1. 分词层 (Tokenization Layer)"]
        T1["原始文本 (Raw Text)"] --> T2["pg_tokenizer (v0.1–v0.3)\n或 to_tsvector (main)"]
        T2 --> T3["bm25vector / tsvector\n(词元 ID + 词频)"]
    end
    subgraph Index["2. BM25 索引 (USING bm25)"]
        I1["增长段 (Growing Segment)\n(仅追加页)"] --> I2["封闭段 (Sealed Segment)\n(Delta-Bitpacked 128 文档块)"]
        I2 --> I3["词项统计信息 (DF)\n+ 单字节 Fieldnorm 数组"]
    end
    subgraph Query["3. Top-K 查询 (ORDER BY vec <&> bm25query LIMIT k)"]
        Q1["块级最大得分上界 (Block-Max)"] --> Q2["Block-WeakAnd 枢轴剪枝"]
        Q2 --> Q3["Top-K 最小堆 (-BM25 得分)"]
    end
    T3 --> Index
    Index --> Query
两代 API 演进
在使用 vchord_bm25 时,请注意不同版本间的两代 API 设计:
-
稳定发布版(
v0.1.0–v0.3.0,模式bm25_catalog):- 使用自定义数据类型
bm25vector(稀疏的token_id:frequency映射,例如{1:1, 2:2})和bm25query。 - 配合
pg_tokenizer扩展(tokenizer_catalog)使用,将文本转换为INT[]词元 ID 数组,并可隐式转换为bm25vector。 - 创建索引:
CREATE INDEX idx ON documents USING bm25 (embedding bm25_ops); - 构造查询:
to_bm25query('idx', tokenize('query text', 'tokenizer_name'))
- 使用自定义数据类型
-
新一代原生
tsvector架构(main分支):- 直接作用于 PostgreSQL 内置的
tsvector数据类型(CREATE OPERATOR CLASS bm25_ops FOR TYPE tsvector USING bm25),无需额外维护单独的bm25vector列。 - 创建索引:
CREATE INDEX idx ON documents USING bm25 (vector bm25_ops) WITH (options = $$ k1 = 1.2, b = 0.75 $$); - 构造查询:
to_bm25query(to_tsvector('english', 'query text'), 'idx')
- 直接作用于 PostgreSQL 内置的
提示
本指南在各章节中均并列提供了这两种工作流的完整示例,你可以根据实际部署的版本直接选用对应的写法。
1.2 - 安装指南
通过 Pigsty、Docker、Debian 软件包或源码编译安装 VectorChord-BM25 (vchord_bm25) 与 pg_tokenizer。
重要
当前源码面向 0.4.0(尚未发布),使用原生 tsvector 和新的索引格式。标注 0.3.x 的 bm25vector 示例仅适用于旧版。两者不能原地升级;请先阅读0.4.0 迁移指南。
vchord_bm25 支持 Linux(x86_64 与 aarch64)及 macOS 平台上的 PostgreSQL 14、15、16、17 和 18。
方式一:Pigsty / 原生操作系统软件包(推荐)
Pigsty 为 EL 8/9/10、Debian 12/13 以及 Ubuntu 22.04/24.04 上的 PostgreSQL 14–18 提供了预构建的 vchord、vchord_bm25 和 pg_tokenizer 原生 RPM 与 DEB 软件包。
配置好 Pigsty 软件源后,也可以直接通过 apt 或 dnf 安装:
方式二:Docker(tensorchord/vchord-suite)
官方 tensorchord/vchord-suite Docker 镜像开箱即用地集成了 PostgreSQL、VectorChord (vchord)、VectorChord-BM25 (vchord_bm25) 以及 pg_tokenizer:
说明
你也可以从 GitHub Container Registry 拉取镜像:ghcr.io/tensorchord/vchord-suite:pg18-latest(或 pg17-latest、pg16-latest、pg15-latest、pg14-latest)。
使用 psql 连接数据库:
方式三:GitHub Release 软件包(.deb 与 RHEL .zip)
从 pgsty/vchord_bm25(上游 supervc-stack/VectorChord-bm25)与 pgsty/pg_tokenizer(上游 supervc-stack/pg_tokenizer.rs)的 GitHub Releases 页面下载对应 PostgreSQL 主版本(14–18)和 CPU 架构(amd64 / x86_64 或 arm64 / aarch64)的 .deb 或 RHEL 9+ .zip 软件包:
Debian / Ubuntu(.deb)
RHEL 9+ / Enterprise Linux(.zip 归档包)
在 RHEL 9+ 系统(要求 glibc >= 2.34)中手动通过 Release .zip 归档包安装时:
方式四:从源码编译
如需从源码编译 pgsty/vchord_bm25:
提示
编译期启用可选的 Lindera 词典特性:如果希望将 Lindera 中日韩形态学词典(ipadic、ipadic-neologd、unidic、ko-dic、cc-cedict)直接内嵌编译到 pg_tokenizer.so 中,请在编译 pg_tokenizer 时传入 --features 参数:
本地开发与调试
使用 dev 构建配置,在开启 BM25 编译优化的同时保留调试符号:
在配置预加载 vchord_bm25 后重启一个可丢弃的 PostgreSQL 测试实例,再通过 psql 连接。需要附加调试器时,可查询当前会话的后端进程 PID:
配置 PostgreSQL 并启用扩展
1. 配置 shared_preload_libraries(0.4.0 必需)
当前源码必须通过 shared_preload_libraries 预加载 vchord_bm25。请保留其他所需扩展;pg_tokenizer 对原生 to_tsvector 工作流是可选的:
修改 shared_preload_libraries 后请重启 PostgreSQL。
2. 创建扩展并设置 search_path
连接到目标数据库并启用扩展:
在 v0.1.0–v0.3.0 版本中,vchord_bm25 会将其对象安装到 bm25_catalog 模式,而 pg_tokenizer 会安装到 tokenizer_catalog 模式。请将这两个模式加入你的 search_path:
验证已安装的扩展版本:
1.3 - 快速开始
使用 vchord_bm25 在 PostgreSQL 中运行你的第一条 BM25 全文排序检索查询。
重要
当前源码面向 0.4.0(尚未发布),使用原生 tsvector 和新的索引格式。标注 0.3.x 的 bm25vector 示例仅适用于旧版。两者不能原地升级;请先阅读0.4.0 迁移指南。
本指南将带你一步步创建数据表、对文档进行分词、构建 bm25 索引,并执行 Top-K BM25 检索查询。
工作流 A:bm25vector + pg_tokenizer(v0.1 – v0.3)
在已发布的 v0.1.0 至 v0.3.0 版本中,vchord_bm25 与 pg_tokenizer 配合使用,将文本分词并存储到 bm25vector 列中。
1. 启用扩展并配置 search_path
2. 创建分词器
使用 create_tokenizer 搭配内置的 llmlingua2(或 bert_base_uncased)模型创建分词器:
提示
需要领域专属词表、中文分词(jieba)或日文分词(lindera)?请参阅 分词器 (pg_tokenizer) 章节。
3. 创建表并写入文档
4. 将文档分词为 bm25vector
tokenize(text, tokenizer_name) 返回一个由词元 ID 组成的 INT[] 数组,它可以隐式转换为 bm25vector(自动将重复的词元 ID 聚合为词频):
5. 构建 bm25 索引
6. 执行 Top-K BM25 查询
在升序 ORDER BY 子句中结合 <&> 操作符与 to_bm25query(index_name, query_vector) 执行检索:
重要
为什么 <&> 返回负数?
PostgreSQL 仅支持按升序(ASC)执行索引驱动的 ORDER BY 扫描。因此,<&> 操作符返回的是负的 BM25 得分(例如 -2.8415)。数值越负代表相关性越高,从而使 ORDER BY embedding <&> to_bm25query(...) ASC LIMIT K 能够直接利用 Block-WeakAnd 索引扫描。如果希望展示正数得分,只需在 SELECT 列表中对该表达式取反(-(embedding <&> ...))即可。
工作流 B:原生 tsvector API(main 分支)
在新一代 main 分支重构中,vchord_bm25 可直接为 PostgreSQL 原生的 tsvector 类型建立索引——对于标准语言无需安装额外的分词器扩展。
1. 创建扩展与数据表
2. 在 tsvector 上构建 bm25 索引
3. 使用 to_bm25query(tsvector, regclass) 查询
2 - 使用指南与混合检索
索引管理、Top-K 查询、预过滤、与 vchord 的混合检索以及 Block-WeakAnd 内部原理。
了解如何在生产环境中构建、调优和查询 vchord_bm25 索引:
创建 bm25 索引、调优段大小与 BM25 参数(k1、b)、监控并行构建进度并检查索引页。
运行 Top-K Block-WeakAnd 查询、理解负值 BM25 得分并调优 bm25_limit。
通过后过滤、预过滤和部分索引,将 WHERE 过滤条件与 BM25 排序无缝结合。
通过倒数排序融合(RRF)和 ColBERT 重排序,融合稀疏 BM25 词法检索与 VectorChord 稠密向量检索。
深入解析 Okapi BM25 公式、单字节 Fieldnorm 量化、差分位打包与 Block-Max WAND 算法。
2.1 - 索引构建与维护
在 PostgreSQL 中创建、配置、维护和检查 bm25 索引。
vchord_bm25 提供了 bm25 索引访问方法以及需要显式指定的 bm25_ops 操作符类。0.4.0 的 SQL 处理器为 bm25_amhandler,0.3.x 为 _bm25_amhandler。
创建 bm25 索引
稳定发布版(v0.1 – v0.3,bm25vector)
新一代 main 分支(tsvector)
在 main 分支中,bm25_ops 直接作用于 tsvector,并支持索引级存储参数(options、limit 和 prefilter):
存储参数 (WITH (...)) |
类型 | 默认值 | 取值范围 | 说明 |
|---|---|---|---|---|
options (k1) |
float(TOML 内) |
1.2 |
1.2 – 2.0 |
词频饱和度参数 。数值越大,文档内重复出现的词项权重越高。 |
options (b) |
float(TOML 内) |
0.75 |
0.0 – 1.0 |
文档长度归一化参数 。0.0 禁用长度归一化;1.0 完全按相对于 的文档长度进行归一化。 |
limit |
int |
0 |
0 – 65535 |
存储在索引上的默认 Top-K 检索上限(当会话 GUC bm25.limit 保持默认来源或执行 RESET 后使用)。 |
prefilter |
bool |
false |
true / false |
存储在索引上的默认预过滤行为(可在会话级通过 bm25.prefilter 覆盖)。 |
你可以使用 ALTER INDEX 动态更新现有索引上的 limit 或 prefilter 参数:
自动分词触发器(v0.1 – v0.3)
使用 pg_tokenizer 时,可以通过触发器在执行 INSERT 和 UPDATE 时自动同步更新 bm25vector 列:
使用自定义模型触发器(一步到位辅助函数)
create_custom_model_tokenizer_and_trigger 会一步完成自定义模型创建、分词器创建、存量数据回填,并自动挂载 BEFORE INSERT OR UPDATE 触发器:
将标准 PL/pgSQL 触发器用于预训练模型
如果你使用的是预训练模型(如 llmlingua2 或 bert_base_uncased),可以创建一个标准的触发器函数:
段架构:增长段(Growing)与封闭段(Sealed)(v0.1 – v0.3)
在内部实现中,vchord_bm25 将索引元组组织为两种段状态:
- 增长段(Growing Segment):新写入的元组(
INSERT/UPDATE)会追加到增长段中,从而无需重新压缩整条倒排链表即可获得极高的写入吞吐量。 - 封闭段(Sealed Segment):当增长段超过
bm25_catalog.segment_growing_max_page_size个页面(默认4096页,约 32 MB)时,它会被封存为不可变的只读段,采用差分位打包(Delta-Bitpacked)的 128 文档块结构,并预计算块级最大得分上界与词项文档频率(DF)统计信息。
并行索引构建与进度监控
索引构建支持 PostgreSQL 并行维护工作进程(Parallel Maintenance Workers),并可通过 pg_stat_progress_create_index 跨三个阶段实时汇报构建进度:
initializing(初始化)scanning table(扫描表)writing index structures(写入索引结构)
检查索引页(v0.3.0)
0.3.0 版本提供了 bm25_page_inspect(index regclass, blkno int) 函数,用于检查 bm25 索引的内部元数据与页头信息:
索引约束与限制
- 仅支持单列索引:
bm25索引只能创建在单个bm25vector(或tsvector)列上,不支持多列联合bm25索引。 - 不支持 Unlogged 表:
bm25访问方法不支持UNLOGGED表(调用ambuildempty会抛出Unlogged indexes are not supported错误)。 - 仅支持正向扫描:
bm25索引扫描在<&>操作符上仅支持正向(ASC)扫描方向。
2.2 - 查询与相关性评分
执行 Top-K BM25 查询、理解负值 BM25 得分并调优检索上限参数。
基础 Top-K 查询语法
要运行经索引加速的 Top-K BM25 检索,请在 ORDER BY 子句中将 <&> 操作符与 to_bm25query 结合使用:
为什么 to_bm25query 需要传入索引名称
与向量距离操作符不同(两个向量之间的距离仅取决于这两个向量本身),一篇文档的 BM25 得分依赖于存储在 BM25 索引中的全语料库统计信息:
- 语料库中的文档总数()
- 全语料库的平均文档长度()
- 每个查询词元在语料库中的文档频率()
将索引('documents_embedding_bm25'::regclass)传入 to_bm25query(...),使得独立评分函数(search_bm25query / _bm25_evaluate)即使在 PostgreSQL 于 SELECT 投影列表中求值 <&> 或执行暴力顺序扫描(Sequential Scan)时,也能从索引中读取语料库统计信息。
理解负值 BM25 得分
根据设计,<&> 返回的是负值 BM25 得分:
- PostgreSQL 的索引访问方法 API(
amcanorderbyop)仅支持对ORDER BY <operator> ASC执行按索引排序的扫描。 - 由于 BM25 得分越高代表相关性越强,返回 $-\text{BM25}(D, Q)$ 可以在默认的升序(
ASC)排列下,将最相关的文档排在最前面。 - 切勿使用
ORDER BY embedding <&> to_bm25query(...) DESC——PostgreSQL 无法对DESC排序使用正向bm25索引扫描,会导致回退到全表扫描或抛出扫描方向错误。
调优 bm25_limit 与 SQL LIMIT
由于 Block-WeakAnd 在索引扫描期间会维护一个有界 Top-K 最小堆,以激进地剪枝缺乏竞争力的倒排块,因此索引扫描器在扫描开始时就需要知道 (即最多需要收集多少个候选文档)。
在 v0.1.0 – v0.3.0 中:bm25_catalog.bm25_limit
GUC 参数 bm25_catalog.bm25_limit(默认值为 100,取值范围 -1 至 65535)控制单次 bm25 索引扫描最多返回的 Top-K 文档数量:
bm25_catalog.bm25_limit 的特殊取值说明:
| 取值 | 行为说明 |
|---|---|
1 – 65535 |
使用 Block-WeakAnd 计算并返回最多 bm25_limit 条高分文档(默认 100)。 |
0 |
立即返回 0 行。 |
-1 |
禁用 Block-WeakAnd Top-K 剪枝,对索引中所有匹配的倒排项执行全量暴力扫描。 |
在 main 分支中:bm25.limit 与索引 limit 存储参数
在 main 分支中,实际生效的检索上限按以下优先级顺序决定:
- 显式设置的会话 GUC 参数
bm25.limit,包括零值。 - 否则使用索引存储参数
WITH (limit = ...)。
两层默认值均为零,因此检索前必须设置正值。显式零值会报错,不触发回退。执行 RESET "bm25.limit" 可恢复索引默认值。
postgresql.conf、ALTER DATABASE、ALTER ROLE 或客户端启动选项中的设置也会覆盖索引参数。RESET 会恢复这些配置默认值;只有 GUC 来源恢复为内置默认值时,才会回退到索引参数。
警告
请始终确保 bm25_catalog.bm25_limit(或 bm25.limit)大于或等于 SQL 查询中的 LIMIT 值。如果 SQL 查询指定了 LIMIT 200,而 bm25_limit 仍为 100,则索引扫描在产出 100 行后就会停止。
使用 EXPLAIN 验证查询计划
使用 EXPLAIN (ANALYZE, BUFFERS) 确认 PostgreSQL 正在使用 Index Scan using ... on documents:
如需强制执行顺序扫描 + 精确暴力求值(常用于验证召回率或调试),可以临时禁用索引扫描:
2.3 - 过滤检索与预过滤
通过后过滤、预过滤和部分索引,将 SQL WHERE 子句与 BM25 Top-K 相关性排序相结合。
在实际业务场景中,全文 BM25 排序通常需要与结构化关系过滤条件(例如 category_id = 5、tenant_id = 'acme' 或时间范围)结合使用。vchord_bm25 支持三种带过滤条件的 BM25 检索策略。
1. 后过滤(Post-Filtering)与预过滤(Pre-Filtering)
当你执行一条同时包含 WHERE 子句和 ORDER BY embedding <&> to_bm25query(...) LIMIT K 的查询时:
vchord_bm25 可以通过以下两种方式评估 WHERE 谓词:
后过滤(enable_prefilter = false)
bm25索引在整个语料库上运行 Block-WeakAnd,返回全局前bm25_limit名候选文档(例如全局 Top 100)。- PostgreSQL 回表取出这 100 条堆表元组,并应用
WHERE category = 'database'过滤条件。 - 注意事项:如果全局 Top-100 文档中只有 3 篇满足
category = 'database',那么即使表里还有数百篇 BM25 得分略低的'database'类别文档,查询也只会返回 3 行!
预过滤(enable_prefilter = true)
启用预过滤后,vchord_bm25 会在将候选文档推入 Block-WeakAnd Top-K 堆之前,先行检查堆表可见性并评估过滤条件是否满足:
- 不满足过滤条件的文档绝不会进入 Top-K 堆,也不会抬高 Block-WeakAnd 的剪枝阈值 。
- 索引扫描会持续推进,直到找齐 篇既满足
WHERE过滤条件、又在所有匹配行中拥有最高 BM25 得分的文档。
启用预过滤
在 v0.2.2 – v0.3.0 中:
在 main 分支中:
2. 面向高选择性分区键的部分 BM25 索引(Partial Index)
如果你经常按固定的一组分区键(例如 status = 'published' 或特定 tenant_id)进行过滤,可以创建部分 bm25 索引(Partial Index):
查询部分索引时,请在 to_bm25query 中指定该部分索引的名称,并在 SQL 中附上匹配的 WHERE 条件:
选择合适的过滤策略
| 过滤条件选择率 | 推荐策略 | 原因说明 |
|---|---|---|
| 高匹配率(50%–100% 的行匹配) | 后过滤(enable_prefilter = false)并适当调大 bm25_limit |
避免在 WAND 内层循环中频繁回表读取堆页;全局 Top-100 中即可轻松包含 10 条以上匹配行。 |
| 中等匹配率(5%–50% 的行匹配) | 预过滤(enable_prefilter = true / bm25.prefilter = true) |
确保在过滤后的子集上实现精确的 Top-K 召回,同时不扫描无关倒排项。 |
| 固定租户 / 状态子集 | 部分 bm25 索引(CREATE INDEX ... WHERE ...)或表分区 |
索引体积更小,拥有针对该子集独立的 IDF 统计信息,且对其他分区零无效检查开销。 |
2.4 - 混合检索 (BM25 + VectorChord)
结合稀疏词法 BM25 检索 (vchord_bm25) 与稠密向量检索 (vchord),通过倒数排序融合 (RRF) 与 ColBERT 重排序提升检索精度。
现代检索增强生成(RAG)与搜索流水线通常将稠密向量检索(vchord,擅长捕捉语义相似性)与稀疏词法 BM25 检索(vchord_bm25,擅长捕捉精确关键词、标识符与罕见词匹配)结合使用。由于这两个扩展均原生运行在 PostgreSQL 内部,你可以在单条 SQL 查询中端到端执行混合检索,无需任何外部编排服务。
混合检索表结构准备
方式一:纯 SQL 实现倒数排序融合(RRF)
倒数排序融合(Reciprocal Rank Fusion,RRF) 能够直接融合来自多个检索系统的排名结果,而无需在 L2/余弦距离与 BM25 得分之间做复杂的分数归一化校准:
其中 为平滑常数(通常取 )。
方式二:混合召回 + ColBERT 晚期交互重排序
如果追求更高的检索精度,可以先使用 vchordrq(稠密检索)+ vchord_bm25(词法检索)召回候选文档并集,再在 PostgreSQL 内使用 VectorChord 的 @# (max_sim) 多向量 ColBERT 操作符进行精细重排序:
提示
请参阅我们的工程深度解析博客 在 PostgreSQL 中使用 ColBERT 重排序为向量检索加速 以及 使用 Postgres 原生 BM25 与 VectorChord 实现混合检索,了解在 PostgreSQL 内部执行“稠密向量 + BM25 + ColBERT 重排序”的完整 BEIR 基准测试对比。
2.5 - BM25 与 Block-WeakAnd 内部原理
vchord_bm25 中 Okapi BM25、单字节 Fieldnorm 量化、差分位打包与 Block-WeakAnd 的数学公式与索引架构详解。
本页详细介绍 vchord_bm25(位于 crates/bm25/src/bm25.rs 与 src/algorithm/block_wand.rs)中实现的精确评分公式与底层数据结构。
1. Okapi BM25 评分公式
给定一篇文档 和一个查询 ,其中查询词频为 ,文档内词频为 ,vchord_bm25 按如下公式计算相关性得分:
逆文档频率()
其中:
- 为表中已索引文档的总数。
- 为包含词元 的文档数量(即文档频率 DF)。
饱和词频()
其中:
- 为词元 在文档 中出现的词频。
- 为从单字节
fieldnormID 解码得到的量化文档长度(文档 中的总词元数)。 - 为所有已索引文档的平均文档长度。
- (默认值为
1.2)用于控制词频饱和度。 - (默认值为
0.75)用于控制文档长度归一化强度。
2. 单字节 Fieldnorm 量化(FIELDNORM_TO_LENGTH)
如果为每篇文档都存储 32 位浮点数或整数长度,并在对每个倒排项评分时执行浮点除法,将消耗大量的内存带宽和 CPU 周期。为此,vchord_bm25 使用包含 256 个表项的 FIELDNORM_TO_LENGTH 查找表,将文档长度 量化为单个字节(u8,0..=255):
- 短文档精确表示(
0–40个词元):取值0..=40与真实词元数量呈 1:1 精确映射。 - 长文档对数步长增长(
41–255):步长随长度呈对数级递增(例如42, 44, 46, ...,最高可覆盖2,013,265,944个词元)。 - 256 项预计算得分缓存:由于
fieldnorm只有 256 种可能取值,vchord_bm25会在查询开始时针对每个查询词预先计算出全部 256 种可能文档长度的分母项:
如此一来,在索引扫描期间为候选倒排项打分就简化为一次查表与一次浮点除法:
3. 倒排链压缩与 Block-WeakAnd(Block-Max WAND)
基于差分位打包(Delta-Bitpacking)的 128 文档定长块
对于封闭段(Sealed Segment)中的每个词项,由 (doc_id, term_frequency) 组成的倒排链表会被划分为每块 128 篇文档的定长块,并采用**差分位打包(Delta-Bitpacking)**进行压缩:
- 块内文档 ID 按升序排列,存储相邻文档 ID 的差值(),并按块内最大差值所需的最小位宽进行位打包。
- 每个块头记录该块的最后一个文档 ID(用于快速浅层跳转查找,Shallow Seek)以及能够在当前 128 文档块内产生最高 BM25 分数贡献的块内最大词频 / 最短长度对 $(\text{tf}{\max}, \text{fn}{\min})$。
Block-WeakAnd Top-K 剪枝循环
在执行 ORDER BY vec <&> to_bm25query(...) LIMIT K 扫描期间:
flowchart TD
    A["按当前 doc_id 对查询词游标排序"] --> B["跨游标累加全局最大得分上界 max_score\n直到累加和 > 当前 Top-K 阈值 θ(确定枢轴文档 Pivot)"]
    B --> C{"枢轴处的块级最大得分之和\n(Block-Max) > θ ?"}
    C -- "否(剪枝跳过整块!)" --> D["直接跳过整个 128 文档块\n无需解码倒排项"]
    C -- "是" --> E{"所有前导游标是否均已\n对齐到 Pivot doc_id?"}
    E -- "否" --> F["将前导游标推进至 Pivot doc_id"]
    E -- "是" --> G["解码数据块并计算精确 BM25 得分\n更新 Top-K 最小堆并抬高阈值 θ"]
    D --> A
    F --> A
G --> A- 枢轴选择(Pivot Selection):所有查询词游标按其当前指向的
doc_id升序排列。从第一个游标开始,vchord_bm25依次累加各词项的全局得分上界max_score,直到累加和超过 Top-K 最小堆中当前的第 高分阈值 。使累加和跨过 的那个游标所指向的文档即被选为枢轴文档(Pivot Document)。 - 块级上界精化(Block-Max Refinement):在不解压任何倒排块的前提下,
vchord_bm25将前导游标浅层定位(Shallow Seek)到枢轴所在的 128 文档块,并累加更紧致的块级得分上界(block_max_score)。 - 快速跳块(Fast Block Skipping):如果各游标的
block_max_score之和 ,说明当前块交集中的任何文档都不可能进入 Top-K 结果——扫描器会直接跳过该块,完全不必解码文档 ID 或词频数据。 - 精确求值(Exact Evaluation):只有当块级上界之和超过 且所有前导游标均对齐到
pivot_doc时,vchord_bm25才会解码该数据块、检查 MVCC 可见性/删除位图(以及可选的预过滤条件)、计算精确的 BM25 得分,并更新 Top-K 最小堆。
3 - 参考手册与基准测试
vchord_bm25 与 pg_tokenizer 的完整 SQL 参考手册、GUC 参数、性能基准测试与版本演进历史。
vchord_bm25 与 pg_tokenizer 的完整技术参考资料:
涵盖 bm25vector、bm25query、tsvector、<&>、to_bm25query、bm25_page_inspect 以及全部 19 个 pg_tokenizer 函数的完整参考。
v0.1–v0.3 (bm25_catalog.) 与 main 分支 (bm25.) 的会话 GUC 参数及索引存储选项。
与 Elasticsearch、Lucene、ParadeDB 及 PostgreSQL GIN 的 QPS 吞吐量与 NDCG@10 检索精度对比。
从 v0.1.0 到 v0.3.0 再到新一代原生 tsvector 架构的变更日志与模式演进。
3.1 - SQL 参考手册
vchord_bm25 与 pg_tokenizer 的完整 SQL 数据类型、操作符、类型转换、索引访问方法与函数参考。
重要
当前源码面向 0.4.0(尚未发布),使用原生 tsvector 和新的索引格式。标注 0.3.x 的 bm25vector 示例仅适用于旧版。两者不能原地升级;请先阅读0.4.0 迁移指南。
vchord_bm25 数据类型
| 数据类型 | 所属模式 | 适用版本 | 文本表示形式 / 内部结构 | 说明 |
|---|---|---|---|---|
bm25vector |
bm25_catalog |
v0.1.0 – v0.3.0 |
{token_id:freq, ...}(例如 {1:1, 2:2, 15:1}) |
将 32 位无符号词元 ID 映射为 32 位词频的稀疏向量。存储策略为 STORAGE = EXTERNAL。 |
bm25query |
bm25_catalog |
v0.1.0 – v0.3.0 |
(index_oid regclass, query_vector bm25vector) |
将目标 bm25 索引 OID 与查询 bm25vector 配对的复合类型。 |
bm25query |
public / 扩展模式 |
0.4.0 / main |
(vector tsvector, index regclass) |
将查询 tsvector 与目标 bm25 索引 OID 配对的复合类型。 |
bm25vector 字面量语法(v0.1 – v0.3)
vchord_bm25 操作符
| 操作符 | 左操作数 | 右操作数 | 返回类型 | 适用版本 | 说明 |
|---|---|---|---|---|---|
<&> |
bm25vector |
bm25query |
real (f32) |
v0.1.0 – v0.3.0 |
计算负值 BM25 相关性得分($-\text{BM25}(D, Q)$)。支持使用 bm25_ops 执行索引加速的 ORDER BY ... ASC 扫描。 |
<&> |
tsvector |
bm25query |
float8 (f64) |
0.4.0 / main |
在原生 tsvector 上计算负值 BM25 相关性得分。支持使用 bm25_ops 执行索引加速的 ORDER BY ... ASC 扫描。 |
= |
bm25vector |
bm25vector |
bool |
v0.2.0 – v0.3.0 |
比较两个 bm25vector 值是否完全相等。 |
<> |
bm25vector |
bm25vector |
bool |
v0.2.0 – v0.3.0 |
比较两个 bm25vector 值是否不相等。 |
vchord_bm25 函数
| 函数签名 | 返回类型 | 适用版本 | 说明 |
|---|---|---|---|
to_bm25query(index_oid regclass, query_vector bm25vector) |
bm25query |
v0.1.1 – v0.3.0 |
根据 bm25 索引名称/OID 与查询 bm25vector(或经由隐式转换的 INT[])构造 bm25query。 |
to_bm25query(index_oid regclass, query_vector int[]) |
bm25query |
v0.3.0 |
直接接受 INT[] 词元 ID 数组的显式重载函数。 |
to_bm25query(vector tsvector, index regclass) |
bm25query |
0.4.0 / main |
根据原生 tsvector 与目标 bm25 索引名称/OID 构造 bm25query。 |
search_bm25query(target_vector bm25vector, query bm25query) |
real |
v0.1.0 – v0.3.0 |
bm25vector <&> bm25query 操作符的底层实现函数。 |
_bm25_evaluate(left tsvector, right bm25query) |
float8 |
0.4.0 / main |
tsvector <&> bm25query 操作符的底层实现函数。 |
bm25_page_inspect(index regclass, blkno int) |
text |
v0.3.0 |
返回 bm25 索引第 blkno 号数据块的可读诊断元数据。 |
vchord_bm25 访问方法与操作符类
| 对象类型 | 名称 | 目标类型 | 排序操作符 |
|---|---|---|---|
| 访问方法 (Access Method) | bm25 |
索引 (Index) | 0.4.0 处理器为 bm25_amhandler;0.3.x 为 _bm25_amhandler |
| 操作符族 (Operator Family) | bm25_ops |
USING bm25 |
<&> 位于扩展模式(0.4.0)或 pg_catalog(0.3.x),按 float_ops 排序 |
| 操作符类 (Operator Class) | bm25_ops |
bm25vector(v0.1–v0.3)/ tsvector(main) |
USING bm25 的显式操作符类 |
pg_tokenizer 函数(tokenizer_catalog)
所有 pg_tokenizer 函数均位于 tokenizer_catalog 模式中:
分词器管理与执行
| 函数签名 | 返回类型 | 说明 |
|---|---|---|
create_tokenizer(name TEXT, config TEXT) |
void |
根据 TOML 配置字符串创建一个命名分词器。 |
drop_tokenizer(name TEXT) |
void |
删除已有的分词器。 |
tokenize(text TEXT, tokenizer_name TEXT) |
INT[] |
使用 tokenizer_name 对 text 进行分词,返回整数词元 ID 数组(可隐式转换为 bm25vector)。 |
文本分析器管理
| 函数签名 | 返回类型 | 说明 |
|---|---|---|
create_text_analyzer(name TEXT, config TEXT) |
void |
创建可复用的命名文本分析器流水线(包含 character_filters、pre_tokenizer、token_filters)。 |
drop_text_analyzer(name TEXT) |
void |
删除指定的命名文本分析器。 |
apply_text_analyzer(text TEXT, text_analyzer_name TEXT) |
TEXT[] |
对 text 运行指定的文本分析器,返回归一化后的字符串词元数组(常用于调试分词效果)。 |
模型管理
| 函数签名 | 返回类型 | 说明 |
|---|---|---|
create_custom_model(name TEXT, config TEXT) |
void |
使用指定的文本分析器,在现有表列上训练自定义词表模型。 |
drop_custom_model(name TEXT) |
void |
删除自定义模型及其底层词表数据表。 |
create_custom_model_tokenizer_and_trigger(tokenizer_name TEXT, model_name TEXT, text_analyzer_name TEXT, table_name TEXT, source_column TEXT, target_column TEXT) |
void |
一步创建自定义模型与分词器,回填 table_name 表中的 target_column 列,并绑定自动 BEFORE INSERT OR UPDATE 触发器。 |
create_huggingface_model(name TEXT, config TEXT) |
void |
从 HuggingFace tokenizer.json 字符串导入模型。 |
drop_huggingface_model(name TEXT) |
void |
删除已导入的 HuggingFace 模型。 |
create_lindera_model(name TEXT, config TEXT) |
void |
根据 TOML 配置创建 Lindera 形态学分析模型(如 ipadic)。 |
drop_lindera_model(name TEXT) |
void |
删除 Lindera 模型。 |
词典与预加载管理
| 函数签名 | 返回类型 | 说明 |
|---|---|---|
create_stopwords(name TEXT, config TEXT) |
void |
创建自定义停用词典(每行一个停用词)。 |
drop_stopwords(name TEXT) |
void |
删除自定义停用词典。 |
create_synonym(name TEXT, config TEXT) |
void |
创建自定义同义词典(每行以空格分隔一组同义词,统一映射到该行第一个词)。 |
drop_synonym(name TEXT) |
void |
删除自定义同义词典。 |
add_preload_model(name TEXT) |
void |
注册在 PostgreSQL 服务启动(shared_preload_libraries)时预加载的模型。 |
remove_preload_model(name TEXT) |
void |
从启动预加载列表中移除指定模型。 |
list_preload_models() |
TEXT[] |
返回当前已注册为启动预加载的所有模型名称列表。 |
内部触发器与辅助函数(tokenizer_catalog)
| 函数签名 | 返回类型 | 说明 |
|---|---|---|
apply_text_analyzer_for_custom_model(text TEXT, text_analyzer_name TEXT) |
TEXT[] |
调用 text_analyzer_name 分词,并在写入自定义模型词表前自动过滤掉长度超过 2600 字节(PostgreSQL B-tree UNIQUE 索引键最大长度限制)的超长词元。 |
custom_model_insert_trigger() |
trigger |
AFTER INSERT OR UPDATE 触发器函数,从源文本列提取词元并将新出现的词元自动追加写入 tokenizer_catalog."model_<name>" 词表。 |
custom_model_tokenizer_set_target_column_trigger() |
trigger |
由 create_custom_model_tokenizer_and_trigger 安装的 BEFORE INSERT OR UPDATE 触发器函数,自动执行 NEW.<target_column> = tokenize(NEW.<source_column>, tokenizer_name)。 |
pg_tokenizer 元数据表(tokenizer_catalog)
| 表名 | 列定义 | 说明 |
|---|---|---|
tokenizer_catalog.tokenizer |
name TEXT NOT NULL UNIQUE, config TEXT NOT NULL |
存储已注册的分词器名称及其序列化后的 JSON/TOML 配置。 |
tokenizer_catalog.text_analyzer |
name TEXT NOT NULL UNIQUE, config TEXT NOT NULL |
存储独立命名且可复用的文本分析器定义。 |
tokenizer_catalog.model |
name TEXT NOT NULL UNIQUE, config TEXT NOT NULL |
存储已注册的自定义模型、HuggingFace 模型与 Lindera 模型定义。 |
tokenizer_catalog.stopwords |
name TEXT NOT NULL PRIMARY KEY, config TEXT NOT NULL |
存储内置(lucene_english、nltk_english、iso_english)及自定义停用词典。 |
tokenizer_catalog.synonym |
name TEXT NOT NULL PRIMARY KEY, config TEXT NOT NULL |
存储自定义同义词典。 |
tokenizer_catalog."model_<name>" |
id SERIAL PRIMARY KEY, token TEXT NOT NULL UNIQUE |
为每个自定义模型 <name> 自动创建的底层词表数据表,将唯一归一化词元映射为从 1 开始的自增整数 ID。 |
pg_tokenizer TOML 配置参数参考
分词器配置项(create_tokenizer)
| 参数名 | 类型 | 说明 |
|---|---|---|
text_analyzer |
string(可选) |
预先创建的命名 text_analyzer 名称。若省略,可在支持文本分析器的模型中直接内联定义 character_filters、pre_tokenizer 和 token_filters。 |
model |
string(必填) |
内置模型(llmlingua2、bert_base_uncased、wiki_tocken、gemma2b)或用户创建的模型(custom、huggingface、lindera)名称。 |
文本分析器配置项(create_text_analyzer)
| 参数名 | 类型 | 说明 |
|---|---|---|
character_filters |
array / table |
在分词前对整段字符串依次应用的字符过滤器列表:to_lowercase、unicode_normalization(nfc、nfd、nfkc、nfkd)。 |
pre_tokenizer |
string / table |
将字符串切分为初始词元的单个预分词器:unicode_segmentation、regex(Rust 正则表达式)或 jieba(mode = "full" | "precise" | "search",enable_hmm = true | false)。 |
token_filters |
array |
按顺序执行的词元过滤器列表:skip_non_alphanumeric、stemmer(支持 30 种 Snowball 词干提取器)、stopwords(内置 lucene_english、nltk_english、iso_english 或自定义停用词典)、synonym、pg_dict(除 Thesaurus 外的任意 pg_ts_dict 词典)、ngram(min_gram、max_gram 范围 1..=255,preserve_original)。 |
自定义模型配置项(create_custom_model)
| 参数名 | 类型 | 说明 |
|---|---|---|
table |
string(必填) |
包含源文本语料的目标表名称。 |
column |
string(必填) |
table 表中用于构建词表的源 TEXT 列名称。 |
text_analyzer |
string(必填) |
用于将 column 列切分为词表词元的 text_analyzer 名称。 |
3.2 - GUC 与索引参数
vchord_bm25 会话级 GUC 参数与索引存储选项的完整参考手册。
重要
当前源码面向 0.4.0(尚未发布),使用原生 tsvector 和新的索引格式。标注 0.3.x 的 bm25vector 示例仅适用于旧版。两者不能原地升级;请先阅读0.4.0 迁移指南。
稳定发布版(v0.1.0 – v0.3.0):bm25_catalog.* GUC 参数
在 v0.1.0 至 v0.3.0 版本中,所有会话级 GUC 参数均使用 bm25_catalog. 前缀,任何普通用户均可在会话或事务级别修改(GucContext::Userset):
| 参数名称 | 类型 | 默认值 | 有效范围 | 说明 |
|---|---|---|---|---|
bm25_catalog.bm25_limit |
integer |
100 |
-1 .. 65535 |
单次 bm25 索引扫描返回的高分文档最大数量。设为 -1 时禁用 Block-WeakAnd 剪枝并执行全量暴力扫描;设为 0 时直接返回空结果。必须 SQL 查询中的 LIMIT 值。 |
bm25_catalog.enable_index |
boolean |
true |
true / false |
在 PostgreSQL 查询规划器中启用或禁用 bm25 索引扫描。设为 false 可强制执行顺序扫描并调用 search_bm25query 精确求值。 |
bm25_catalog.enable_prefilter |
boolean |
true |
true / false |
自 v0.2.2 引入。设为 true 时,会在将候选文档推入 Block-WeakAnd Top-K 最小堆之前,先行过滤掉不满足查询过滤条件或 MVCC 可见性检查的文档。 |
bm25_catalog.segment_growing_max_page_size |
integer |
4096 |
1 .. 1000000 |
仅追加的增长段(Growing Segment)在被封存为差分位打包压缩的只读封闭段(Sealed Segment)之前的最大尺寸(以 8 KB 页面为单位,默认值 4096 即 32 MB)。 |
配置示例(v0.1 – v0.3)
新一代 main 分支:bm25.* GUC 参数与索引存储参数
在 main 分支重构版本中,会话级 GUC 参数改用 bm25. 前缀,并与每个索引独立的存储参数(WITH (...))配合工作:
会话级 GUC 参数(main)
| 参数名称 | 类型 | 默认值 | 有效范围 | 说明 |
|---|---|---|---|---|
bm25.enable_scan |
boolean |
true |
true / false |
在查询规划器中启用或禁用 bm25 索引扫描。 |
bm25.limit |
integer |
0 |
0 .. 65535 |
最大候选数。显式设置的值覆盖索引参数,显式零值会使索引扫描报错。RESET 才恢复索引回退值。 |
bm25.prefilter |
boolean |
false |
true / false |
在 bm25 索引扫描期间启用预过滤(显式设置时覆盖索引自身的 prefilter 存储参数,包括 false)。 |
postgresql.conf、ALTER DATABASE、ALTER ROLE 或客户端启动选项中的设置也会覆盖索引参数。RESET 会恢复这些配置默认值;只有 GUC 来源恢复为内置默认值时,才会回退到索引参数。
索引存储参数(main 中的 WITH (...))
| 存储参数 | 类型 | 默认值 | 有效范围 | 说明 |
|---|---|---|---|---|
options |
string (TOML) |
k1 = 1.2, b = 0.75 |
k1: 1.2..2.0b: 0.0..1.0 |
用于配置该索引 Okapi BM25 超参数 与 的 TOML 字符串。 |
limit |
integer |
0 |
0 .. 65535 |
当 bm25.limit 保持默认来源(RESET)时使用的索引级回退检索上限,显式零值不触发回退。 |
prefilter |
boolean |
false |
true / false |
索引级的默认预过滤设置。 |
3.3 - 性能与精度基准测试
VectorChord-BM25 与 Elasticsearch、Lucene、ParadeDB 及 PostgreSQL GIN 的 QPS 吞吐量与 NDCG@10 检索精度对比基准测试。
吞吐量基准测试(QPS 对比 Elasticsearch、Lucene、ParadeDB、PG GIN)
凭借结合 128 文档差分位打包块与单字节 Fieldnorm 量化的 Block-WeakAnd 算法实现,VectorChord-BM25 在 Top-10 排序查询上的 QPS 吞吐量最高可达基于 Tantivy 的 PostgreSQL 扩展(ParadeDB / pg_search)的 3 倍,并比 PostgreSQL 原生 GIN 索引高出一个数量级:
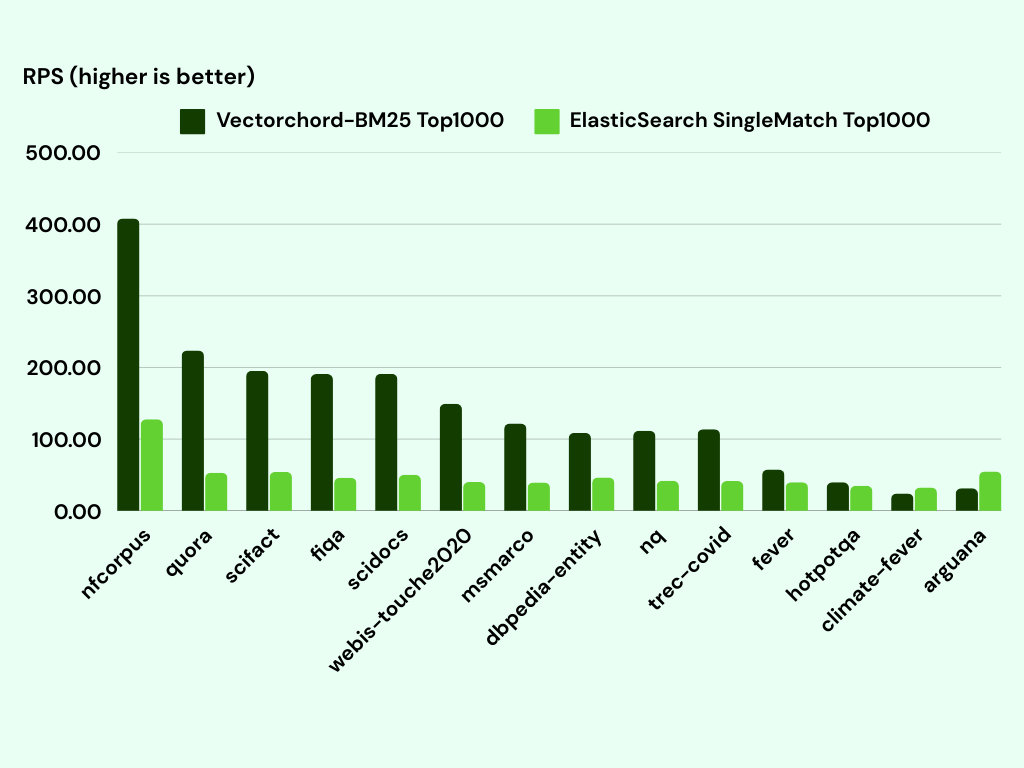
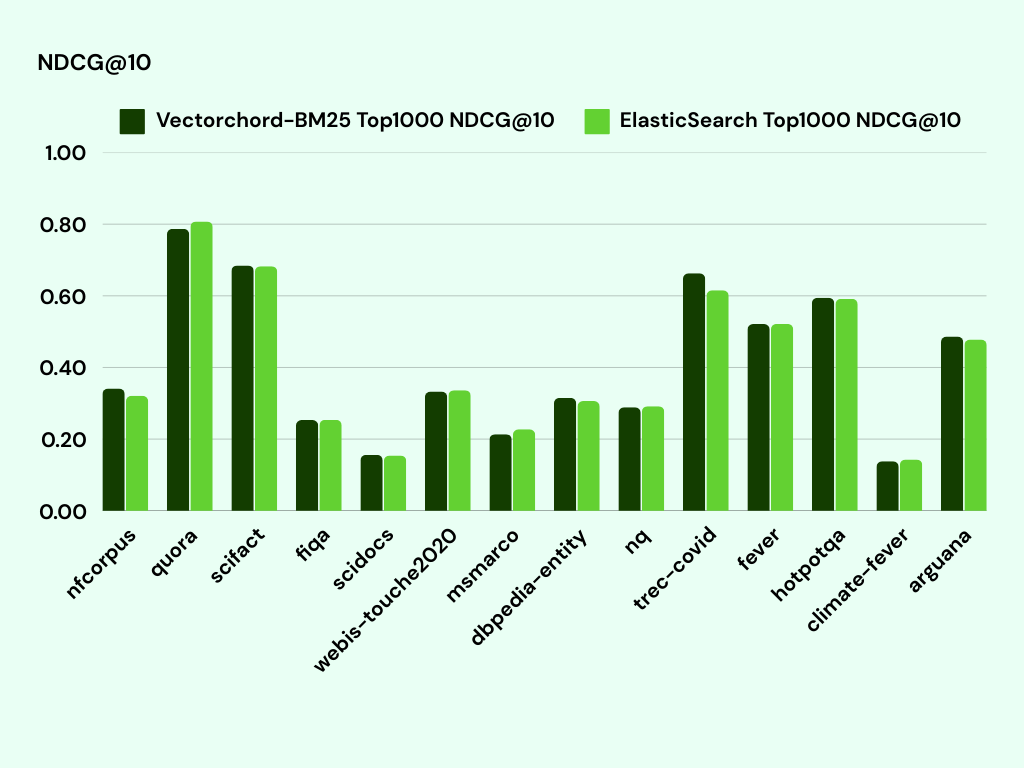
为什么 vchord_bm25 能实现极高的 QPS
- 零跨引擎序列化开销:不同于外部数据包装器(FDW)或外挂 Tantivy/Lucene 桥接方案,
vchord_bm25将段数据直接存储在 PostgreSQL 缓冲池页面(PostgresRelation)中,彻底消除了跨引擎元组编组(Marshaling)开销。 - 激进的块级上界剪枝(Block-Max Pruning):在多词查询场景下,一旦 Top-10 阈值趋于稳定,Block-WeakAnd 即可直接跳过 80%–95% 以上的 128 文档倒排块,无需对其进行解压。
- 256 项预计算 BM25 查找表:将文档长度量化为单字节
fieldnorm,使原本昂贵的逐文档浮点运算简化为单次数组查表。
检索精度基准测试(BEIR 与 LoTTE 上的 NDCG@10)
下表(摘自我们的 BEIR / LoTTE 混合检索与 ColBERT 重排序评测报告)对比了以下三种方案的检索精度(NDCG@10):
- PostgreSQL
vchord稠密向量检索(Vector) - PostgreSQL
vchord_bm25词法检索(BM25) - 混合检索(
vchord+vchord_bm25配合 ColBERT 重排序)
| 数据集 | 领域 | 稠密向量 (vchord) |
词法 BM25 (vchord_bm25) |
混合检索 + ColBERT 重排序 |
|---|---|---|---|---|
| scifact | 科学事实核查 | 0.676 | 0.665 | 0.751 |
| nfcorpus | 生物医学信息检索 | 0.340 | 0.325 | 0.370 |
| fiqa | 金融问答 | 0.405 | 0.236 | 0.415 |
| trec-covid | 生物医学 COVID-19 | 0.728 | 0.656 | 0.838 |
| LoTTE-lifestyle (search) | 生活方式问答(搜索) | 0.735 | 0.635 | 0.779 |
| LoTTE-lifestyle (forum) | 生活方式论坛 | 0.662 | 0.506 | 0.701 |
| LoTTE-recreation (search) | 休闲娱乐问答 | 0.642 | 0.564 | 0.708 |
| LoTTE-technology (search) | 技术问答 | 0.562 | 0.483 | 0.647 |
| LoTTE-writing (search) | 写作问答 | 0.726 | 0.674 | 0.793 |
提示
在所有评测数据集上,将 vchord_bm25 与 vchord 结合使用均稳定超越单独使用稠密向量检索或单独使用词法 BM25 检索。如需获取开箱即用的 SQL 查询模板,请参阅混合检索 (BM25 + VectorChord)。
3.4 - 迁移到 0.4.0
vchord_bm25 0.4.0 的原生 tsvector API、安装模式、访问权限与迁移边界。
当前 pgsty/vchord_bm25 源码面向 0.4.0(尚未发布),使用 PostgreSQL 原生 tsvector 和新的索引存储引擎。历史 0.3.x 软件包与套件镜像使用 bm25vector,两者的 API 与索引格式均不兼容。
| 接口 | 0.3.x | 0.4.0 / 当前源码 |
|---|---|---|
| 文档值 | bm25vector,保存整数词元 ID 与词频 |
带位置的 tsvector |
| 查询构造函数 | to_bm25query(index, vector) |
to_bm25query(vector, index) |
| 查询字段 | (index_oid regclass, query_vector bm25vector) |
(vector tsvector, index regclass) |
| 得分类型 | real |
double precision |
| 模式 | 固定为 bm25_catalog |
安装时选择的扩展模式,可迁移 |
| 候选数上限 | bm25_catalog.bm25_limit,默认 100 |
bm25.limit 或索引 limit,两层默认均为零 |
| 文本分析 | pg_tokenizer 整数数组 |
to_tsvector,或输出带位置向量的兼容分词器 |
当前构建使用从 Rust 动态库生成的 vchord_bm25--0.4.0.sql。打包时会比对检入的 SQL 与编译后的接口,遇到不一致即报错。Git 中保留的旧版安装 SQL 对应旧版动态库;把控制文件版本改成 0.3.0 并不能让新引擎兼容旧接口。
安装与查询
使用 PG_CONFIG=/path/to/pg_config make build 与 PG_CONFIG=/path/to/pg_config make install 编译安装当前源码。将 vchord_bm25 加入 shared_preload_libraries 并重启 PostgreSQL。标准文本检索无需外部分词器:
索引通过文档位置计算词频,strip(tsvector) 与 array_to_tsvector 无法提供这些信息。文档与查询应使用相同的分析器。整数词元 ID 不等于词素,因此没有自动的 bm25vector 到 tsvector 转换。
显式执行 SET "bm25.limit" = 100 会覆盖索引上限;RESET "bm25.limit" 才会恢复索引设置。显式零值会使扫描报错,不表示使用索引默认值或不限结果数。两层默认值均为零,因此必须设置一个正值。bm25.prefilter 同样根据设置来源决定优先级,显式 false 也会覆盖索引参数。SQL LIMIT 不会设置这些 GUC。
postgresql.conf、ALTER DATABASE、ALTER ROLE 或客户端启动选项中的设置也会覆盖索引参数。RESET 会恢复这些配置默认值;只有 GUC 来源恢复为内置默认值时,才会回退到索引参数。
模式访问权限
DBA 可以把扩展安装到为应用选择的模式中:
这是安装到 public 的替代方案,不要在同一数据库执行两次安装。表的访问权限需要单独授予。PostgreSQL 默认向 PUBLIC 授予函数执行权限;若部署环境撤销了该默认授权,还需显式授予所需函数的权限。即使 search 不在 search_path 中,仍可通过 search.to_bm25query(...) 调用构造函数,迁移扩展模式后也如此。
迁移已有数据
从 0.3.0 执行 ALTER EXTENSION vchord_bm25 UPDATE TO '0.4.0' 会在修改对象前主动报错。该脚本不会重写旧索引,也不会删除依赖扩展的应用数据。
- 保留旧数据库与旧动态库。盘点
bm25vector列、索引、视图、函数和分词触发器;在旧类型仍可读取时导出原始文本与应用数据。 - 在另一套 PostgreSQL 安装与新数据库中安装 0.4.0。同一套 PostgreSQL 下的数据库共享扩展动态库,不能在仍有数据库使用 0.3.x 时直接替换文件。
- 恢复原始文本,生成
tsvector,重建所有 BM25 索引,并设置正值候选数上限。复制旧索引文件或对bm25vector列执行普通REINDEX均不能完成 API 迁移。 - 更新构造函数参数顺序、数据类型、GUC 名称与分词触发器。比较排序质量与查询结果后再切换应用。
站点继续保留 0.3.x 的 pg_tokenizer 整数数组工作流。对于 0.4.0,在所部署的分词器明确支持兼容的 tsvector 输出前,请使用 to_tsvector。
3.5 - 版本历史与 API 演进
VectorChord-BM25 (vchord_bm25) 从 v0.1.0 到 v0.3.0 再到 main 分支的版本变更日志与 SQL 模式演进。
重要
当前源码面向 0.4.0(尚未发布),使用原生 tsvector 和新的索引格式。标注 0.3.x 的 bm25vector 示例仅适用于旧版。两者不能原地升级;请先阅读0.4.0 迁移指南。
本页记录 vchord_bm25(pgsty/vchord_bm25 / supervc-stack/VectorChord-bm25)的版本发布历史与 SQL 模式演进。
版本演进总览矩阵
| 版本 | 所属模式 | 索引列类型 | 分词方案 | 核心新增特性 |
|---|---|---|---|---|
0.4.0 / main(尚未发布) |
扩展所在模式 | tsvector |
原生 to_tsvector(或自定义) |
基于原生 tsvector 完全重写存储与索引引擎;支持外部排序并行构建(ambuild);引入索引级存储参数(options、limit、prefilter);引入 bm25.* GUC 参数;支持 PostgreSQL 18。 |
v0.3.0 |
bm25_catalog |
bm25vector |
pg_tokenizer |
新增 bm25_page_inspect(regclass, int) 函数、to_bm25query(regclass, int[]) 重载,以及 PostgreSQL 18 兼容性支持。 |
v0.2.2 |
bm25_catalog |
bm25vector |
pg_tokenizer |
新增 bm25_catalog.enable_prefilter GUC 参数,支持带 WHERE 子句的精确过滤 Top-K BM25 检索。 |
v0.2.1 |
bm25_catalog |
bm25vector |
pg_tokenizer |
修复增长段(Growing)向封闭段(Sealed)转换以及 VACUUM 清理过程中的若干缺陷。 |
v0.2.0 |
bm25_catalog |
bm25vector |
pg_tokenizer |
为 bm25vector 新增 = 与 <> 相等性操作符,以及隐式类型转换 CREATE CAST (int[] AS bm25vector) AS IMPLICIT。 |
v0.1.1 |
bm25_catalog |
bm25vector |
pg_tokenizer |
将分词能力解耦为独立的 pg_tokenizer 扩展;调整 to_bm25query(regclass, bm25vector) 函数签名。 |
v0.1.0 |
bm25_catalog |
bm25vector |
内置 unicode |
首个发布版本,提供 bm25vector、bm25query、USING bm25 及 Block-WeakAnd Top-K 扫描。 |
各版本升级变更详解
v0.3.0(sql/vchord_bm25--0.2.2--0.3.0.sql)
- 新增页面诊断函数:
- 在
main/0.3.x后期版本中新增了直接接受int[]的便捷重载to_bm25query(regclass, int[])。
v0.2.2(sql/vchord_bm25--0.2.1--0.2.2.sql)
- 在 Block-WeakAnd 中新增预过滤支持(
bm25_catalog.enable_prefilterGUC 参数,在0.3.0中默认启用)。 - 改进索引扫描期间的 MVCC 可见性检查,防止死元组(Dead Tuples)或被过滤元组污染 Top-K 剪枝阈值。
v0.2.0(sql/vchord_bm25--0.1.1--0.2.0.sql)
- 为
bm25vector新增=与<>操作符。 - 新增从
int[]到bm25vector的隐式类型转换(_vchord_bm25_cast_array_to_bm25vector),允许将tokenize(text, name)的输出(INT[])直接赋值给bm25vector列或传入任何接受bm25vector的位置。
v0.1.1(sql/vchord_bm25--0.1.0--0.1.1.sql)
- 将原本内置的
create_tokenizer/tokenize函数抽离为独立的pg_tokenizer扩展(tokenizer_catalog),从而支持丰富的文本分析器、Snowball 词干提取、停用词、同义词、HuggingFace 模型、jieba中文分词与lindera日文分词。 - 简化
to_bm25query(index_oid regclass, query_vector bm25vector)签名,直接接受bm25vector参数。
新一代架构重写(main 分支)
- 用 PostgreSQL 原生
tsvector替代自定义bm25vector类型(CREATE OPERATOR CLASS bm25_ops FOR TYPE tsvector USING bm25),允许用户直接使用USING bm25为to_tsvector(...)列建立索引。 - 新增基于外部归并排序(External Merge Sort)的并行索引构建(
bm25_parallel_build_main),保证恒定的维护内存消耗。 - 支持通过
WITH (options = $$ k1 = 1.2, b = 0.75 $$)配置索引级 BM25 超参数(,)。