1 - 概览
vchord 是一款专为可扩展、高性能且磁盘高效的向量相似性检索而设计的 PostgreSQL 扩展。
借助 vchord,您仅需 1 美元即可存储 400,000 个向量,从而显著节省成本:在同等价格下,可存储的向量数量是 Pinecone 优化型存储的 6 倍,是 pgvector/pgvecto.rs 的 26 倍1。欲了解更多详情,请参阅我们的发布博文。
核心特性
相较于 pgvecto.rs 和 pgvector,vchord 带来了显著的增强:
⚡ 性能大幅提升:与 pgvector 的 HNSW 实现相比,经过全面优化的操作可提供最高 5 倍的查询加速、16 倍的写入吞吐量提升,以及 16 倍的索引构建提速1。
💰 高性价比向量检索:仅需 32GB 内存即可查询 1 亿条 768 维向量,在保持 Top-10 召回率达 95% 的同时实现 35ms 的 P50 延迟,助您在保障高质量检索的同时大幅降低基础设施成本。
🔌 无缝集成:完全兼容 pgvector 的数据类型与语法,并提供开箱即用的最优默认配置——无需手动调优参数。只需直接引入 vchord,即可获得性能跃升。
🔧 加速索引构建:支持利用 IVF 在外部(例如 GPU 上)构建索引以加快 KMeans 聚类速度,并结合 RaBitQ2 压缩算法高效存储向量,同时通过自适应重排序(reranking)确保检索质量。
📏 超长向量支持:支持存储和检索最高达 60,0003 维的向量,让您轻松使用 text-embedding-3-large 等顶尖高维模型。
🌐 按需灵活扩展:基于水平扩展架构,针对 500 万或 1 亿条 768 维向量的查询可轻松扩展至 10,000+ QPS(Top-10 召回率达 90%),且具备极具竞争力的成本优势4。
快速开始
对于新用户,我们推荐使用 Docker 镜像快速上手。如果您倾向于不使用 Docker,请参阅安装指南了解其他安装方式。
除了包含 VectorChord 扩展的基础镜像外,我们还提供了全合一镜像
tensorchord/vchord-suite:pg18-latest。该综合镜像包含了所有官方 TensorChord 扩展。开发者应根据支持矩阵选择与所需扩展版本兼容的镜像标签。
随后,您可以使用 psql 命令行工具连接到数据库。默认用户名为 postgres,默认密码为 mysecretpassword。
现在,您可以开始体验 VectorChord 了!
VectorChord 依赖于 pgvector(包括其向量数据表示形式)。由于您可以直接使用它们,您的应用程序可以毫无痛点地轻松完成迁移!
与 pgvector 类似,您可以创建一张包含向量列的表,并向其中插入一些数据。
借助 VectorChord,您可以创建 vchordrq 索引:
然后使用 SELECT ... ORDER BY ... LIMIT ... 执行向量检索:
欲了解更多用法,请阅读:
开源许可
vchord 采用 GNU Affero 通用公共许可证 v3.0(AGPL-3.0-only) 发布。我们欢迎任何商业合作或支持咨询,如有任何问题或需求,请发送邮件至 [email protected]。
-
基于 MyScale Benchmark 测试(768 维向量,95% 召回率)。更多详情请参阅我们的博文。 ↩︎ ↩︎
-
Gao, Jianyang, and Cheng Long. “RaBitQ: Quantizing High-Dimensional Vectors with a Theoretical Error Bound for Approximate Nearest Neighbor Search.” Proceedings of the ACM on Management of Data 2.3 (2024): 1-27. ↩︎
-
目前 pgvector 存在 16,000 维的限制。如果您确实需要处理更高维度的向量(
16,000<dim<60,000),可以考虑修改 VECTOR_MAX_DIM 并自行编译 pgvector。 ↩︎ -
更多详情请参阅我们的博文,其中 PostgreSQL 的水平扩展能力由 CloudNative-PG 提供支持。 ↩︎
2 - 安装指南
VectorChord 已在以下操作系统上通过测试:
- Ubuntu (x86_64, aarch64)
- macOS (x86_64, aarch64)
- Windows (x86_64)
- Alpine Linux (x86_64, aarch64) 1
- Debian (powerpc64le, s390x, riscv64) 2
如果您在上述任何操作系统上遇到问题,请提交 Bug 报告;如果您需要更多平台支持,欢迎提交功能请求。
Docker
VectorChord 镜像

体验 VectorChord 最简便的方式是直接运行开箱即用的 Docker 镜像。
- 在 Docker 中启动 VectorChord 容器。
- 使用
psql命令行工具连接到数据库。默认用户名为postgres。
- 执行以下 SQL 语句以确保扩展已启用。
为了充分发挥性能,请通过添加如下参数将数据卷挂载到 PostgreSQL 数据目录:
- 在 PostgreSQL 18 上:
-v $PWD/pgdata:/var/lib/postgresql/18/docker - 在 PostgreSQL 14、15、16 和 17 上:
-v $PWD/pgdata:/var/lib/postgresql/data
您可以参考基础父镜像的说明文档(https://hub.docker.com/_/postgres/)来配置 PostgreSQL。
VectorChord Suite 镜像

除了仅包含 VectorChord 扩展的基础镜像外,我们还提供了全合一镜像 tensorchord/vchord-suite:pg18-latest。该综合镜像包含了所有官方 TensorChord 扩展。开发者应根据支持矩阵选择与所需扩展版本兼容的镜像标签。
- 在 Docker 中启动 VectorChord 容器。
其余步骤与上文一致。
VectorChord Scratch 镜像

我们提供了一个仅包含 VectorChord 相关文件的 scratch 镜像。您可以使用 Docker 的 COPY 指令将 VectorChord 安装到任何镜像中,例如:
该镜像同样可以作为 CloudNativePG 的镜像卷扩展(Image Volume Extension)使用。另请参阅:
源码编译
编译环境要求:
- 任意版本的
make clang >= 16及libclangrust >= 1.93及cargo
在大多数平台上推荐使用 Rustup 安装 Rust,而在 Alpine Linux 上则建议使用系统包管理器安装。
您可以设置环境变量 CC 来为构建系统指定所需的 C 编译器。如果不设置该变量,构建系统会自动搜索 clang 和 gcc。若要使用 clang 编译所有 C 代码,请将 CC 设置为 clang 的路径;若要使用 gcc 编译所有 C 代码,请将 CC 设置为 gcc 的路径(注意:此时要求 gcc >= 14)。
Rust 版本要求并非长期不变的承诺;我们会在每次发布新版本时上调所需的最低 Rust 版本。
上述编译要求仅适用于 x86_64 和 aarch64 架构。对于包括 powerpc64le、s390x 和 riscv64 在内的所有其他架构,均需要使用 nightly 版本的 Rust 以及最新版本的 Clang。
如果您尚未安装 PostgreSQL,请先安装 PostgreSQL。如果您尚未安装 pgvector,可以在执行第 3 步之前安装 pgvector。
- 下载源码,并使用
make进行编译和安装。
- 修改
shared_preload_libraries以加载该扩展来配置 PostgreSQL,然后重启 PostgreSQL 集群。
- 执行以下 SQL 语句以确保扩展已启用。
编译调优
VectorChord 会针对 SIMD 代码执行运行时 CPU 指令集分发(runtime CPU dispatch)。如果您希望编译器针对特定 CPU 对整个程序进行优化,可以指示编译器为该特定 CPU 生成代码。
若要查看当前目标平台(target triple)支持的所有有效 CPU 选项及默认 CPU,请运行:
若要针对当前宿主机生成优化代码,请运行:
请注意,指定特定 target-cpu 生成的二进制文件与其他型号的 CPU 不兼容。
您也可以通过 Cargo 配置文件来完成此设置:
Debian
如果您尚未安装 PostgreSQL,请参照 https://www.postgresql.org/download/linux/debian/ 进行安装。如果您尚未安装 pgvector,可以在执行第 3 步之前通过 apt install postgresql-18-pgvector 进行安装。
VectorChord 的新版本发布托管于 github.com/pgsty/vchord/releases,而历史版本(1.1.1 及更早版本)仍可在 github.com/tensorchord/VectorChord/releases 获取。
- 在发布页面下载 Debian 软件包,并通过
apt进行安装。
- 修改
shared_preload_libraries以加载该扩展来配置 PostgreSQL,然后重启 PostgreSQL 集群。
- 执行以下 SQL 语句以确保扩展已启用。
Ubuntu
如果您尚未安装 PostgreSQL,请参照 https://www.postgresql.org/download/linux/ubuntu/ 进行安装。如果您尚未安装 pgvector,可以在执行第 3 步之前通过 apt install postgresql-18-pgvector 进行安装。
VectorChord 的新版本发布托管于 github.com/pgsty/vchord/releases,而历史版本(1.1.1 及更早版本)仍可在 github.com/tensorchord/VectorChord/releases 获取。
- 在发布页面下载 Debian 软件包,并通过
apt进行安装。
- 修改
shared_preload_libraries以加载该扩展来配置 PostgreSQL,然后重启 PostgreSQL 集群。
- 执行以下 SQL 语句以确保扩展已启用。
PGXN
编译环境要求请参阅源码编译。
如果您尚未安装 PostgreSQL,请先安装 PostgreSQL。如果您尚未安装 pgvector,可以在执行第 3 步之前通过 pgrxclient install vector 进行安装。
- 使用以下命令从 PostgreSQL Extension Network (PGXN) 安装 VectorChord:
- 修改
shared_preload_libraries以加载该扩展来配置 PostgreSQL,然后重启 PostgreSQL 集群。
- 执行以下 SQL 语句以确保扩展已启用。
PGXN 上的 VectorChord 0.4.1 软件包存在问题,请勿使用。请改用 0.4.2 或更高版本。
预编译二进制文件
deprecated预编译二进制文件可能与您机器上安装的 PostgreSQL 存在 ABI 不兼容,这可能会导致静默错误。在此情况下,我们强烈建议您从源码进行编译。
如果您尚未安装 PostgreSQL,请先安装 PostgreSQL。如果您尚未安装 pgvector,可以在执行第 3 步之前安装 pgvector。
- 在发布页面下载预编译二进制文件,并参考您所用发行版的文档重新打包,然后通过系统包管理器进行安装。虽然我们不建议这样做,但如果您需要,也可以直接将文件手动复制到系统目录中:
- 修改
shared_preload_libraries以加载该扩展来配置 PostgreSQL,然后重启 PostgreSQL 集群。
- 执行以下 SQL 语句以确保扩展已启用。
3 - Vchord 家族套件
检索增强生成(Retrieval-Augmented Generation,简称 RAG)正在彻底改变我们与海量数据集及大语言模型的交互方式。通过在生成回答前检索相关信息,RAG 系统能够提供更加精准、具备上下文感知且时效性更强的答案。然而,构建稳健、可扩展且高效的 RAG 流水线依然面临诸多挑战,在生产环境中尤为如此。
许多现有方案采用了复杂的架构,分别使用不同的专用数据库来处理向量检索、关键词检索和主数据存储。这往往会导致数据同步困难、基础设施复杂度上升以及运维成本居高不下。
如果能够直接在您信赖的 PostgreSQL 数据库中构建强大且达到生产级标准的 RAG 系统,会怎样呢?
为此,我们推出了 Vchord 家族套件(Vchord Suite)——这是一套专为将高性能向量检索、原生 BM25 排序以及灵活的分词能力直接引入 Postgres 而设计的 PostgreSQL 扩展套件。下面让我们一起探索其核心组件,以及它们如何赋能下一代 RAG 解决方案。
什么是 Vchord 家族套件?
该套件由三个协同工作的核心 PostgreSQL 扩展组成:
-
vchord(pgsty/vchord): 核心向量检索引擎,专为在 PostgreSQL 内部实现可扩展、高性能且高磁盘效率的向量相似性检索而设计。 -
vchord_bm25(pgsty/vchord_bm25): 该扩展利用高效的 Block-WeakAnd 算法,直接在 PostgreSQL 内部实现了成熟的 BM25 排序算法。BM25 是基于关键词词频与文档特征进行相关性排序的行业标准。 -
pg_tokenizer(pgsty/pg_tokenizer): 提供高效全文检索所需的核心文本分词能力,支持对全文检索中的文本处理流程进行细粒度控制。
通过组合这些扩展,您可以完全在 PostgreSQL 内部解锁构建高级 RAG 系统的强大能力。
如何使用 Vchord 家族套件
您可以使用 tensorchord/vchord-suite Docker 镜像来运行由 TensorChord 提供的多个扩展。该镜像基于 Docker 官方 PostgreSQL 镜像构建,并内置了以下扩展:
vchordpg_tokenizervchord_bm25vector
Vchord 家族套件的应用场景
场景 1:基于原生 BM25 与 vchord 的强大混合检索
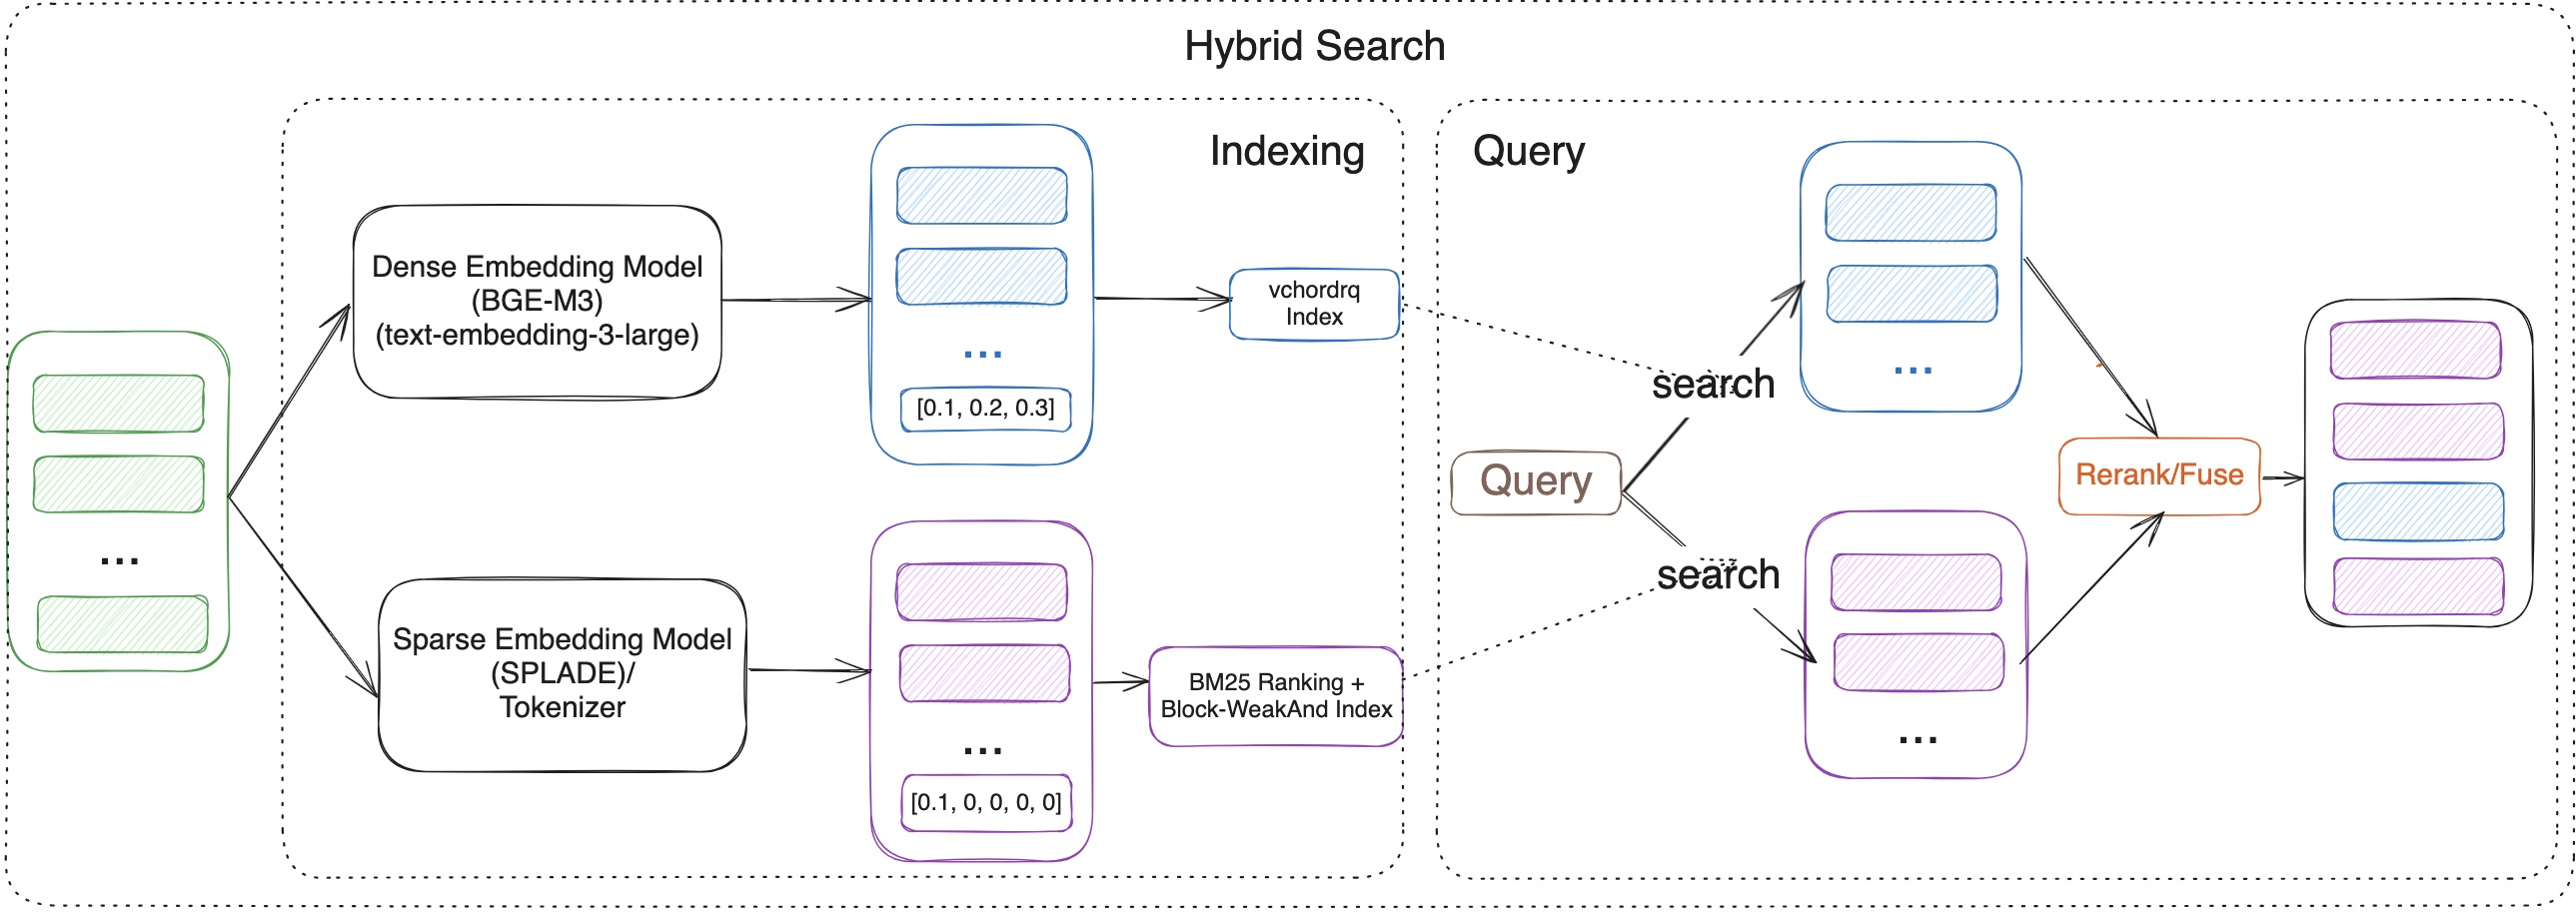
在 RAG 时代,高效的检索至关重要。无论是单纯的关键词检索还是单纯的向量检索,都并非完美无缺:
-
关键词检索(如 BM25): 擅长精确匹配,能够找出包含确切关键词的文档,非常适合结构化查询和特定术语检索。然而,它在处理同义词、改写表述以及理解潜在语义或意图方面表现欠佳。(基于
vchord_bm25与pg_tokenizer实现)。 -
向量检索: 能够捕捉深层语义信息及概念间的关联,即使查询中未出现完全一致的关键词,也能找到相关信息。但在面对要求精确匹配特定术语的查询时,其精度有时会略显不足。(基于
vchord实现)。
解决方案:混合检索(Hybrid Search)。 通过在 PostgreSQL 内部结合这两种方法的优势,Vchord 家族套件完美弥补了这一鸿沟。您可以在查询中同时利用:
-
vchord_bm25(由pg_tokenizer驱动)实现关键词精确匹配。 -
vchord实现深层语义理解。
随后,可以将两者的检索结果进行智能融合(例如使用倒数排序融合 RRF,或基于模型的重排序),从而生成比任何单一方法都更加准确、上下文相关且具备语义感知的最终排序。这将为您的 RAG 应用带来显著的检索性能提升。
场景 2:超越纯文本——基于 ColQwen2 与 vchord 的免 OCR RAG
为 PDF 或扫描图像等文档构建 RAG 系统通常涉及繁琐的预处理流水线。传统方法高度依赖光学字符识别(OCR)和版面分析来提取文本。这一过程往往存在以下弊端:
-
速度缓慢: OCR 的计算开销通常非常高昂。
-
容易出错: OCR 的准确率受文档质量影响极大。
-
信息有损: 表格、图表、排版格式以及相对位置等关键视觉上下文信息,往往会在文本提取过程中丢失。
解决方案:免 OCR、具备视觉感知的 RAG。 如果您无需显式执行 OCR,就能直接根据文档的视觉外观及其内容进行查询,会怎样呢?
现在,通过结合以下两项技术即可实现这一目标:
-
多模态视觉语言模型(VLM): 诸如 ColQwen2 等模型可以直接处理图像(文档页面),并生成同时捕捉文本内容与视觉版面信息的嵌入向量(Embeddings)。
-
vchord的多向量检索能力:vchord可以在 PostgreSQL 中高效地为每篇文档存储和检索多个向量——允许您存储代表文档不同维度的嵌入表示(例如文本内容与视觉布局)。
借助这一方案,您可以直接在 PostgreSQL 中使用提及视觉元素的提示词(如“查找包含对比销售数据的柱状图的文档”)或结合图文线索的查询来检索文档数据库。这不仅简化了您的 RAG 技术栈,还通过保留视觉上下文提升了检索准确率,并彻底消除了传统 OCR 流水线的性能瓶颈。
为什么在 PostgreSQL 中构建 RAG?
在 PostgreSQL 中使用 Vchord 家族套件具有显著优势:
-
数据统一: 将源数据、文本、元数据和向量嵌入统一保存在同一个数据库中。
-
降低复杂度: 无需维护独立的向量数据库及复杂的数据同步流水线。
-
复用现有基础设施: 充分利用您现有的 PostgreSQL 专业经验、工具链和运维体系。
-
事务完整性: 受益于 PostgreSQL 强大的 ACID 事务保障。
-
丰富的生态系统: 无缝接入 PostgreSQL 生态系统中种类繁多的工具与特性。
总结
Vchord 家族套件将 PostgreSQL 打造成了一个强大且达到生产级标准的平台,用于构建高级 RAG 解决方案。通过集成高性能向量检索(vchord)、成熟的关键词排序(vchord_bm25)以及灵活的文本处理(pg_tokenizer),您可以直接在数据库内部实现混合检索与免 OCR 多模态检索等前沿技术。在 PostgreSQL 中借助 Vchord 简化系统架构、提升检索精度,并充分释放 RAG 的全部潜能。
相关博文
在近期的博文中,我们分享了多个实际应用案例,其中所有的 Docker 镜像均可以直接替换为 VectorChord Suite 镜像: