预过滤
在带过滤条件的索引扫描中,预过滤(Prefilter)允许向量索引在计算向量距离之前先评估过滤条件,从而剪枝搜索空间并提升查询效率。
在带过滤条件的索引扫描中,通常索引会先执行扫描,然后由 PostgreSQL 检查返回行是否满足过滤条件。在本页中,“过滤条件(filter)”是指 PostgreSQL 查询计划中索引扫描节点上的 Filter,它通常由 SQL 语句中的 WHERE 子句构造而成,并且不需要具备特定的形式。
然而,对于向量搜索而言,这种方式并不总是最高效的。请看下面这个查询:
为了检索出 个满足过滤条件的向量,索引大约返回了 行数据。这意味着索引执行了大量冗余计算。如果索引能够利用过滤条件进行剪枝,计算量将会大幅减少。为此,向量索引提供了 GUC 参数 vchordrq.prefilter,允许根据过滤条件对搜索空间进行剪枝。
预过滤(Prefilter)使向量索引能够在搜索过程中结合过滤条件进行判断,从而剪枝搜索空间;更小的搜索空间意味着更高的搜索效率。不过,检查过滤条件是否满足本身也会引入额外开销。因此,仅当过滤条件严格(能够排除大量行)且轻量(计算开销远低于计算向量距离)时,才推荐使用预过滤。为了便于理解,这里给出两个不适合使用预过滤的反例:
id % 97 > 0:该过滤条件过于宽松email ~ '^([a-zA-Z]+)*$':该过滤条件计算开销过高
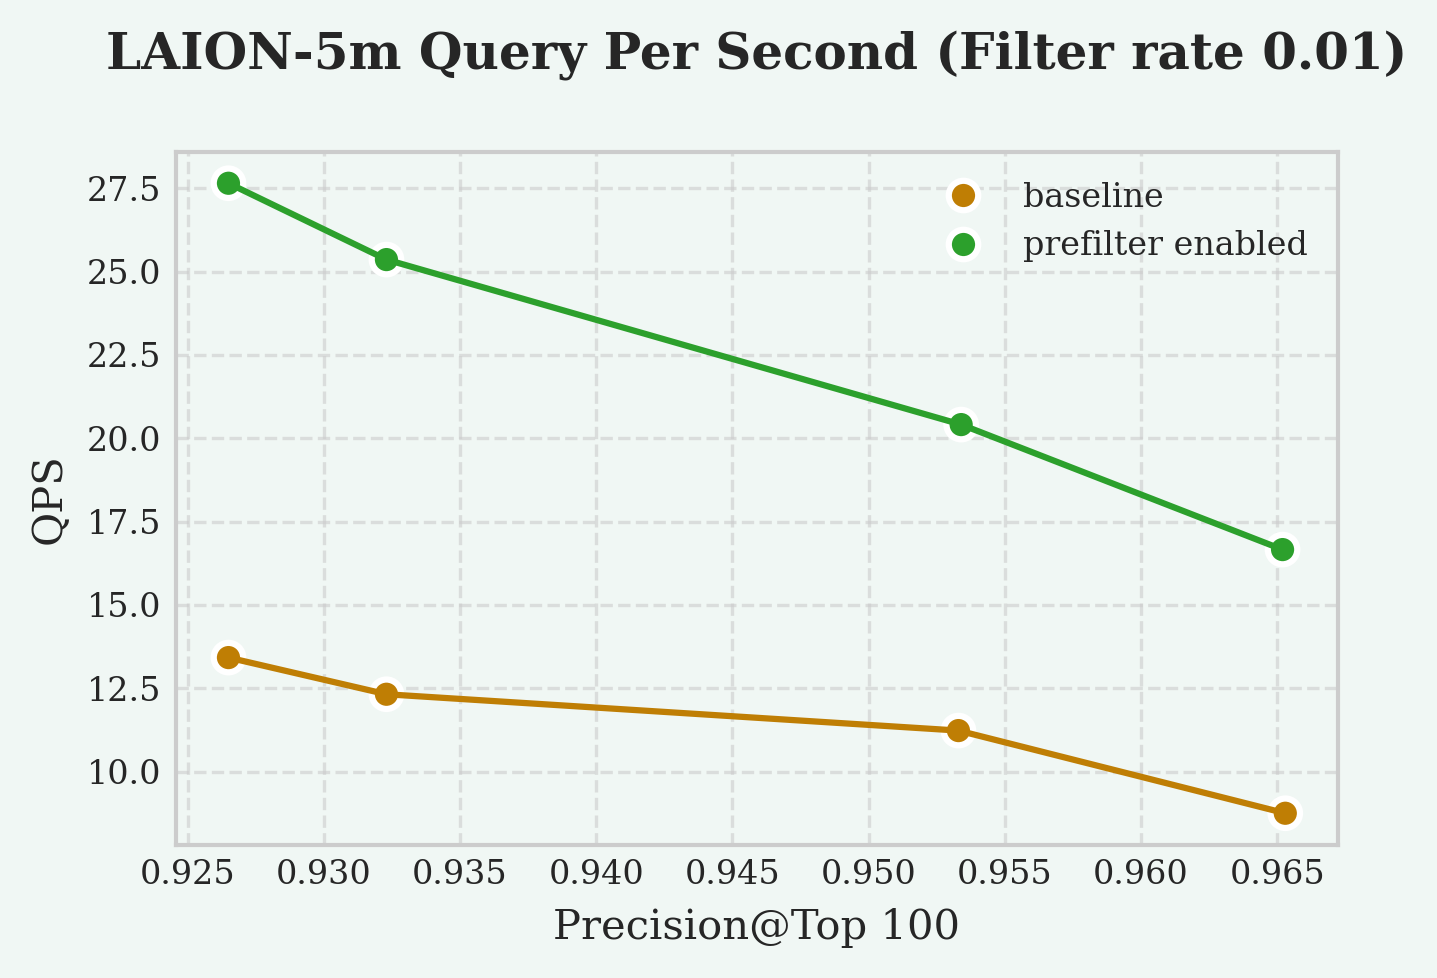
根据我们的实验结果,在不同选择率(selectivity)下启用预过滤带来的 QPS 加速比如下:
- 在 1% 选择率下,QPS 提升 200%
- 在 10% 选择率下,QPS 提升 5%
参考
vchordg 不支持此功能。
搜索参数(vchordrq)
vchordrq
vchordrq.prefilter
since v0.4.0
- 说明:GUC 参数
vchordrq.prefilter允许在计算距离之前先对过滤条件进行求值。例如,在查询SELECT * FROM items WHERE id % 2 = 0 ORDER BY embedding <-> '[3,1,2]' LIMIT 5中,正常情况下索引会先计算所有候选行的embedding <-> '[3,1,2]'距离,然后将行传递给 PostgreSQL,由 PostgreSQL 过滤掉id % 2 != 0的行。启用该参数后,索引可以在计算距离之前预先评估过滤条件并丢弃不匹配的行,从而提高查询效率。 - 类型:布尔值(boolean)
- 默认值:
false