自适应检索与缩短嵌入向量
OpenAI 最新的嵌入模型支持缩短嵌入向量,开发者只需移除序列末尾的部分数值,即可在保持有效文本表示的同时降低存储与计算开销。
OpenAI 最新的嵌入模型支持缩短嵌入向量(Shortening embeddings,即套娃嵌入 Matryoshka Embeddings),开发者只需简单地“移除序列末尾的部分数值”,依然能够保持有效的文本语义表示。
这带来了极其灵活的使用方式。例如,当使用仅支持最高 1024 维嵌入的向量数据存储时,开发者现在仍然可以使用我们最好的嵌入模型 text-embedding-3-large,只需将 API 参数 dimensions 指定为 1024,即可将嵌入从 3072 维缩短为 1024 维,通过牺牲少许精度来换取更小的向量体积。
缩短嵌入向量
OpenAI 的新嵌入模型 text-embedding-3-large 默认生成 3072 维的嵌入向量。

但您可以安全地移除序列末尾的部分数值,同时仍保留有效的文本语义表示。例如,您可以将嵌入向量缩短为 1024 维。
详情
您可能需要对截断后的向量进行归一化(Normalization),以确保缩短后的嵌入向量与点积等距离计算方式兼容。如果您直接通过 OpenAI 的 API 调用 text-embedding-3-large 生成低维嵌入(而非自行截断原始嵌入),API 会自动帮您完成归一化处理。
embedding_3072_dim_from_openai = [-0.00611, -0.00269, ...]
embedding_1024_dim_from_openai = [-0.01520, -0.03839, ...]

embedding_1024_dim_truncated_from_3072_dim = [-0.00611, -0.00269, ...]
embedding_1024_dim_normalized = [-0.01520, -0.03839, ...]
缩短嵌入向量有诸多优势:
- 降低内存占用:缩短嵌入向量可以显著减少存储向量所需的内存。
- 更低的维度:缩短嵌入向量可以降低向量维度,适配某些仅支持特定维度上限(例如 2000 维)的向量数据存储。
- 更快的索引与搜索速度:较小的嵌入向量比大型嵌入向量的索引构建和搜索速度更快。
- 性能与成本的权衡:缩短嵌入向量可以通过牺牲少许精度来换取更小的向量规模和更低的资源成本。
不过,缩短后的嵌入向量在精度(召回率)上不如完整维度的嵌入向量。
我们进行了一项实验,评估缩短后的嵌入向量与完整嵌入向量相比的实际效果。基准测试使用了 dbpedia-entities-openai3-text-embedding-3-large-3072-1M 数据集,并在规格为 n2-standard-8(8 vCPU、32 GB 内存)的 Google Cloud 虚拟机上运行。
我们创建了一张表,并向其中填充了 100 万条 3072 维的嵌入向量:
CREATE TABLE openai3072 (
  id bigserial PRIMARY KEY,
  text_embedding_3_large_3072_embedding vector(3072),
  text_embedding_3_large_3072_embedding bvector(3072)
);
详情
向表中插入 100 万条嵌入向量的代码如下:
from pgvecto_rs.sdk import PGVectoRs, Record
from pgvecto_rs.psycopg import register_vector
import psycopg

conn = psycopg.connect(conninfo='postgresql://postgres:mysecretpassword@localhost:5433/postgres', autocommit=True)

import json
import os

import numpy as np
import random
from datasets import load_dataset
from datasets.exceptions import DatasetNotFoundError
from tqdm import tqdm

MODEL_NAME, DIMENSIONS = "text-embedding-3-large", 3072
DATASET_NAME = f"Qdrant/dbpedia-entities-openai3-{MODEL_NAME}-{DIMENSIONS}-1M"
collection_name = f"dbpedia-{MODEL_NAME}-{DIMENSIONS}"
embedding_column_name = f"{MODEL_NAME}-{DIMENSIONS}-embedding"

dataset = load_dataset(
        DATASET_NAME,
        streaming=False,
        split="train",
    )

bs = 1000
for i, record in tqdm(enumerate(dataset)):
    if i % bs == 0:
        points = []
    points.append({
        "embedding": record[embedding_column_name]
    })
    if i % bs == bs - 1:
        batch_points = f", ".join([f"('{p['embedding']}')" for p in points])
        conn.execute(f"INSERT INTO openai3072 (text_embedding_3_large_3072_embedding) VALUES %s" % (batch_points))
    print(f"Inserted {i} records")
此外,我们分别为 256 维、1024 维和 3072 维的嵌入向量创建了索引,并针对每个维度执行了近似最近邻(ANN)查询。注意,我们无需单独创建 256 维或 1024 维的列,因为可以直接通过表达式索引截取 3072 维嵌入向量的前 256 个或前 1024 个维度:
-- 创建 256 维表达式索引
CREATE INDEX openai_vector_index_256 ON public.openai3072 USING vectors (((text_embedding_3_large_3072_embedding[0:256])::vector(256)) vector_l2_ops);

-- 创建 1024 维表达式索引
CREATE INDEX openai_vector_index_1024 on openai3072 using vectors((text_embedding_3_large_3072_embedding[0:1024]::vector(1024)) vector_l2_ops);

-- 创建 3072 维完整索引
CREATE INDEX openai_vector_index on openai3072 using vectors(text_embedding_3_large_3072_embedding vector_l2_ops);
同时,我们还为 3072 维嵌入构建了二值向量索引(Binary Vector Index),并使用该索引执行了 ANN 查询:
CREATE INDEX openai_vector_index_bvector ON public.openai3072 USING vectors (text_embedding_3_large_3072_bvector bvector_l2_ops);
我们针对要检索的最近邻数量设置了不同的 LIMIT 值(5、10、50、100)来运行 KNN 查询。
详情
我们借助 pgbench 测量了每种查询的每秒查询数(QPS)和平均查询耗时:
export PGHOST="localhost"
export PGUSER="postgres"
export PGPASSWORD="mysecretpassword"
export PGDATABASE="postgres"
export PGPORT=5433
export VECTOR_DIM=3072
TEST_TIME=300
for clients in 2 4 8 16 32; do
    pgbench -n -T "${TEST_TIME}" \
      --file=query.sql \
      -c "${clients}" -j "${clients}"
done
query.sql 文件包含以下 SQL 查询:
\set random_id random(1, 1000000)

select id from openai3072 order by text_embedding_3_large_3072_embedding <-> (select text_embedding_3_large_3072_embedding from openai3072 where id = :random_id) limit 100;
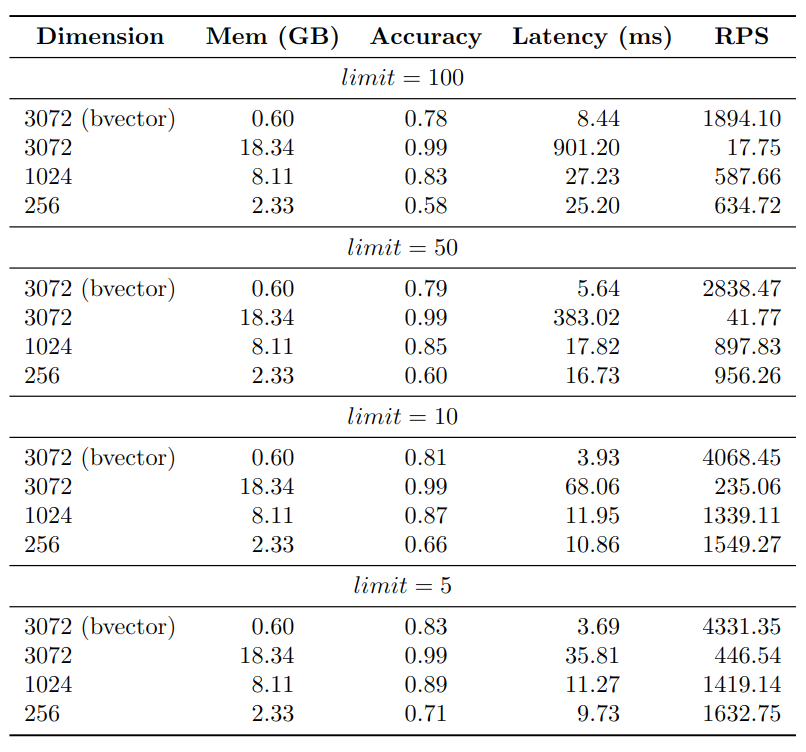
实验结果如下所示:
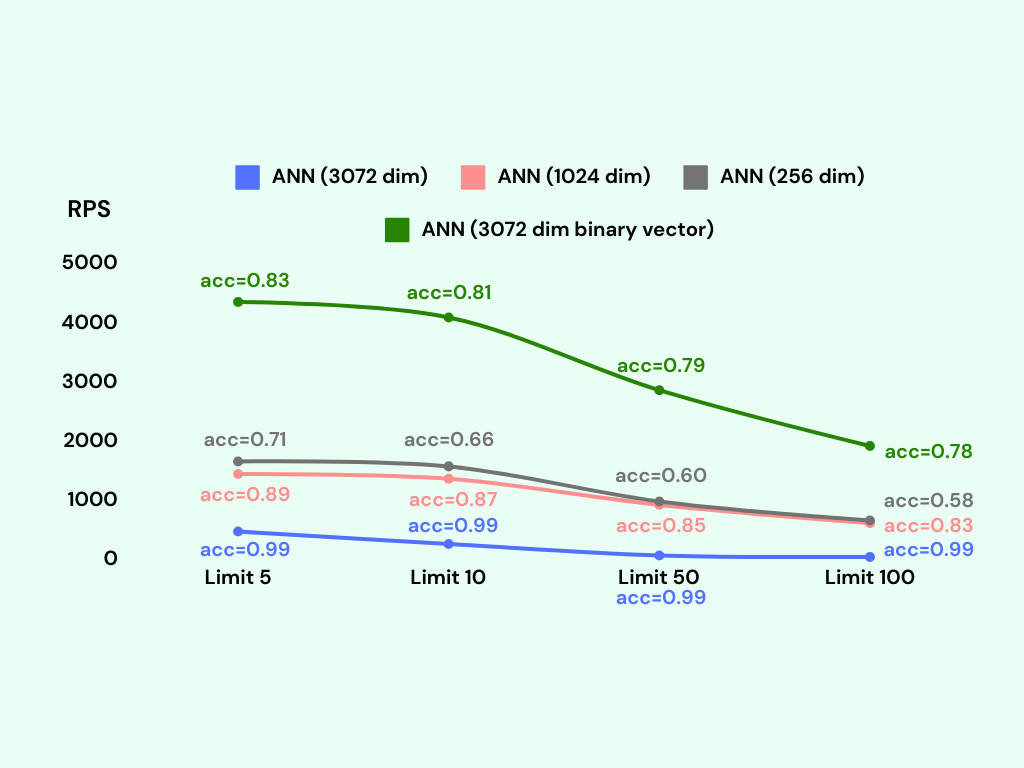
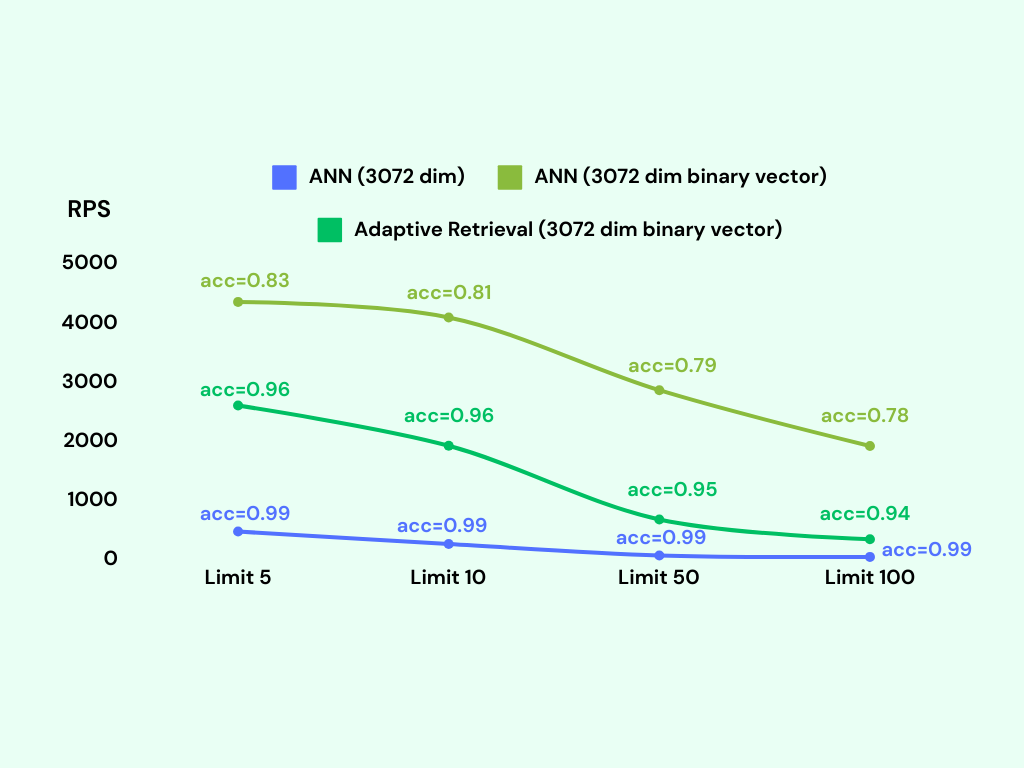
不出所料,3072 维嵌入向量展现出最高的准确率;1024 维嵌入向量的准确率略低,约为 85%;256 维嵌入向量的准确率最低,约为 65%。另一方面,二值向量索引达到了约 80% 的准确率。
在每秒请求数(RPS)指标方面,二值向量索引表现出最高的性能效率,其次是 256 维嵌入、1024 维嵌入,最后是 3072 维嵌入。
详情
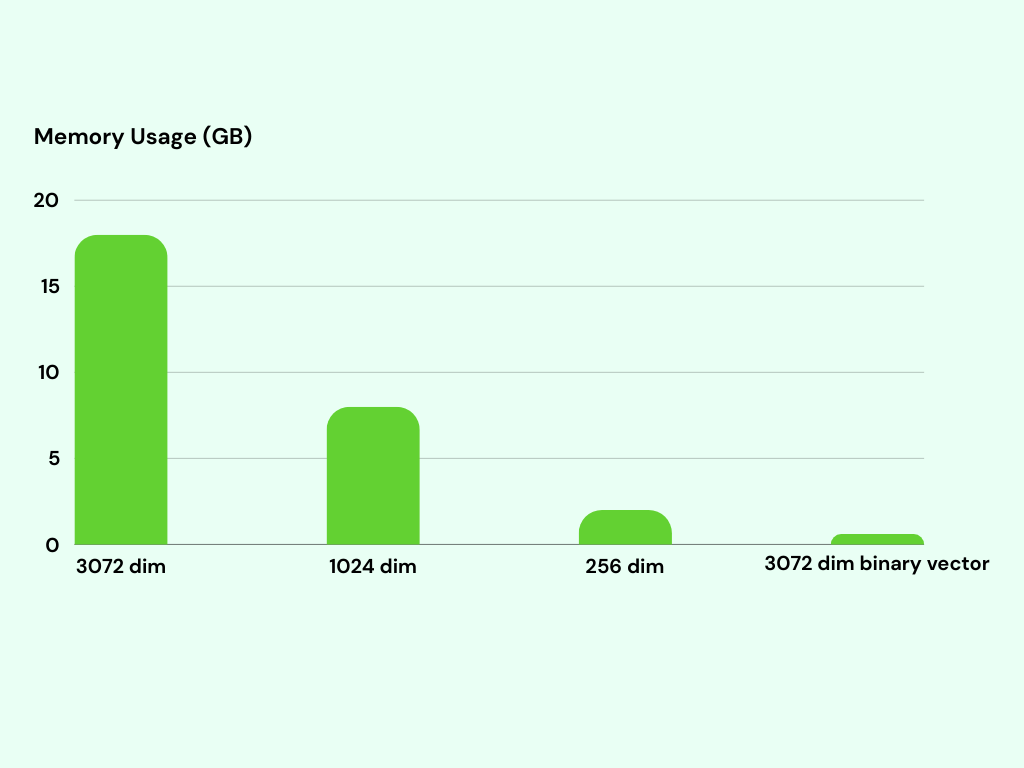
索引的内存占用是另一个需要重点考量的方面。为 100 万条 3072 维的二值向量建立索引仅需约 600MB 内存;相比之下,3072 维浮点向量索引则消耗了约 18GB 内存。两者在内存占用上存在巨大差异——3072 维浮点向量索引消耗的内存约为二值向量索引的 30 倍。
通过自适应检索提升准确率
与完整维度索引相比,低维索引和二值向量索引通过牺牲一定的准确率,换取了更高的 RPS 和更低的内存占用。而自适应检索(Adaptive Retrieval)技术可以将两者的优势结合起来,实现兼顾准确率、内存占用和查询速度的优化方案。
自适应检索背后的逻辑非常简单。以“获取前 100 个最佳候选结果”为例,我们可以分两步执行:
- 首先查询低维索引或二值向量索引,从 100 万条嵌入向量中快速召回前 200 个候选结果。这一步操作非常快。
- 使用全维度精确 KNN 查询对候选集进行重排序(Rerank),从中选出最终的前 100 个结果。由于精确 KNN 非常适合在小规模候选集上进行高精度相似度计算,因此在这里用于重排序再合适不过。

虽然重排序步骤会比单次粗召回略慢一点,但它仍然远快于直接查询完整维度的索引。在 pgvecto.rs 中可以通过如下 SQL 函数轻松实现:
CREATE OR REPLACE FUNCTION match_documents_adaptive(
  query_embedding vector(3072),
  match_count int
)
RETURNS SETOF openai3072
LANGUAGE SQL
AS $$
WITH shortlist AS (
  SELECT *
  FROM openai3072
  ORDER BY (text_embedding_3_large_3072_embedding[0:256])::vector(256) <-> (query_embedding[0:256])::vector(256)
  LIMIT match_count * 2
)
SELECT *
FROM shortlist
ORDER BY text_embedding_3_large_3072_embedding <-> query_embedding
LIMIT match_count;
$$;
match_documents_adaptive 函数接收查询向量 query_embedding 和匹配数量 match_count 作为输入参数。它首先使用 256 维索引从 100 万条记录中检索出 match_count * 2 条候选记录,随后使用 3072 维精确距离对这些候选记录进行重排序,返回最终的前 match_count 条记录。
基于二值向量索引和 1024 维索引的自适应检索函数也可以用完全相同的方式实现。
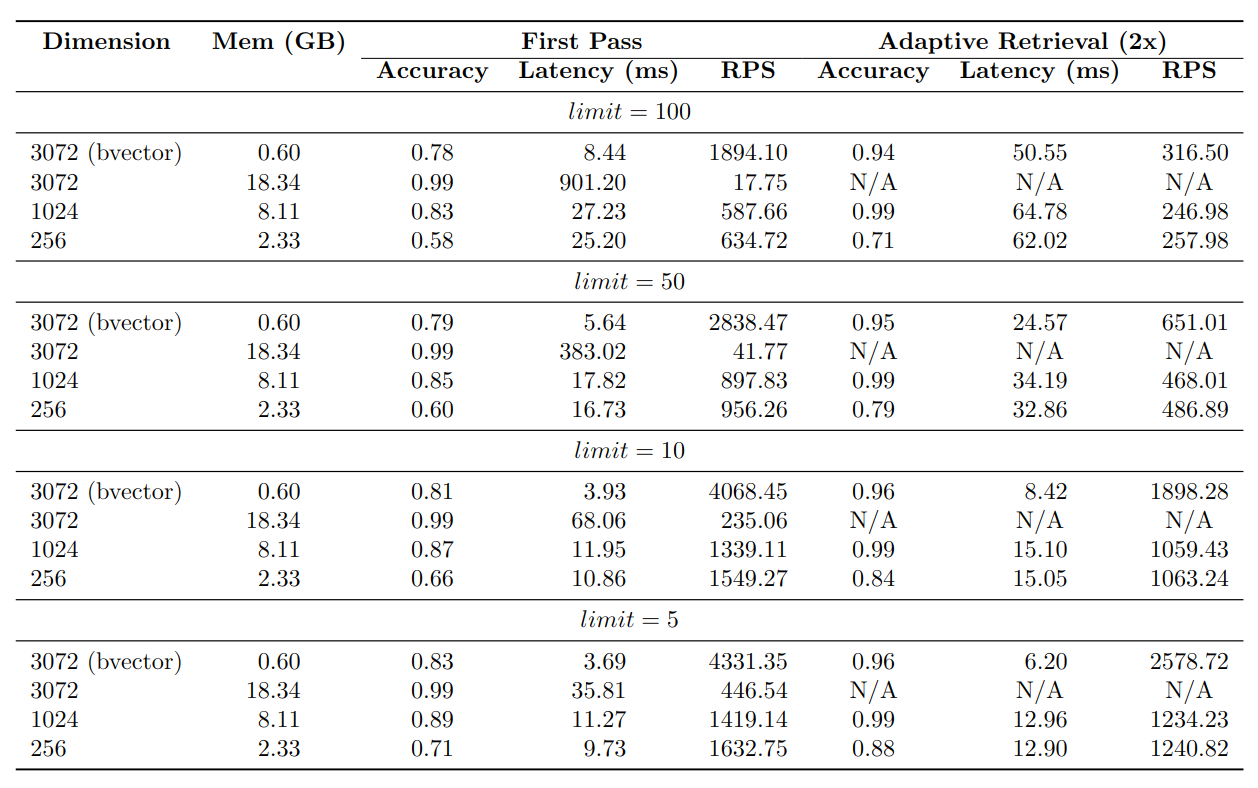
我们使用自适应检索技术再次运行了基准测试,并在下图中将其标记为 Adaptive Retrieval:
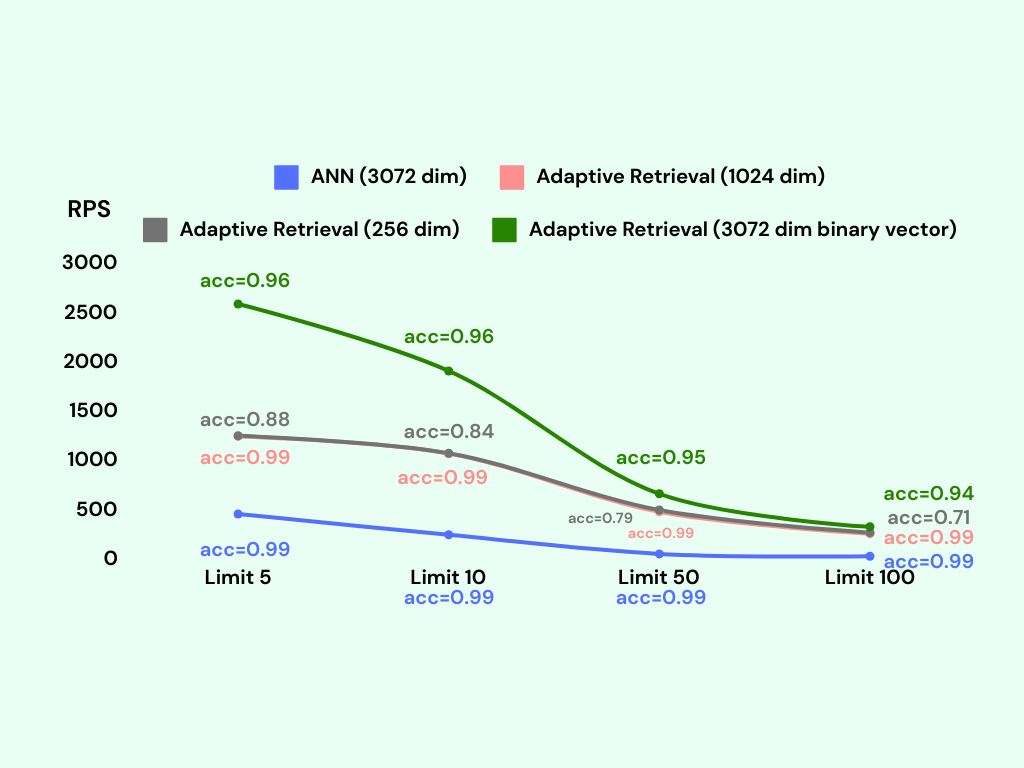
可以看到,增加重排序步骤后,低维索引和二值向量索引的准确率得到了显著提升。
结合自适应检索的二值向量索引达到了约 95% 的准确率,而与不使用自适应检索相比,其 RPS 仅略有下降。更令人印象深刻的是,结合自适应检索的二值向量索引的内存占用依然只有约 600MB,与未启用自适应检索时完全相同(因为完整向量存储在磁盘表中,仅在重排序少量候选行时按需读取)。
详情
总结
缩短嵌入向量可以减少存储向量所需的内存占用,并加快索引构建和搜索的速度。然而,单纯使用缩短后的嵌入向量在准确率上不及完整嵌入向量。因此,我们需要结合自适应检索(两阶段检索与重排序)技术来提升低维索引和二值索引的准确率。
综合来看,对于 text-embedding-3-large 模型,结合自适应检索的二值向量索引是性价比最高的选择;如果您需要极高的准确率(例如 99%),也可以考虑使用结合自适应检索的 1024 维索引。
附注:本实验中使用的所有代码和数据均已在 pgvecto.rs-matryoshka-embeddings-benchmark 仓库中开源。