这是本节的多页打印视图。 .
pgvecto.rs 文档(旧版)
- 1: 快速入门
-
2: 使用指南
- 2.1: 索引
- 2.2: 搜索
- 2.3: 监控
- 2.4: 量化
- 2.5: `pgvector` 兼容性
-
3: 应用案例
- 3.1: 混合搜索
- 3.2: 自适应检索与缩短嵌入向量
- 3.3: 以图搜图与智能图像搜索
- 3.4: 多租户架构
- 3.5: 稀疏向量搜索
- 3.6: 生成式问答(Generative QA)
-
4: 生态集成
- 4.1: LangChain
- 4.2: LlamaIndex
- 4.3: Citus
-
5: 运维管理
- 5.1: 配置
- 5.2: 版本升级
- 5.3: 逻辑复制
- 5.4: 外部数据包装器 (FDW)
- 5.5: Kubernetes
- 5.6: 迁移指南
-
6: 常见问题
- 6.1: 常见问答
- 6.2: 与 pgvector 对比
- 6.3: 为什么不使用专用向量数据库?
- 6.4: 基准测试
-
7: 参考手册
- 7.1: 数据库 Schema
- 7.2: 索引选项
- 7.3: 搜索选项
-
7.4: 向量类型
- 7.4.1: 半精度向量:`vecf16`
- 7.4.2: 8 位整数向量:`veci8`
- 7.4.3: 稀疏向量:`svector`
- 7.4.4: 二值向量:`bvector`
-
8: 社区
- 8.1: 参与贡献 `pgvecto.rs`
- 8.2: 路线图
- 8.3: 采用者案例
-
9: 开发者指南
- 9.1: 开发教程
pgvecto.rs 已由 VectorChord 接替。 对于新部署环境,请使用 VectorChord;对于现有的 pgvecto.rs 数据库,请参考迁移指南。
1 - 快速入门
1.1 - 概览
我们强烈建议您探索全新的 VectorChord 实现,它提供了更高的稳定性和性能。建议用户迁移至 VectorChord,详情请参考迁移指南。
pgvecto.rs 简介。
什么是 pgvecto.rs
pgvecto.rs 是一个提供向量相似度搜索功能的 Postgres 扩展。它使用 Rust 编写,基于 pgrx 构建。目前处于测试(Beta)阶段,诚邀您在生产环境中试用并向我们提供反馈。更多信息请参阅📝我们的发布博客。
与 pgvector 的对比
查看 pgvecto.rs vs pgvector 了解更多详情。
| 特性 | pgvecto.rs | pgvector |
|---|---|---|
| 过滤(Filtering) | 引入 VBASE 方法,将向量搜索与关系查询统一(例如:单向量 TopK + 过滤 + 连接)。 | 应用过滤条件时,返回结果可能不完整。例如,原本希望限制返回 10 条结果,加上过滤后可能最终只得到 5 条结果。 |
| 向量维度 | 最高支持 65535 维。 | 最高支持 2000 维。 |
| SIMD | 在运行时动态分派 SIMD 指令,根据具体机器的硬件能力最大化性能。 | 在 0.7.0 版本中为 Linux x86-64 增加了距离函数的 CPU 动态分派。 |
| 数据类型 | 引入额外的数据类型:二值向量(binary vector)、FP16(16 位浮点数)和 INT8(8 位整数)。 | - |
| 索引机制 | 独立于 PostgreSQL 管理索引的存储和内存 | 依赖 PostgreSQL 的原生存储引擎 |
| WAL 支持 | 为数据提供预写式日志(WAL)支持,索引的 WAL 支持正在开发中。 | 为索引和数据均提供预写式日志(WAL)支持。 |
快速开始
对于新用户,我们建议使用 Docker 镜像快速上手。
随后您可以使用 psql 命令行工具连接到数据库。默认用户名为 postgres,默认密码为 mysecretpassword。
运行以下 SQL 确保扩展已启用:
pgvecto.rs 引入了新的数据类型 vector(n) 来表示 n 维向量,括号内的 n 代表向量的维度。
您可以使用以下 SQL 创建一张表:
仅当 时,vector(n) 才是有效的数据类型。受限于 PostgreSQL 的机制,您有可能在 vector(3) 类型的列中存入 维的值,而且不带维度的 vector 也是合法的数据类型。但您仍然不能向向量中放入 个标量或超过 个标量。如果您在列定义中使用不带维度的 vector,或者列中存在与声明维度不匹配的值,您将无法在该列上创建索引。
接下来,您可以按如下方式向表中插入向量数据:
我们支持三种用于计算两个向量之间距离的操作符:
<->:平方欧氏距离(Squared Euclidean distance),定义为 。<#>:负点积(Negative dot product),定义为 。<=>:余弦距离(Cosine distance),定义为 。
您可以像这样简单地搜索相似向量:
简单的问答(Question-Answering)应用
请查看问答应用教程。
半精度浮点数
vecf16 类型除了标量元素类型外,其余与 vector 完全一致。它存储 16 位浮点数。如果您希望减少内存占用以获得更好的性能,可以尝试将 vector 类型替换为 vecf16 类型。
关于 vecf16 的更多用法,请参考向量类型。
稀疏向量
svector 类型是稀疏向量类型。它以稀疏格式存储向量,非常适合包含大量零元素的向量。
关于 svector 的更多用法,请参考向量类型。
二值向量
bvector 类型是二值向量类型,本质上是定长位串(bit string)。除了上述 3 种距离外,我们还支持 jaccard 距离 <~>,其定义为 。而汉明距离(hamming distance)与平方欧氏距离等价,您可以使用 <-> 操作符来计算。此外,我们还提供了 binarize 函数,用于从 vector 构造 bvector(将正数元素设为 1,其余设为 0)。
关于 bvector 的更多用法,请参考向量类型。
路线图 🗂️
请查看路线图(ROADMAP)。
参与贡献 😊
我们欢迎来自开源社区、个人及合作伙伴的各种形式的贡献。
- 加入我们的 Discord 社区!
- 如需从源码构建,请阅读我们的贡献指南和开发教程。
与我们交流
💬 有兴趣与我们聊聊您在构建或管理 AI/ML 应用方面的经验吗?
1.2 - 安装
我们强烈建议您探索全新的 VectorChord 实现,它提供了更高的稳定性和性能。建议用户迁移至 VectorChord,详情请参考迁移指南。
安装 pgvecto.rs 有四种方式。
Docker
试用 pgvecto.rs 最简单的方式是直接运行开箱即用的 Docker 镜像。
随后您可以使用 psql 命令行工具连接到数据库。默认用户名为 postgres,默认密码为 mysecretpassword。
运行以下 SQL 确保扩展已启用:
为了获得完整性能,请添加类似 -v $PWD/pgdata:/var/lib/postgresql/data 的选项,将数据卷挂载到 PostgreSQL 数据目录。
您可以参考父镜像文档 https://hub.docker.com/_/postgres/ 来配置 PostgreSQL。
使用 Debian 软件包安装
从 Debian 软件包安装需要依赖 GLIBC >= 2.31,例如:
Ubuntu 20.04或更高版本Debian Bullseye或更高版本
Debian 软件包(.deb)适用于基于 Debian 的发行版(如 Ubuntu 等),可以通过 dpkg 或 apt-get 轻松安装。
-
在 Release 页面下载
.deb软件包,并执行sudo apt install vectors-pg15-*.deb进行安装。 -
修改
shared_preload_libraries和search_path以包含该扩展,从而完成 PostgreSQL 配置。
- 连接到数据库并启用扩展。
使用 ZIP 压缩包安装
since v0.2.1从 ZIP 压缩包安装需要依赖 GLIBC >= 2.31,例如:
RHEL 9或更高版本
对于非 Debian 系且无法运行 Docker 容器的系统,请按以下步骤安装:
- 安装前,请确保已安装必要的软件包,包括
PostgreSQL、pg_config、unzip和wget。
- 验证 PostgreSQL 是否已设置
$pkglibdir和$shardir。
- 在 Release 页面下载 zip 压缩包并解压到临时目录。
- 将扩展文件复制到 PostgreSQL 目录。
- 修改
shared_preload_libraries和search_path以包含该扩展,从而完成 PostgreSQL 配置。
- 连接到数据库并启用扩展。
从源码构建安装
在从源码构建之前,您可以参考开发指南配置开发环境。
- 构建并安装扩展:
- 修改
shared_preload_libraries和search_path以包含该扩展,从而完成 PostgreSQL 配置。
- 连接到数据库并启用扩展。
2 - 使用指南
2.1 - 索引
索引是构建支持高效搜索的数据结构的过程。pgvecto.rs 支持三种索引算法:暴力搜索(flat)、IVF 和 HNSW。默认算法为 HNSW。
要为向量构建索引,首先创建一张名为 items 的表,其中包含类型为 vector(n) 的 embedding 列,然后向表中填充生成的数据。
vector 是适用于绝大多数场景的数据类型。pgvecto.rs 还支持其他特定的向量类型,包括:
- 半精度向量(Half-Precision Vector)
- 8 位整数向量(8-Bit Integer Vector) since v0.3.0
- 稀疏向量(Sparse Vector) since v0.3.0
- 二值向量(Binary Vector) since v0.3.0
您可以使用以下 SQL 为平方欧氏距离创建向量索引:
vector_l2_ops 操作符类用于计算平方欧氏距离。有关操作符类的完整列表,请参阅参考文档。
若要将索引算法从默认的 HNSW 切换为 IVF,请执行以下 SQL 命令。更多使用示例请参阅下文的示例。
现在您可以使用以下 SQL 执行 KNN 搜索,利用向量索引加速查询:
pgvecto.rs 采用异步方式构建索引。当您向表中插入新行时,数据会首先写入一个仅追加(append-only)文件中。后台线程会定期将新插入的行合并到现有索引中。当用户在合并完成前执行任何搜索时,系统会同时扫描该仅追加文件,以确保查询结果的准确性和一致性。
示例
以下是使用不同算法和参数创建索引的示例。有关所有可配置项的完整列表,请参阅索引选项参考指南。
选择建议
选择合适的索引算法与参数对向量搜索性能至关重要。以下是针对不同使用场景的建议。
暴力搜索(flat)
如果您搜索的数据量较小(1,000 到 10,000 条之间)或需要完全精确的结果,暴力搜索(flat)算法是一个可行的选择。
该算法是衡量其他索引方法的基准。它以原始形式保留向量而不做压缩,避免了额外的索引开销。虽然简单直观、易于使用,但它不适合处理大规模数据集。
此外,您还可以使用量化来减少内存占用。有关所有选项的完整列表,请参阅量化选项文档。关于量化的详细介绍也可以在量化指南中找到。
倒排文件索引(IVF)
IVF 主要利用倒排索引的思想,将向量 (id, vector) 存储在各自的聚类中心下。查询向量时,它会先找到最近的若干个聚类中心,然后分别搜索这些中心下的向量。
在开始搜索之前,需要先通过 K-Means 聚类训练 nlist 个聚类中心,并可选择设置采样点数 nsample。较高的值能生成更精确的聚类结果,但需要更长的训练时间。有关更多设置,请参阅参考指南。
分层可导航小世界图(HNSW)
HNSW 将跳表(Skip List)与可导航小世界(NSW)图的思想相结合,采用多层图结构:在较高层使用较长的边以实现快速跳转搜索,在较低层使用较短的边以提高搜索精度。
可导航小世界(Navigable small world)
可导航小世界(NSW)基于这样一个前提:图中的任意节点都可以通过极少数的“跳数(hops)”从其他任何节点到达。选定入口点(无论是随机选择、启发式选择还是算法确定)后,算法会检查周围的邻居节点是否比当前节点更接近查询目标。搜索不断向最近的邻居推进,直到在当前节点的邻接列表中找不到更近的节点为止。
构建图时,参数 m 决定了新节点与其最近邻节点建立连接的数量。较高的 m 值会产生更稠密、互联程度更高的图,但也会增加内存占用并降低插入速度。在插入节点时,算法会找出最近的 m 个节点并与它们建立双向连接。
搜索过程从预定义的入口点开始遍历 NSW 图。算法以贪心方式移动到离查询向量更近的相邻顶点,一旦在当前顶点的邻接列表中找不到更近的邻居,搜索便停止。
NSW 搜索的一个局限在于,它总是选择通往最近节点的表面最短路径,而忽略了图的全局结构。这种“贪心搜索”方法容易陷入局部最优,这一问题通常被称为“早停(early stopping)”。
跳表(Skip list)
跳表使用概率方法构建:随着层级的升高,节点出现的概率逐渐降低,因此高层中的节点数量更少。搜索节点时,算法从顶层的“头节点”开始,向后移动到大于或等于目标的下一个节点;如果未找到目标节点,则下降到更低(更细粒度)的一层并重复此模式,直到定位到目标节点或其最近邻。
HNSW
构建这种多层图从包含整个数据集的基础层开始。沿着层级向上,每一层都提供其下一层的精简摘要,包含更少的节点,充当在图内进行大跨度跳跃的“快速通道”。
较小的 m 值更适合低维数据或对召回率要求不高的场景;较大的 m 值则适用于高维数据或对高召回率有严格要求的场景。
ef_construction 参数决定了添加新节点时的动态候选列表大小;增大该值可以提高召回率,但会延长索引构建时间。
HNSW 索引属于资源密集型索引,需要额外的内存,并且在处理大型数据集时需要调大 maintenance_work_mem 设置。如果您追求显著快于 IVF 的查询性能、高召回率以及随数据集规模良好扩展的能力,HNSW 是极佳的选择。
2.2 - 搜索
获取与目标向量最近的 5 个邻居:
操作符
以下操作符用于表示不同的距离度量:
| 名称 | 说明 |
|---|---|
| <-> | 平方欧氏距离(Squared Euclidean distance) |
| <#> | 负点积(Negative dot product) |
| <=> | 余弦距离(Cosine distance) |
有关它们的数学定义,请参阅概览。
过滤查询
在指定类别下,获取与目标向量最近的 10 个邻居:
查询选项
在当前会话中将 ivf 扫描列表数设置为 1:
在当前事务中将 hnsw 搜索范围设置为 40:
有关所有可配置项,请参阅搜索选项。
搜索模式
支持两种搜索模式:vbase 和 basic。
vbase
作为默认搜索模式,vbase 适用于绝大多数场景。
关于其工作原理,请参阅论文 VBASE: Unifying Online Vector Similarity Search and Relational Queries via Relaxed Monotonicity。
basic
basic 模式在行为上与 faiss 等向量算法库保持一致。如果您希望将结果与这些库对齐,该模式会很有帮助。
启用 basic 模式时,必须遵守以下限制:
- 在执行更新操作后、进行搜索前,必须先执行 VACUUM。
- 搜索时不能带有过滤条件(Filter)。
2.3 - 监控
我们提供了 pg_vector_index_stat 视图来监控索引的构建进度。
| 列名 | 类型 | 说明 |
|---|---|---|
| tablerelid | oid | 表的 OID。 |
| indexrelid | oid | 索引的 OID。 |
| tablename | name | 表名。 |
| indexname | name | 索引名。 |
| idx_status | text | 取值为 NORMAL 或 UPGRADE,表示该索引处于正常状态还是需要升级。 |
| idx_indexing | bool | 当 idx_status 为 NORMAL 时非空。表示后台线程是否正在构建索引。 |
| idx_tuples | int8 | 当 idx_status 为 NORMAL 时非空。索引中的元组总数。 |
| idx_sealed | int8[] | 当 idx_status 为 NORMAL 时非空。每个已封存分段(sealed segment)中的元组数量。 |
| idx_growing | int8[] | 当 idx_status 为 NORMAL 时非空。每个增长中分段(growing segment)中的元组数量。 |
| idx_write | int8 | 当 idx_status 为 NORMAL 时非空。写缓冲区(write buffer)中的元组数量。 |
| idx_size | int8 | 当 idx_status 为 NORMAL 时非空。所有分段占用的总字节大小。 |
| idx_options | text | 当 idx_status 为 NORMAL 时非空。索引的配置信息。 |
idx_options 详情idx_options 是一个包含向量(vector)、分段(segment)、优化(optimizing)和索引(indexing)选项的 JSON 字符串。示例如下:
如果不再有新的插入操作,并且您希望等待所有索引构建完成,可以每隔 60 秒检查一次 idx_indexing 字段,直到其变为 false(注:原文写作 true,实际 idx_indexing = false 表示后台索引构建已完成)。
2.4 - 量化
量化(Quantization)是一种在可接受的精度损失范围内,降低内存消耗和计算复杂度的技术。在向量搜索中,主要有两种量化方式:乘积量化(Product Quantization)和标量量化(Scalar Quantization)。
乘积量化(Product Quantization)
乘积量化通过在数据集上训练多个子空间聚类模型,将每个高维向量映射为一组聚类中心索引列表。它常用于解决高维向量数据内存占用过高的问题。
在 pgvecto.rs 中,您可以通过以下方式启用乘积量化:
更多配置可在索引文档中找到。
标量量化(Scalar Quantization)
标量量化将每个标量值映射为低比特格式(例如从 32 位浮点数映射为 8 位整数)。通常情况下,这不会对精度造成明显影响,但能有效降低内存占用并提升查询性能。pgvecto.rs 支持通过以下方式启用 uint8 标量量化:
选择建议
当需要使用量化时,建议始终优先尝试标量量化。它在精度与内存占用之间取得了良好的平衡。
如果内存占用仍然过高,可以尝试乘积量化。该方法能大幅降低内存占用,但可能会影响精度。由于乘积量化的效果与训练数据集高度相关,您需要尝试不同的 ratio 和 sample 参数值,以找到最适合您数据集的配置。
此外,您还可以使用主成分分析(PCA)等降维方法来降低向量维度。
2.5 - `pgvector` 兼容性
pgvecto.rs 在以下方面原生兼容 pgvector:
CREATE TABLE命令,例如CREATE TABLE t (val vector(3))INSERT INTO命令,例如INSERT INTO t (val) VALUES ('[0.6,0.6,0.6]')
pgvecto.rs 还可以通过配置兼容 pgvector 的以下语法:
- 索引选项,允许通过
USING hnsw (val vector_ip_ops)创建索引 - 查询选项,支持通过
SET ivfflat.probes = 10设置参数
该特性称为 pgvector 兼容模式,可通过 SET vectors.pgvector_compatibility = on 启用。
索引选项与查询选项
对于 ivfflat 和 hnsw 索引,仅支持以下选项:
- 索引选项的默认值与
pgvecto.rs原生默认值不同,而是与pgvector保持一致。 - 查询选项的默认值则与
pgvecto.rs保持一致。
ivfflat 的索引选项:
| 键名 | 类型 | 取值范围 | 默认值 | 说明 |
|---|---|---|---|---|
| nlist | integer | [1, 1_000_000] |
100 |
聚类单元(列表)的数量。 |
ivfflat 的查询选项:
| 选项 | 类型 | 取值范围 | 默认值 | 说明 |
|---|---|---|---|---|
| ivfflat.probes | integer | [1, 1_000_000] |
10 |
扫描的列表数量。 |
ivfflat.probes 的默认值为 10,而非 pgvector 中的 1。
hnsw 的索引选项:
| 键名 | 类型 | 取值范围 | 默认值 | 说明 |
|---|---|---|---|---|
| m | integer | [4, 128] |
16 |
节点的最大出度。 |
| ef_construction | integer | [10, 2000] |
64 |
构建索引时的搜索范围。 |
hnsw 的查询选项:
| 选项 | 类型 | 取值范围 | 默认值 | 说明 |
|---|---|---|---|---|
| hnsw.ef_search | integer | [1, 65535] |
100 |
HNSW 的搜索范围。 |
hnsw.ef_search 的默认值为 100,而非 pgvector 中的 40。
示例
启用 pgvector 兼容模式并开始向量查询非常简单:
支持创建多种类型的索引:
3 - 应用案例
3.1 - 混合搜索
本节将向您展示如何使用 pgvecto.rs 实现混合搜索(Hybrid Search)。
向量搜索与全文检索
Postgres 基于匹配操作符 @@ 提供了全文检索(Full Text Search)功能。当 tsvector(文档)与 tsquery(查询)匹配时,它会返回 true。这两种数据类型的书写先后顺序不影响结果:
如上例所示,tsquery 与 tsvector 一样,并不仅仅是原始文本。tsquery 包含必须已经规范化为词位(lexeme)的搜索词项,并且可以使用 AND、OR、NOT 以及 FOLLOWED BY 操作符组合多个词项。在本例中,tsquery 'cat & rat' 与 tsvector 'a fat cat sat on a mat and ate a fat rat' 匹配,因为文档中同时包含 'cat' 和 'rat' 两个词项。
借助 pgvecto.rs,您可以在单条查询中同时结合使用全文检索和向量搜索。在本例中,我们创建一张名为 items 的表,包含两个字段:content 和 embedding。其中 content 列的类型为 text,embedding 列的类型为 vector(3)。我们向表中插入四条记录:
查询该表将得到如下内容:
首先,我们使用全文检索来查找 content 中同时包含单词 cat 和 rat 的记录。to_tsvector 函数会将文本转换为 tsvector,而操作符 @@ 则检查 tsvector 是否与 tsquery 匹配。
to_tsvector 会将文本文档解析为词元(token),将词元归约为词位(lexeme),并返回一个列出所有词位及其在文档中出现位置的 tsvector。
在上面的例子中可以看到,由于文本搜索配置设为了 english,生成的 tsvector 不包含停用词 a、on 或 it,单词 rats 被归约为 rat,标点符号 - 也被忽略了。
我们将得到以下结果:
接下来,我们使用向量搜索,按照每条记录的嵌入向量与查询向量之间的距离对结果进行排序:
此时,嵌入向量为 [7, 8, 9] 的记录将排在第一位,而嵌入向量为 [1, 2, 3] 的记录排在第二位:
高级搜索:融合全文检索与向量搜索的结果
您可以对全文检索结果和向量搜索结果的排名进行归一化,然后将两者融合在一起:
上述 SQL 查询对 items 表同时执行了语义搜索和全文检索,并根据相关性得分检索结果。以下是该查询的详细解析:
- 查询以一个名为
semantic_search的公用表表达式(CTE)开始。它选择id、content、embedding列,并使用测量embedding列与向量'[7, 8, 9]'之间距离的<->操作符计算排名(rank),结果按该距离排序。 - 定义另一个名为
full_text_search的 CTE。它选择与前一个 CTE 相同的列,但结合全文检索查询使用ts_rank函数计算排名。to_tsvector函数将content列转换为tsvector,而tsquery'cat & rat'则匹配content列中同时包含"cat"和"rat"的行,结果按全文检索相关性排名排序。 - 主查询使用
COALESCE函数从两个 CTE 中选取列,以处理其中一个 CTE 可能为空值的情况。同时,它将两个 CTE 排名的倒数相加,计算出综合得分(rank)。 - 主查询在两个 CTE 之间基于
id列执行全外连接(FULL OUTER JOIN)。 - 最终结果按照综合得分降序排列。
在这条查询中,我们先分别计算全文检索结果和向量搜索结果的排名,然后将两部分结果融合,最终得到如下输出:
3.2 - 自适应检索与缩短嵌入向量
OpenAI 最新的嵌入模型支持缩短嵌入向量(Shortening embeddings,即套娃嵌入 Matryoshka Embeddings),开发者只需简单地“移除序列末尾的部分数值”,依然能够保持有效的文本语义表示。
这带来了极其灵活的使用方式。例如,当使用仅支持最高 1024 维嵌入的向量数据存储时,开发者现在仍然可以使用我们最好的嵌入模型
text-embedding-3-large,只需将 API 参数dimensions指定为 1024,即可将嵌入从 3072 维缩短为 1024 维,通过牺牲少许精度来换取更小的向量体积。
缩短嵌入向量
OpenAI 的新嵌入模型 text-embedding-3-large 默认生成 3072 维的嵌入向量。

但您可以安全地移除序列末尾的部分数值,同时仍保留有效的文本语义表示。例如,您可以将嵌入向量缩短为 1024 维。
您可能需要对截断后的向量进行归一化(Normalization),以确保缩短后的嵌入向量与点积等距离计算方式兼容。如果您直接通过 OpenAI 的 API 调用 text-embedding-3-large 生成低维嵌入(而非自行截断原始嵌入),API 会自动帮您完成归一化处理。
缩短嵌入向量有诸多优势:
- 降低内存占用:缩短嵌入向量可以显著减少存储向量所需的内存。
- 更低的维度:缩短嵌入向量可以降低向量维度,适配某些仅支持特定维度上限(例如 2000 维)的向量数据存储。
- 更快的索引与搜索速度:较小的嵌入向量比大型嵌入向量的索引构建和搜索速度更快。
- 性能与成本的权衡:缩短嵌入向量可以通过牺牲少许精度来换取更小的向量规模和更低的资源成本。
不过,缩短后的嵌入向量在精度(召回率)上不如完整维度的嵌入向量。
性能与成本的权衡
我们进行了一项实验,评估缩短后的嵌入向量与完整嵌入向量相比的实际效果。基准测试使用了 dbpedia-entities-openai3-text-embedding-3-large-3072-1M 数据集,并在规格为 n2-standard-8(8 vCPU、32 GB 内存)的 Google Cloud 虚拟机上运行。
我们创建了一张表,并向其中填充了 100 万条 3072 维的嵌入向量:
向表中插入 100 万条嵌入向量的代码如下:
此外,我们分别为 256 维、1024 维和 3072 维的嵌入向量创建了索引,并针对每个维度执行了近似最近邻(ANN)查询。注意,我们无需单独创建 256 维或 1024 维的列,因为可以直接通过表达式索引截取 3072 维嵌入向量的前 256 个或前 1024 个维度:
同时,我们还为 3072 维嵌入构建了二值向量索引(Binary Vector Index),并使用该索引执行了 ANN 查询:
我们针对要检索的最近邻数量设置了不同的 LIMIT 值(5、10、50、100)来运行 KNN 查询。
我们借助 pgbench 测量了每种查询的每秒查询数(QPS)和平均查询耗时:
query.sql 文件包含以下 SQL 查询:
实验结果如下所示:
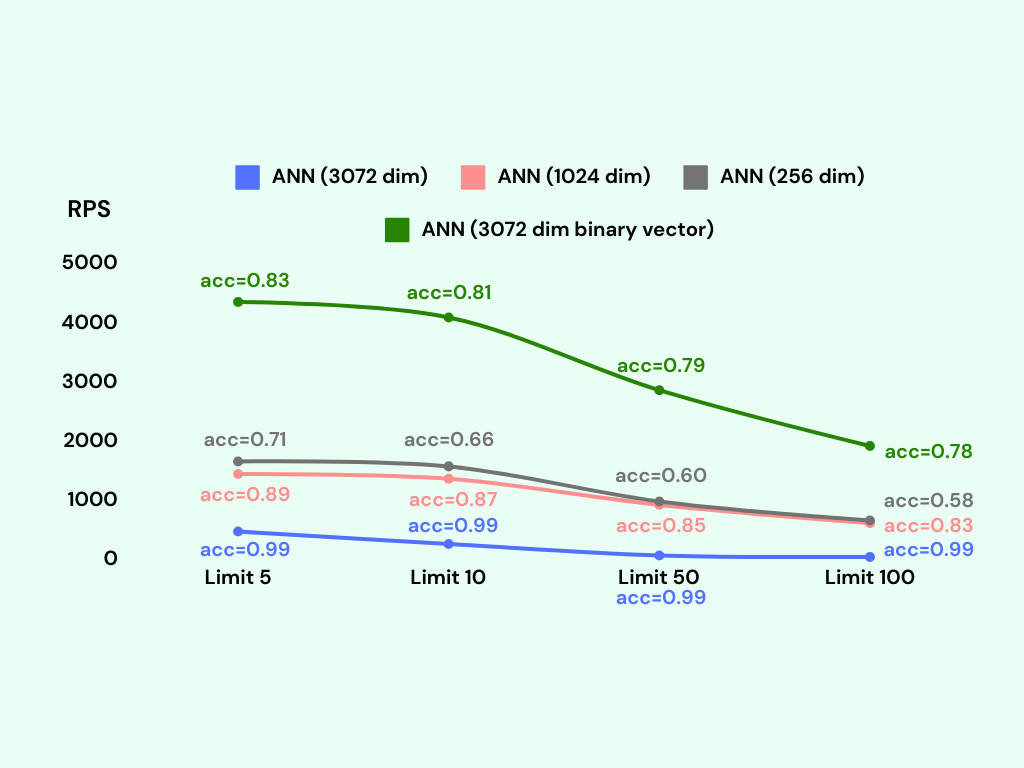
不出所料,3072 维嵌入向量展现出最高的准确率;1024 维嵌入向量的准确率略低,约为 85%;256 维嵌入向量的准确率最低,约为 65%。另一方面,二值向量索引达到了约 80% 的准确率。
在每秒请求数(RPS)指标方面,二值向量索引表现出最高的性能效率,其次是 256 维嵌入、1024 维嵌入,最后是 3072 维嵌入。
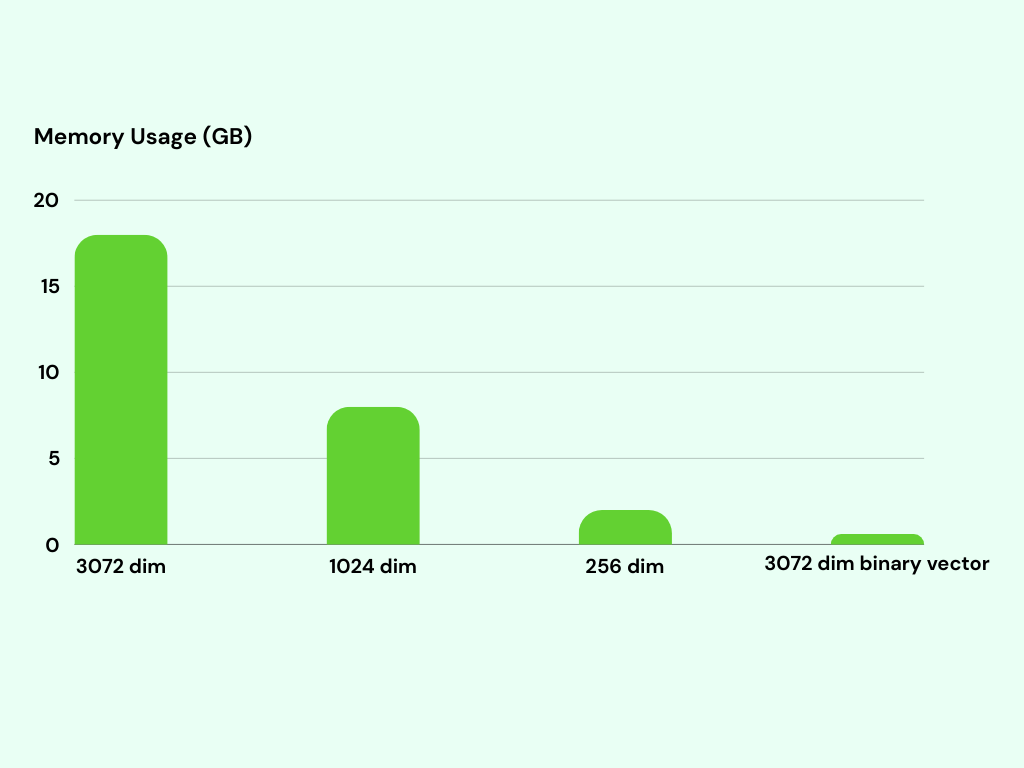
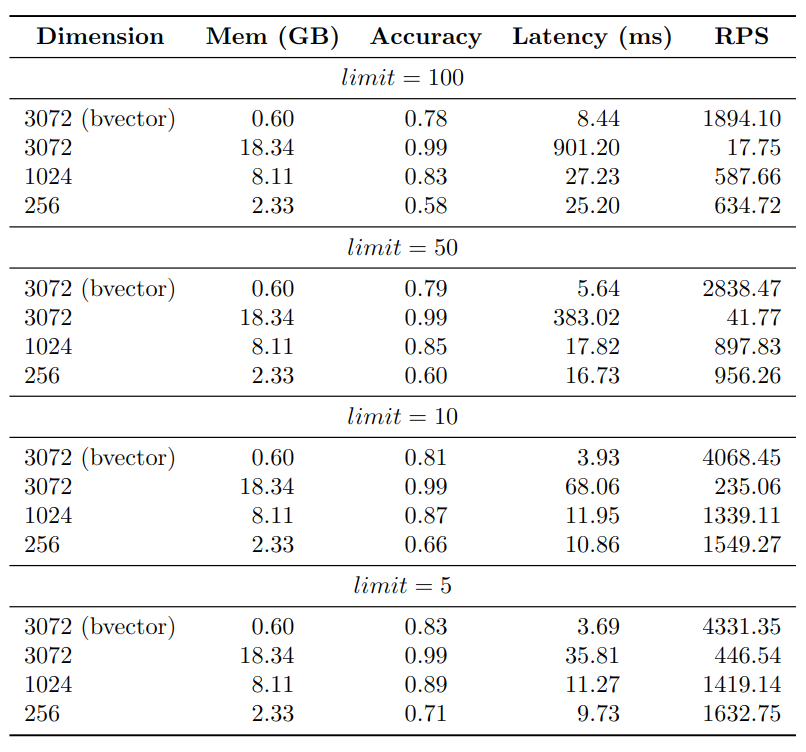
索引的内存占用是另一个需要重点考量的方面。为 100 万条 3072 维的二值向量建立索引仅需约 600MB 内存;相比之下,3072 维浮点向量索引则消耗了约 18GB 内存。两者在内存占用上存在巨大差异——3072 维浮点向量索引消耗的内存约为二值向量索引的 30 倍。
通过自适应检索提升准确率
与完整维度索引相比,低维索引和二值向量索引通过牺牲一定的准确率,换取了更高的 RPS 和更低的内存占用。而自适应检索(Adaptive Retrieval)技术可以将两者的优势结合起来,实现兼顾准确率、内存占用和查询速度的优化方案。
自适应检索背后的逻辑非常简单。以“获取前 100 个最佳候选结果”为例,我们可以分两步执行:
- 首先查询低维索引或二值向量索引,从 100 万条嵌入向量中快速召回前 200 个候选结果。这一步操作非常快。
- 使用全维度精确 KNN 查询对候选集进行重排序(Rerank),从中选出最终的前 100 个结果。由于精确 KNN 非常适合在小规模候选集上进行高精度相似度计算,因此在这里用于重排序再合适不过。

虽然重排序步骤会比单次粗召回略慢一点,但它仍然远快于直接查询完整维度的索引。在 pgvecto.rs 中可以通过如下 SQL 函数轻松实现:
match_documents_adaptive 函数接收查询向量 query_embedding 和匹配数量 match_count 作为输入参数。它首先使用 256 维索引从 100 万条记录中检索出 match_count * 2 条候选记录,随后使用 3072 维精确距离对这些候选记录进行重排序,返回最终的前 match_count 条记录。
基于二值向量索引和 1024 维索引的自适应检索函数也可以用完全相同的方式实现。
我们使用自适应检索技术再次运行了基准测试,并在下图中将其标记为 Adaptive Retrieval:
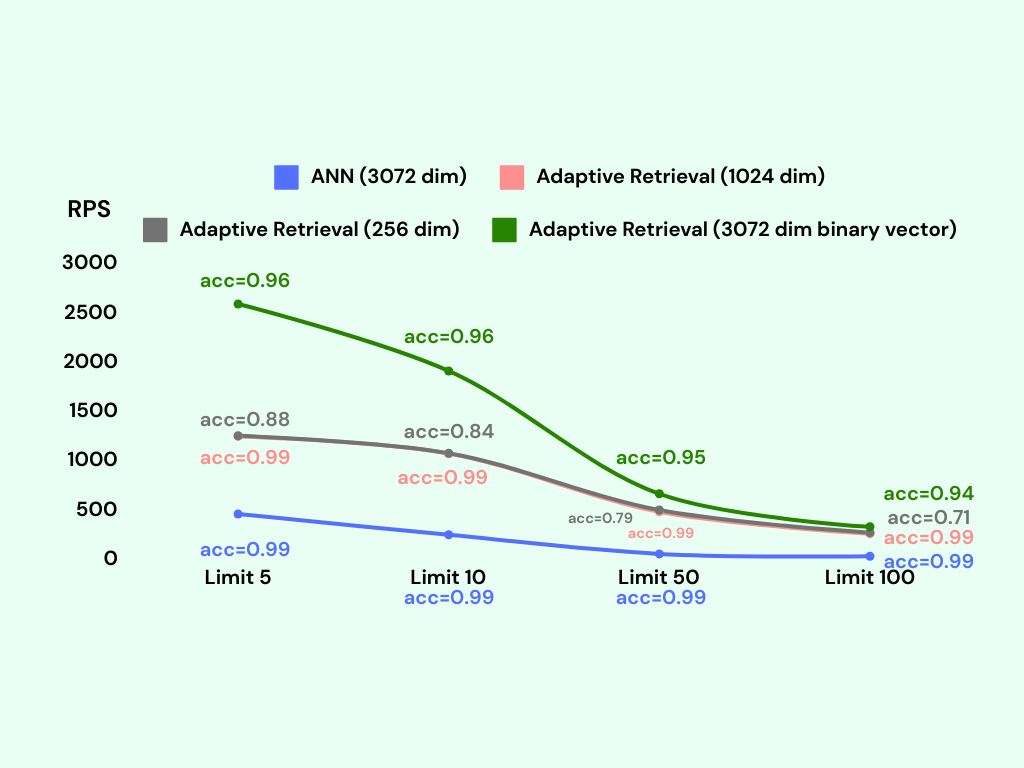
可以看到,增加重排序步骤后,低维索引和二值向量索引的准确率得到了显著提升。
结合自适应检索的二值向量索引达到了约 95% 的准确率,而与不使用自适应检索相比,其 RPS 仅略有下降。更令人印象深刻的是,结合自适应检索的二值向量索引的内存占用依然只有约 600MB,与未启用自适应检索时完全相同(因为完整向量存储在磁盘表中,仅在重排序少量候选行时按需读取)。
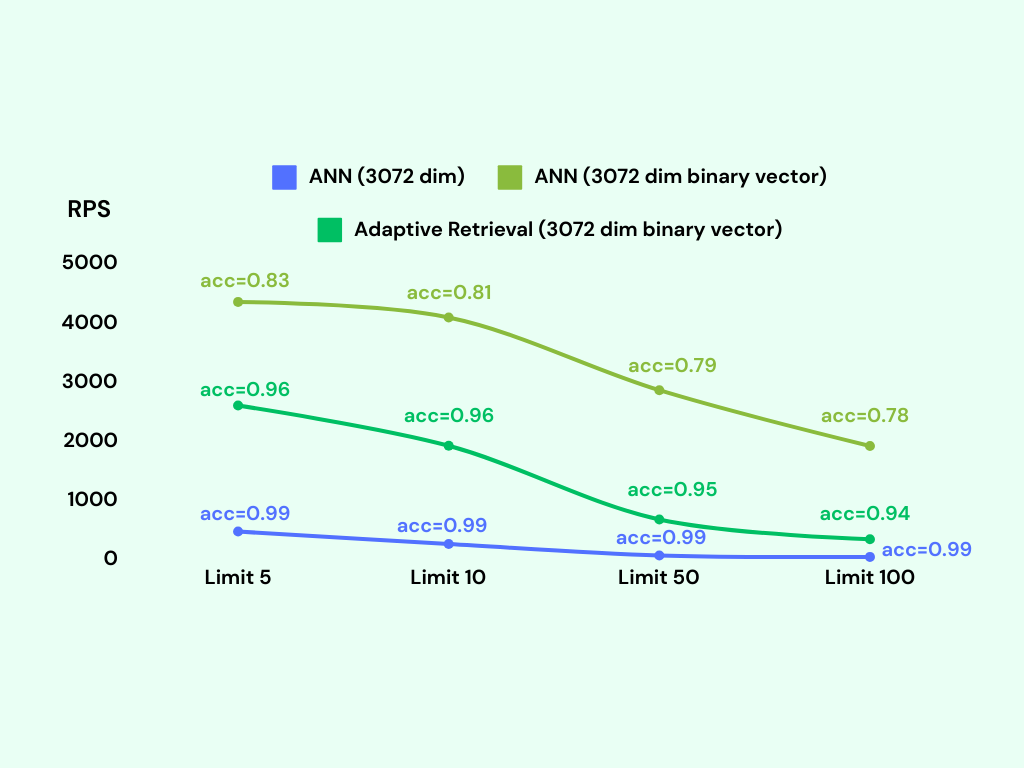
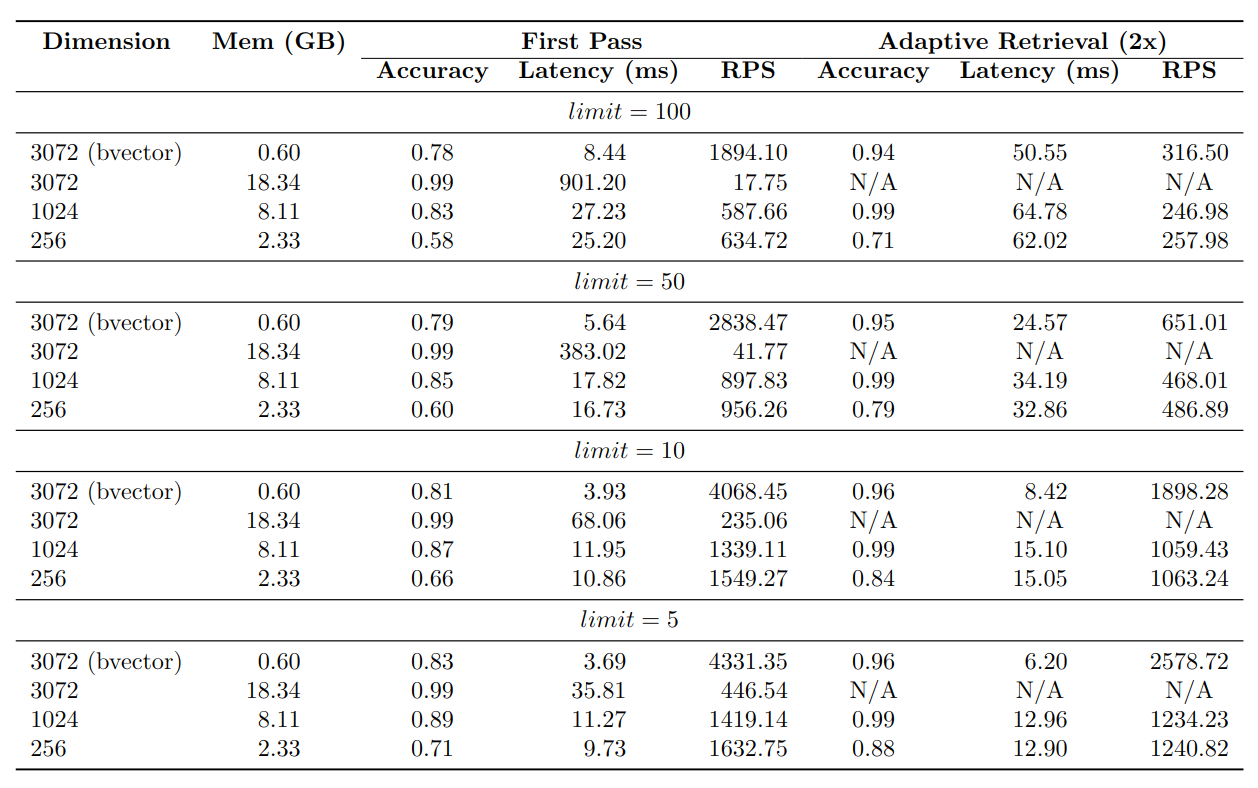
总结
缩短嵌入向量可以减少存储向量所需的内存占用,并加快索引构建和搜索的速度。然而,单纯使用缩短后的嵌入向量在准确率上不及完整嵌入向量。因此,我们需要结合自适应检索(两阶段检索与重排序)技术来提升低维索引和二值索引的准确率。
综合来看,对于 text-embedding-3-large 模型,结合自适应检索的二值向量索引是性价比最高的选择;如果您需要极高的准确率(例如 99%),也可以考虑使用结合自适应检索的 1024 维索引。
附注:本实验中使用的所有代码和数据均已在 pgvecto.rs-matryoshka-embeddings-benchmark 仓库中开源。
3.3 - 以图搜图与智能图像搜索
智能图像搜索,又称基于内容的图像检索(Content-Based Image Retrieval),超越了传统的基于关键词的搜索方式,使用户能够根据图像的视觉内容搜索图像。例如,您可以直接搜索包含红蘑菇的图片(图片来自 immich):
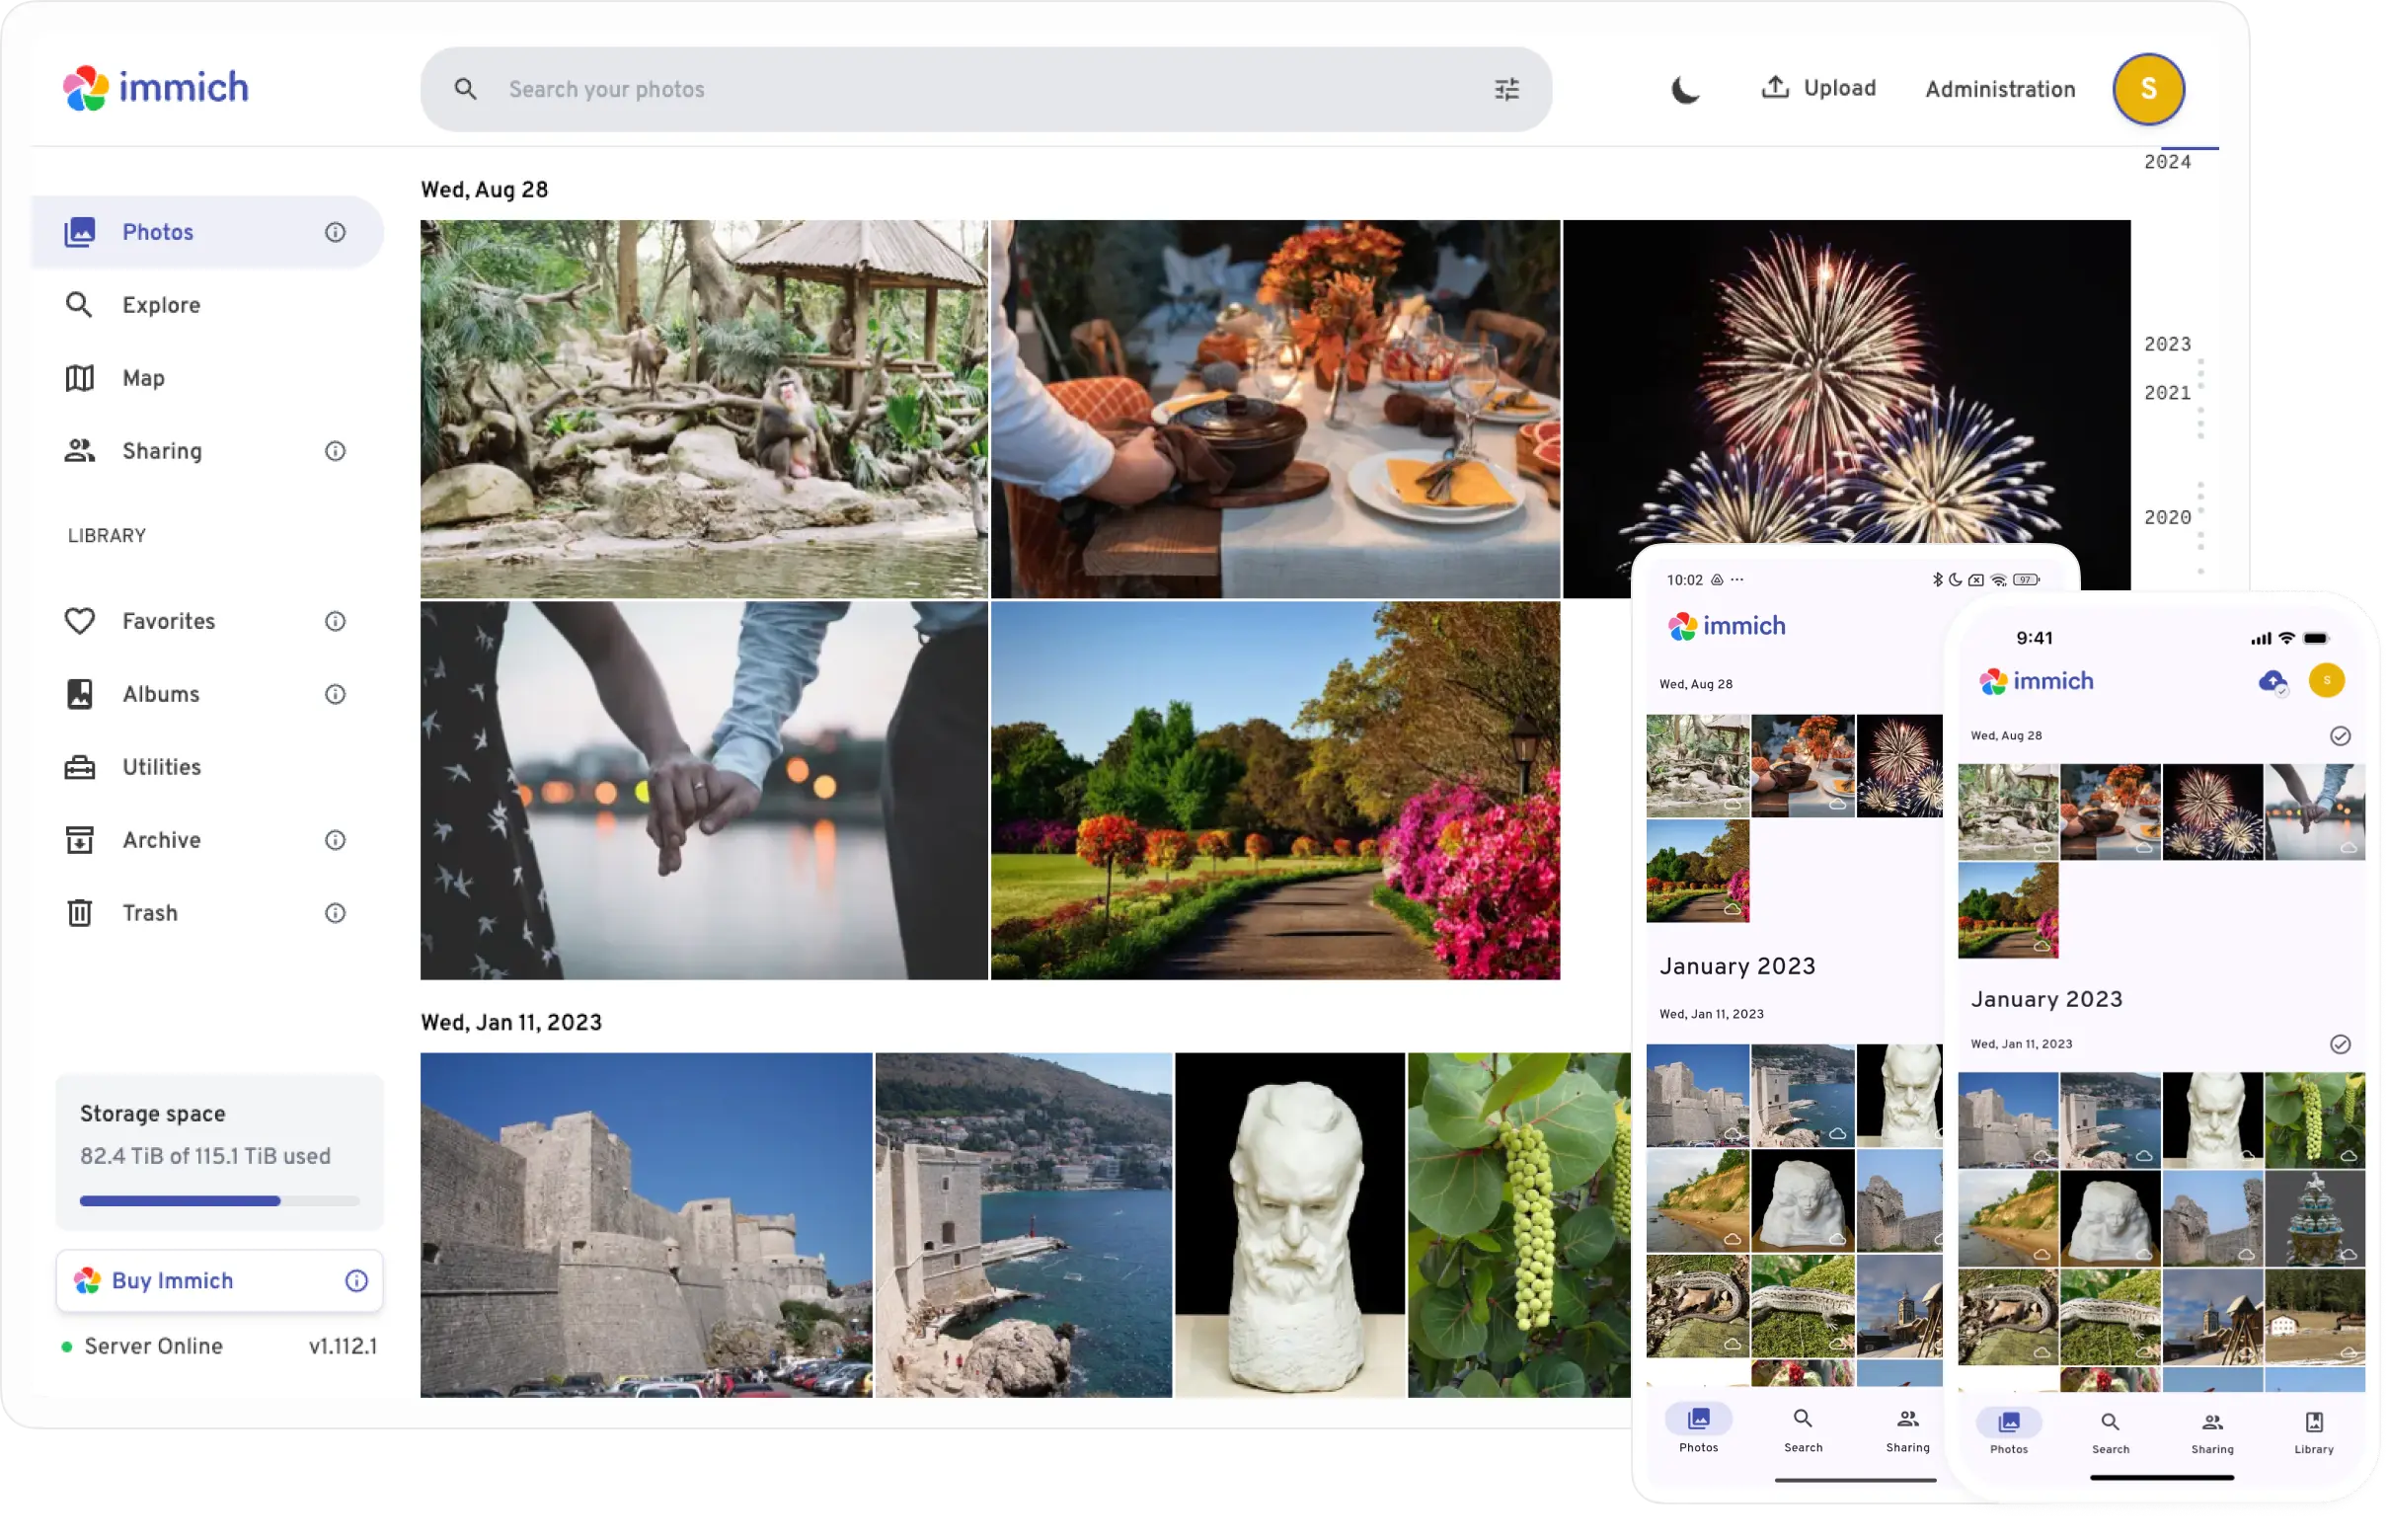
这项功能看似神奇,因为它允许您在没有任何标签或关键词的情况下搜索图片。搜索引擎能够理解图像和视频的内容,并找出与查询语义相似的结果。
工作原理
智能图像搜索利用先进的计算机视觉技术和机器学习算法来理解图像中的视觉特征,从而使用户无需依赖特定的关键词或元数据即可执行自由形式的搜索。
第一步是从图像中提取有意义的特征,并生成每张图像的向量表示。这通常使用诸如 CLIP 之类的深度学习模型来完成。生成的向量表示被称为嵌入(Embedding),它是一个代表该图像视觉特征的数值列表。
随后,您可以使用像 pgvecto.rs 这样的向量数据库来存储这些嵌入向量,并执行高效的向量相似度搜索。
示例
我们将利用连接文本与图像的神经网络模型 CLIP 为图像生成嵌入向量。这些嵌入向量捕捉了图像中呈现的视觉概念。接着,我们将使用基于 Postgres 构建的可扩展向量搜索工具 pgvecto.rs 来存储这些嵌入并执行高效的向量搜索。通过结合 CLIP 和 pgvecto.rs 的强大能力,我们可以根据视觉内容检索相似图像。
生成嵌入向量
您可以使用 CLIP 为图像生成嵌入向量:
存储嵌入向量
假设您有一张名为 images 的表,包含三个列:id、author 和 embedding,其中 embedding 列的类型为 vector(512)。您可以按如下方式将图像数据插入表中:
搜索相似图像
您可以像这样搜索相似的图像:
高级搜索
假设您希望搜索距离最近的 64 条记录,且要求结果中不包含作者 Allen 的图片。
您可能会期望以下 SQL 能够正常工作:
在传统的 basic 搜索模式下,您可能最终只得到了 32 条记录,因为 HNSW 算法在图搜索过程中会绕过过滤条件,仅依赖 PostgreSQL 在搜索完成后对固定数量的候选集进行后置过滤(Post-filtering)。
您可以使用 vbase 搜索模式来解决这一问题。在 vbase 模式下,搜索结果变成了一个迭代器(Iterator),可以持续不断地返回近似最近邻结果。数据库可以从中不断拉取结果,直到满足用户的过滤条件和返回数量要求为止。这与 faiss 等其他向量搜索库截然不同——后者只能返回固定大小的结果集,且该大小必须在搜索前预先确定。对于带有过滤条件的查询,事先无法预知需要检索多少候选集才能凑够目标数量,因此传统做法要么导致返回结果数量不足,要么因过度搜索而增加延迟。该设计思想源于论文 VBASE: Unifying Online Vector Similarity Search and Relational Queries via Relaxed Monotonicity。
您可以通过 SQL 语句 SET vectors.search_mode = vbase; 启用 vbase 模式,从而获得符合预期的行为。immich 的图像搜索功能便采用了这一模式。从 0.2 版本起,vbase 已成为默认搜索模式。
真实生产案例
开源相册应用 immich 使用了智能图像搜索功能,使用户能够根据视觉内容搜索照片。此处提供的代码片段源自 immich 中图像搜索功能的真实实现:
该查询根据指定的过滤条件和向量距离排序,从 asset_entity、smart_search 和 exif_info 三张表中检索数据。下面我们来逐步拆解这条查询:
查询的这一部分指定了要从 asset_entity、smart_search 和 exif_info 表中选择的列,并使用别名 a、s 和 e 分别引用这三张表。
在这里,asset_entity 表别名为 a,smart_search 表别名为 s,exif_info 表别名为 e。查询使用 INNER JOIN 基于条件 s.assetId = a.id 关联 asset_entity 与 smart_search,并使用 LEFT JOIN 基于条件 e.assetId = a.id 引入 exif_info 表中的匹配记录。
asset_entity 表的结构定义如下:
在这一部分中,查询对 asset_entity 表应用了过滤条件:筛选出 ownerId 在指定的 userIds 列表中、isArchived 为 false、isVisible 为 true,且文件创建时间 fileCreatedAt 早于当前时间(NOW())的行。
查询使用余弦距离操作符 <=> 将 smart_search 表的 embedding 列与传入的查询向量 :embedding 进行比较,并按距离从小到大排序。
最后,将查询返回的行数限制为 :numResults 参数指定的值。
这是一个典型的真实生产环境案例,展示了如何在实际业务系统中结合关系查询、权限过滤与向量搜索来实现智能图像检索。
3.4 - 多租户架构
多租户(Multi-tenancy)对于 SaaS 应用至关重要,它允许单个数据库实例同时服务多个用户或团队,同时确保数据隐私与隔离安全。本文将介绍如何使用 pgvecto.rs 设计并实现一个简洁的多租户向量搜索系统。
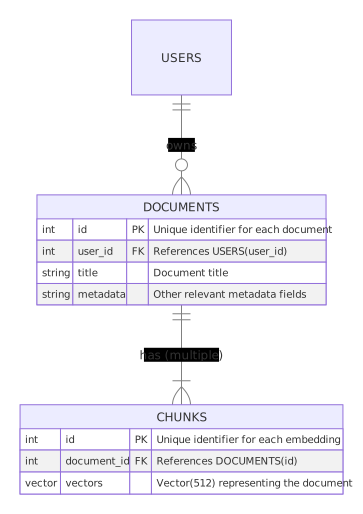
设计数据库表结构
在多租户系统中,基于用户的隔离能否成功,取决于结构良好的数据库 Schema 设计:
用户与文档(Users and Documents)
每个用户由唯一的 user_id 标识,该标识直接关联到其拥有的文档以实现私有访问控制。documents 表存储每个用户的文档,每篇文档具有唯一的 id、title(标题)和 content(内容)。还可以在 documents 表中加入其他元数据字段以增强搜索功能。为了更真实地还原生产场景,我们将 user_id 关联在 documents 表上,而不是直接冗余在切片嵌入(chunk embeddings)表中。
文本切片(Chunks)
chunks 表用于存储文档切片的向量化表示(embedding),并通过外键 document_id 引用其所属的文档。
实体关系图(ER 图)
实现多租户查询
创建索引
在 chunks.embedding 列上创建向量索引以加速查询过程。这里我们使用点积(dot product)作为相似度度量方式:
按 user_id 执行带过滤的向量查询
在这条查询中:
SELECT子句包含了chunks.id AS chunk_id、documents.id AS document_id和documents.title,分别返回切片 ID、文档 ID 和文档标题。INNER JOIN与WHERE条件确保只检索属于指定用户(如'alice')的文档所关联的文本切片。ORDER BY子句计算切片嵌入向量与给定查询向量'[3,2,1]'之间的距离,并按相似度排序,最接近(最相似)的切片会排在最前面返回。- 在实际使用时,请将
'[3,2,1]'替换为真实的查询嵌入向量,并将'alice'替换为目标用户的实际 ID。
性能优化建议
在带过滤条件的向量搜索过程中,索引会扫描额外的候选点并逐一评估过滤条件。因此,如果系统中的用户 ID 数量非常庞大,或者某个用户的过滤条件命中率极低(数据极其稀疏),查询速度可能会受到影响。为了进一步提升大规模多租户场景下的性能,建议结合使用 PostgreSQL 的表分区(Partitioned Table)功能按租户进行分区。
3.5 - 稀疏向量搜索
过去,混合搜索(Hybrid Search)通常将传统的基于关键词的搜索与基于向量的相似度搜索结合在一起。然而,稀疏向量(Sparse Vector)可以作为关键词搜索的替代方案,通过纯向量搜索充分释放数据流水线的全部潜力。
有关基于关键词的混合搜索的更多信息,请参阅混合搜索。
本文将探讨如何结合使用 BGE-M3 与 pgvecto.rs,同时利用稀疏向量和稠密向量发掘混合搜索的潜力。
下面让我们开始吧。
稀疏向量与稠密向量嵌入概览
稀疏向量是仅包含极少数非零值的高维向量,非常适合传统的信息检索场景。例如,一个拥有 32,000 个维度但只有 2 个非零元素的向量就是典型的稀疏向量。
稠密向量(Dense Vector)则是来自神经网络的嵌入表示。它们由文本嵌入模型生成,绝大部分或所有元素均为非零值。它们的维度通常较低,例如 256 维或 1536 维,远低于稀疏向量。
稠密向量和稀疏向量都用于表示文本片段的特征,但两者存在显著差异。稠密向量嵌入中的单个维度本身并没有明确的字面含义,因为它过于抽象;只有将所有维度组合在一起时,它们才能表达输入文本的整体语义。
相比之下,稀疏向量的维度等于词表(Vocabulary)的大小,其中每个元素代表对应词项在该文本中的权重。
通常情况下,权重越高的词在文本中越重要。稀疏向量简化了对文本与词表之间关系的分析和可视化;而若要对稠密向量进行可视化,则需要借助额外的降维算法,例如:
| 稠密向量(Dense Vector) | 稀疏向量(Sparse Vector) | |
|---|---|---|
| 维度规模 | 数百至数千维 | 数万至数十万维 |
| 单个元素含义 | 无单独含义 | 词项权重(Word Weight) |
| 可解释性 | 困难 | 容易 |
| 常见用途 | 计算向量距离 | 计算向量距离 / 可视化分析 |
| 语义敏感度 | 高 | 低 |
与稠密向量相比,稀疏向量在捕捉词与词之间的深层语义关系(尤其是同义词和相关概念)方面通常不如稠密向量有效。
例如,rocket(火箭)和 SPACE X 都与太空探索相关,稠密向量更有可能识别出它们之间的语义相似性,并为相应文本赋予更近的向量距离。
如何生成向量嵌入?
向量嵌入是输入数据在深度学习模型(即嵌入模型)中的内部表示。大多数嵌入模型(如 text-embedding-3-small)仅输出稠密嵌入。
而 SPLADE 和 BGE-M3 等模型则可以生成稀疏嵌入(有时也称为词法权重 lexical weights)。在本节中,我们将介绍如何使用 BGE-M3 模型同时生成稠密向量和稀疏向量。
BGE-M3 是一个多功能模型,能够同时执行嵌入模型的三种常见检索功能:稠密检索(Dense retrieval)、多向量检索(Multi-vector retrieval)和稀疏检索(Sparse retrieval)。下面我们来学习如何用它生成稠密嵌入和稀疏嵌入。
对于所有句子和词项,可以构建如下的“文本-词项”矩阵:
| 文本 | What | is | BM | 25 | ? | Definition | of | … |
|---|---|---|---|---|---|---|---|---|
| What is BM25? | 0.08 | 0.08 | 0.13 | 0.25 | 0.04 | 0 | 0 | … |
| Definition of BM25 | 0 | 0 | 0.25 | 0.33 | 0 | 0.14 | 0.06 | … |
当包含整个词表时,该矩阵是高度稀疏的——大多数词只出现在少数几个句子中,只有这些位置会产生非零权重。
通过将文本输入到像 BGE-M3 这样的稀疏嵌入模型中,我们可以轻松获得文本的稀疏嵌入表示:
现在我们同时拥有了稀疏嵌入和稠密嵌入,接下来可以将它们插入向量数据库了。
在 pgvecto.rs 中存储向量
首先,向量存储和检索需要一个运行中的 pgvecto.rs 实例。可以通过官方的 pgvecto-rs Docker 镜像快速启动:
准备好数据库环境后,让我们创建一张表来存储向量。
pgvecto.rs 通过不同的数据类型分别支持稠密向量和稀疏向量:
vector:用于存储稠密向量svector:用于存储稀疏向量
BGE-M3 模型的稠密嵌入维度为 1024,而稀疏嵌入维度为 250002(与分词器词表的大小一致)。
在本例中,我们创建一张名为 documents 的表,包含四个列:ID 列(id)、文本列(text)以及两个向量列(sparse 用于存储稀疏向量,dense 用于存储稠密向量)。
表创建完成后,我们可以将嵌入向量插入表中,并为两个向量列分别创建索引:
对于稠密向量,vector_l2_ops 计算平方欧氏距离,这是最常用的距离度量:
对于稀疏向量,svector_dot_ops 计算负点积,这种计算方式在稀疏表示下更加高效:
有关 pgvecto.rs 中索引类型的更多信息,请查看我们的索引文档。
检索与结果融合
将向量存入数据库后,我们便可以使用 pgvecto.rs 扩展高效地查询它们。为了找出与给定输入文本最接近的向量,我们需要使用相同的模型对查询文本进行编码。
该编码过程与上一节完全一致:
借助 pgvecto.rs 扩展,只需通过简单的 SELECT 语句即可分别检索稀疏向量和稠密向量:
为了对合并后的结果进行重排序(Rerank),您可以使用常见的融合算法,例如倒数排名融合(Reciprocal Rank Fusion, RRF)。不过,为了充分发挥 BGE-M3 生态的优势,我们可以引入配套的 Reranker(重排序)模型。与嵌入模型不同,Reranker 直接以查询文本和候选文本对作为输入,并输出它们之间的相关性得分。
我们可以初始化一个 Reranker 模型,并将合并后的候选文本输入其中。通过这种方式,只需按 Reranker 模型估算的得分进行排序,即可轻松完成重排序:
恭喜!至此,我们已经迈出了探索稀疏向量搜索世界的第一步。
3.6 - 生成式问答(Generative QA)
向量搜索还可以用于为生成式模型(例如 OpenAI 的 GPT 系列)提供上下文,从而提升模型输出的质量。
本文将探讨如何使用 pgvecto.rs 构建向量知识库并从中检索信息,以增强生成式模型在问答(Question-Answering, QA)任务中的表现。知识库充当了生成式模型的“长期记忆”,为其提供持久化、经过整理且准确的信息作为上下文(Context),供模型在生成问题答案时参考。这样不仅能生成更准确的回答,减少模型产生“幻觉”(毫无事实依据的陈述)的可能性,还能增强用户对输出结果的信任。这项技术被称为检索增强生成(Retrieval-Augmented Generation,简称 RAG):更多信息请参阅这篇博文或相关论文。
问答任务概览
生成式模型的问答(QA)任务是一种**信息检索(Information Retrieval)**方法。模型接收一个问题,并根据给定的上下文(通常是模型可以查阅以获取回答问题所需信息的文档或其他信息源)生成答案。
在本案例中,我们将使用 Hugging Face 上的 vishnupriyavr/wiki-movie-plots-with-summaries-faiss-embeddings 数据集,为 OpenAI 的 gpt-3.5-turbo-instruct 模型提供上下文,以回答有关电影的问题。
整体工作流程如下所示:
无上下文的问答
首先,让我们尝试在不提供任何上下文的情况下让模型回答几个问题。
我们先定义一个函数,用于简化向模型发送提示词(Prompt)并获取响应的过程:
获取 api_key 需要拥有 OpenAI 账号。登录后,可从右上角下拉菜单中申请 API 密钥,并将其粘贴替换代码中的 YOUR_API_KEY_HERE。
让我们先提问一部知名度较高的电影:
The release year of Skyfall is 2012. The overall plot follows James Bond as he investigates an attack on MI6 and uncovers a sinister plot by a former agent seeking revenge on M and the entire agency. Bond must confront his past and protect MI6 from destruction.
回答相当准确,尽管剧情简介略微笼统。但是,如果换作一部知名度低得多的电影呢?
The release year of Cat Napping is unknown. The overall plot of Cat Napping is about a group of cats who go on a mission to rescue their friend who has been kidnapped by a group of evil dogs. Along the way, they encounter various challenges and obstacles, but with their cleverness and teamwork, they are able to save their friend and defeat the dogs.
《Cat Napping》(猫咪午睡)实际上是 1951 年上映的一部《猫和老鼠》(Tom and Jerry)动画短片,讲述了汤姆和杰瑞争夺一张吊床的故事。
我们已经触及了模型自身“知识”的边界:它无法给出上映年份,并且仅凭片名编造了一段剧情。接下来,我们将通过构建一个供模型检索的知识库来解决这一问题。
要让模型更好地回答我们的问题,通常有两种选择:
- 使用目标领域的文本数据(本例中为电影数据)对模型进行微调(Fine-tune)。
- 采用检索增强生成(RAG),在流程中引入信息检索组件。这使我们能够检索相关信息并将其作为辅助信息源输入给模型。
在本文中,我们将采用第二种方案。
构建知识库
让我们使用 Hugging Face 上的 vishnupriyavr/wiki-movie-plots-with-summaries-faiss-embeddings 数据集构建一个电影知识库,以便从中检索相关信息。该数据集包含 33,155 部电影的片名、上映年份、演员阵容、维基百科页面、剧情简介/长度,以及这些信息的向量嵌入(Vector Embeddings)。每部电影还包含一个综合了片名、上映年份、演员阵容和剧情简介的 text 字段。在本应用中,我们将使用其中的 text 和 embeddings 数据。
加载数据
首先加载数据集:
生成向量嵌入
由于该数据集自带了向量嵌入,您可以跳过生成步骤,直接使用现成的嵌入数据:
如果您希望从文本数据生成向量嵌入,可以使用 OpenAI、Cohere 或其他嵌入 API。下面我们提供一个使用 Cohere API 的示例(您可以在此处获取 Cohere API 密钥):
本案例中的嵌入为稠密向量(Dense Vectors)。如需创建稀疏向量(Sparse Vectors),请参阅稀疏向量章节。
将数据插入数据库
向量存储与检索需要部署一个 pgvecto.rs 实例。我们可以使用官方的 pgvecto-rs Docker 镜像:
安装用于与 Postgres 交互的 psycopg 库,并确保扩展已启用:
现在,我们创建一张名为 movies 的表,包含三个列:ID 列(id)、文本列(text)和向量列(embedding)。
由于我们处理的是稠密向量嵌入,因此使用 vector(n) 类型,其中 n 是每个嵌入向量的维度(本例中为 768)。
表创建完成后,我们可以将数据集中的嵌入插入表中:
根据待插入数据量的大小,此过程可能需要花费一些时间。
创建索引
回顾一下,对于稠密向量,vector_l2_ops 计算的是平方欧氏距离(Squared Euclidean distance),这也是最常用的距离度量方式:
结合上下文的问答
为了利用我们的知识库,首先需要对查询语句进行编码,以确定应当检索哪些文本:
接下来,我们定义一个函数,自动将检索到的上下文拼接到初始提示词中:
回顾一下距离操作符的选项:
<->:平方欧氏距离(Squared Euclidean distance)<#>:负点积(Negative dot product)<=>:余弦距离(Cosine distance)
有关详细定义,请参阅概览。
现在,让我们附上检索到的上下文,再次尝试之前的提问:
The release year of Cat Napping is 1951 and the overall plot involves Tom and Jerry fighting over a hammock, with Jerry ultimately getting revenge on Tom.
现在模型给出了准确的回答!我们甚至可以针对细节进一步追问:
Tom tries to send Jerry sliding into a nearby pond by unhooking the hammock he is sleeping in. He also tries to whack the hammock to send Jerry flying into the air, but Jerry lands in a bird’s nest. Tom then picks Jerry up on a spatula and places him onto a walking army of ants, causing Jerry to wake up as he bumps his head on a sprinkler. Tom also tries to chase Jerry with a lawn mower and a baseball bat.
正如我们在前文中所看到的,大语言模型(LLM)本身虽然非常强大,但在面对冷门或特定领域的问题时往往力不从心,容易产生不易察觉的“幻觉”。引入向量知识库能够显著提升回答的事实准确性,进而增强用户对生成结果的信任。
更多应用场景
当然,这种方法不仅限于电影问答。其他应用场景还包括提取科学论文摘要(不妨试试这个数据集!),或者基于企业内部文档库回答有关公司规章制度的问题。
4 - 生态集成
4.1 - LangChain
本文介绍如何将 pgvecto.rs 与 LangChain 集成。
LangChain 是一个用于开发由语言模型驱动的应用程序的框架。它提供了一套工具,支持在生产环境中微调、部署和使用语言模型。
pgvecto.rs 提供了 LangChain 集成,支持在 LangChain 中检索最相似的向量。
安装依赖
使用 LangChain 集成需要安装以下依赖:
你可以在 Docker 容器中启动带有 pgvecto.rs 扩展的 Postgres 实例:
然后可以使用 psql 命令行工具连接到数据库。默认用户名为 postgres,默认密码为 mysecretpassword。
执行以下 SQL 以确保扩展已启用:
创建数据库并加载文档
下面展示如何在 LangChain 中使用 pgvecto.rs 检索最相似的向量。
首先,你需要创建文本加载器(TextLoader)和文本切分器(CharacterTextSplitter),将文本切分为多个片段(chunk)。这里以 Markdown 文件 getting-started/overview.md 为例。
接下来,创建 PGVecto_rs 实例并将文档加载到数据库中。
查询索引
最后,我们可以在 LangChain 中检索最相似的文档片段。
输出结果如下:
从现有数据库初始化
在上面的示例中,我们从零开始创建了一个向量存储。但在很多时候,我们希望连接并使用已有的向量存储,此时可以直接对其进行初始化:
随后,我们可以向存储中添加向量并进行查询:
输出结果如下:
4.2 - LlamaIndex
LlamaIndex 是一个简单、灵活的数据框架,用于将自定义数据源连接到大语言模型(LLM)。
pgvecto.rs 提供了 LlamaIndex 集成,支持检索最相似的向量。
安装依赖
使用 LlamaIndex 集成需要安装以下依赖:
你可以在 Docker 容器中启动带有 pgvecto.rs 扩展的 Postgres 实例:
然后可以使用 psql 命令行工具连接到数据库。默认用户名为 postgres,默认密码为 mysecretpassword。
执行以下 SQL 以确保扩展已启用:
创建数据库并加载文档
首先,创建数据库连接客户端。这里同样以 Markdown 文件 getting-started/overview.md 为例。
接着配置 OpenAI API 密钥,并将文档加载到数据库中。
查询索引
最后,我们可以检索最相似的文档片段。
4.3 - Citus
citus 是一个将 Postgres 转化为分布式数据库的 PostgreSQL 扩展。pgvecto.rs 能够与 citus 良好协作。下面介绍如何在分布式 PostgreSQL 实例中启用向量检索。
citus 支持在单节点(Single-Node)和多节点(Multi-Node)模式下运行,这两种模式均原生兼容 pgvecto.rs。
单节点 Citus
首先,准备一个同时安装了 pgvecto.rs 和 citus 的 Dockerfile,并将它们加载到 PostgreSQL 中。
由于 citus 的自身限制,在 shared_preload_libraries 中必须将 citus 放在第一位。
接着在本地构建名为 citus-vector:16 的 Docker 镜像并启动容器。
请勿在生产环境中使用 POSTGRES_HOST_AUTH_METHOD: "trust"。详细的认证配置请参阅 citus 文档中关于提高 Worker 安全性(Increasing Worker Security)的说明。
要启用所需扩展,请使用 psql 连接到容器并执行以下 SQL 命令:
扩展创建完成后,你可以先创建一张普通表,然后将其转换为分布式表(distributed table)。
之后的索引构建和向量检索操作与单机版完全一致。表和索引会自动分发到所有分片(Shard)/ 工作节点(Worker)上。
多节点 Citus
你可以复用与单节点 Citus 相同的 Dockerfile 和镜像来部署多节点 citus。
在本示例中,我们将使用 Docker Compose 启动一个包含 1 个协调器节点(Coordinator)和 2 个工作节点(Worker)的集群。
请勿在生产环境中使用 POSTGRES_HOST_AUTH_METHOD: "trust"。详细的认证配置请参阅 citus 文档中关于提高 Worker 安全性(Increasing Worker Security)的说明。
使用 Docker Compose 启动所有容器。每个容器对应一个 citus 节点,包括 1 个协调器节点(main)和 2 个工作节点。
与之前一样,需要启用相关扩展,但请确保在所有节点上都执行该命令:
为了让协调器知晓工作节点的信息,请使用 psql 连接到协调器节点,并注册这两个工作节点:
最后,你可以按照与单节点 Citus 完全相同的方式执行向量查询:
监控
如果你使用的是 citus 分布式表,协调器节点上的 pg_vector_index_stat 视图将为空。因为所有索引实际上都创建在工作节点上,所以我们需要将查询分发到各个工作节点来查看向量索引状态:
5 - 运维管理
5.1 - 配置
日志配置
默认情况下,你无法捕获 pgvecto.rs 的全部日志。pgvecto.rs 会启动一个后台工作进程(Background Worker)来构建索引,并将日志输出到标准错误(stderr)。若要捕获这些日志,你需要将 logging_collector 设置为 on。更多详情可参阅 PostgreSQL 关于日志收集器的官方文档。
你可以通过以下命令将 logging_collector 设置为 on:
索引配置
自 v0.3.0 起对于每个索引,都有若干可动态调整的配置项。与创建时的静态选项(options)不同,这些配置项支持在索引创建后进行实时修改。你可以通过 alter_vector_index 函数来修改这些配置项。
目前支持的所有配置项如下:
后端优化线程数
默认情况下,每个向量索引在后端仅由一个线程执行优化。如果你有多个空闲 CPU 核心并希望充分利用它们,可以增加优化线程的数量。
将 key 参数设置为 optimizing.threads,并将 value 参数设置为期望的线程数:
5.2 - 版本升级
通用步骤
如果你将扩展更新到了新版本(假设版本号为 a.b.c),可以使用以下命令更新扩展的 Schema:
如果你是从 0.1.x 版本升级,请先阅读从 0.1.x 升级。
如果你要升级到 0.4.0 版本,请阅读升级到 0.4.0。
随后执行以下 SQL,它会协助完成必要的维护工作:
你需要重启 PostgreSQL 实例以使更改生效。
你可以通过以下命令查看所有向量索引的状态:
假设输出如下:
然后你可以重建所有向量索引:
升级到 0.4.0
如果在将 pgvecto.rs 升级到 0.4.0 之前已经创建了一些索引,你可能会遇到以下错误:
你只需先删除这些索引,然后再升级扩展并重建索引即可:
从 0.1.x 升级
你需要按照以下步骤操作,才能使 ALTER EXTENSION vectors UPDATE 正常工作。
假设你当前的 pgvecto.rs 版本为 0.1.x(请将 x 替换为实际的数字):
从 0.2.0 版本开始,pgvecto.rs 安装在 vectors Schema 下,你可能需要为数据库配置 search_path。
5.3 - 逻辑复制
逻辑复制(Logical Replication)是 PostgreSQL 的一项特性,支持将单个数据库对象或数据子集从一个 PostgreSQL 数据库复制到另一个数据库。
借助逻辑复制,你可以根据预定义的复制规则,有选择地复制特定的表、数据库甚至特定的行。与复制整个数据库集群的物理复制相比,逻辑复制提供了更高的灵活性,允许你设计自定义的复制拓扑结构,并仅复制业务所需的数据。
下面我们将演示如何使用逻辑复制将向量数据从一个 PostgreSQL 数据库复制到另一个数据库。
部署源端和目标端 PostgreSQL 集群
在源数据库和目标数据库中分别创建 vectors 扩展:
配置逻辑复制
现在我们可以在源数据库和目标数据库之间配置逻辑复制。
准备测试数据
我们需要在源数据库和目标数据库中分别创建一张名为 test 的表,其中包含一个类型为 vector(10) 的 embedding 列。然后在源数据库和目标数据库的 test 表的 embedding 列上分别创建索引。最后,向源数据库中插入数据。
创建表
创建索引
我们在源数据库和目标数据库的 test 表的 embedding 列上创建索引。这里使用 flat(暴力搜索)索引类型,并选择 vector_l2_ops(欧氏距离平方)来度量向量之间的距离。其他索引类型和距离函数请参阅索引指南。
插入数据
我们只需要向源数据库插入数据,数据随后会同步到目标数据库。
现在你可以在源数据库中搜索 test 表 embedding 列的最近邻向量:
此时如果查询目标数据库,结果将为空:
设置逻辑复制
为了简化在两个 PostgreSQL 数据库之间配置逻辑复制的流程,我们将使用 pg-easy-replicate。
我们使用 pg-easy-replicate 在源数据库和目标数据库之间建立逻辑复制:
初始化引导(Bootstrap)
在正式设置两个数据库之间的同步之前,每次同步都需要先执行初始化引导(Bootstrap)。Bootstrap 会创建一个新的超级用户来执行后续流程所需的编排操作,同时还会创建一些内部元数据表用于记录状态。
启动同步
Bootstrap 完成后,即可启动同步。启动同步会自动配置发布(Publication)、订阅(Subscription)并完成其他清理维护工作。
测试逻辑复制
查询验证
现在我们可以查询目标数据库,获取 test 表 embedding 列中向量的最近邻。查询结果与源数据库完全一致:
更新索引
如果你向源数据库继续插入新数据,数据也会实时同步到目标数据库。向源数据库插入新数据:
在源数据库中查询:
在目标数据库中查询,将返回相同的结果:
5.4 - 外部数据包装器 (FDW)
外部数据包装器(Foreign Data Wrapper,简称 FDW)是 PostgreSQL 中的一项扩展,允许你像操作本地表一样访问和查询存储在远程数据库中的数据。FDW 提供了一种与不同数据源集成和交互的标准方式。
借助 FDW 扩展,你可以在本地 PostgreSQL 数据库中定义外部表(Foreign Table),用于映射远程数据库中的表结构。这些外部表充当远程数据的代理或包装器,使你能够像操作普通 PostgreSQL 表一样对它们执行 SELECT、INSERT、UPDATE 和 DELETE 操作。
在本教程中,我们将使用内置外部数据包装器的 postgres_fdw 模块。该包装器可用于访问存储在外部 PostgreSQL 服务器中的数据。本文将介绍如何使用 postgres_fdw 访问已安装 pgvecto.rs 扩展的远程 PostgreSQL 集群中的向量索引数据。
部署本地和远程 PostgreSQL 集群
在本教程中,我们将使用 Docker Compose 部署两个 PostgreSQL 集群。
远程数据库操作
首先,我们需要在远程数据库(foreign_db)中创建一张 test 表并在其上构建向量索引。test 表包含两列:id 和 embedding。其中 embedding 列是类型为 vector(10) 的向量列,id 列是 test 表的主键。
创建表
创建用户
在远程数据库中创建一个名为 fdw_user 的用户,并将 test 表上的 SELECT、INSERT、UPDATE、DELETE 权限授予 fdw_user:
创建索引
在 test 表的 embedding 列上创建向量索引。这里使用 flat(暴力搜索)索引类型,并选择 vector_l2_ops(欧氏距离平方)来度量向量距离。其他索引类型和距离函数请参阅索引指南。
本地数据库操作
在本地数据库中,我们需要创建一张本地表 local 和一个外部服务器 foreign_server。local 表包含两列:id 和 name,其中 id 是主键。foreign_server 用于连接访问远程数据库。
创建本地表
创建本地用户
使用超级用户在本地 PostgreSQL 数据库中执行以下语句,创建一个名为 local_user 的普通用户:
创建外部服务器
使用 CREATE SERVER 语句创建外部服务器时,需要指定远程数据库的主机地址、端口和数据库名称:
创建用户映射
使用 CREATE USER MAPPING 语句创建本地用户与远程用户之间的映射关系,需提供远程用户的用户名和密码:
创建外部表
使用 CREATE FOREIGN TABLE 语句创建远程表的映射表。需要注意,每一列的数据类型必须与远程表的实际类型匹配,并且建议保持列名一致;否则,你需要为每个列单独使用 column_name 参数指定远程表中的列名。
权限授予
为 local_user 授予所需权限:
- 授予
local_user使用postgres_fdw的权限。 - 授予
local_user使用外部服务器foreign_server的权限。 - 授予
local_user访问publicSchema 下所有表的权限。
查询测试
现在我们可以在本地数据库中通过连接查询(JOIN)访问外部表:
5.5 - Kubernetes
如果你想在运行于 Kubernetes 上的 PostgreSQL 中使用 pgvecto.rs,可以参考本教程。在本教程中,我们将使用 CloudNative-PG 在 Kubernetes 中部署 PostgreSQL 集群。
环境要求
| 组件名称 | 版本要求 |
|---|---|
| helm | >= 2.4.1 |
| kubectl | >= 1.14 |
| Kubernetes | >= 1.24.0 |
安装 CloudNative-PG
我们使用 CloudNative-PG (cnpg) 在 Kubernetes 中部署 PostgreSQL 集群。你可以通过 Helm 安装它:
构建包含 pgvecto.rs 的 PostgreSQL 镜像
我们以官方的 CloudNative-PG Docker 镜像作为基础镜像,并在其中安装 pgvecto.rs。你可以在 Releases 页面查看可用的 pgvecto.rs 版本。
注意:PostgreSQL Docker 镜像的 Tag 必须以
CNPG_TAG(PostgreSQL 主版本号)开头,以便 CloudNative-PG 识别 Postgres 版本。
创建 PostgreSQL 集群
下面提供一个用于在 Kubernetes 中创建 PostgreSQL 集群的示例 YAML 文件,你可以根据实际需求进行修改。请注意以下两点:
- 配置
shared_preload_libraries以加载pgvecto.rs共享库(也可以在postInitApplicationSQL中配置ALTER SYSTEM SET shared_preload_libraries = "vectors.so";来加载共享库)。 - 执行
CREATE EXTENSION IF NOT EXISTS "vectors";以创建vectors扩展。
你可以安装 cnpg 的 kubectl 插件来管理 PostgreSQL 集群。现在我们可以查看集群状态:
注意:本文仅提供最小化配置示例,不包含逻辑复制、流式复制、备份与恢复等高级配置。更多
Cluster配置项请参阅 CloudNative-PG 官方文档。
连接 PostgreSQL 集群
你可以使用 kubectl port-forward 转发端口并连接到 PostgreSQL 集群:
至此,vectors 扩展已安装成功。你可以跳过安装步骤,直接体验快速开始。
5.6 - 迁移指南
PGVecto.rs 迁移概览
从 pgvector 迁移
前置条件
从 pgvector 迁移到 PGVecto.rs 时,你通常已经有一张包含 vector 类型列的表。例如:
并且表中已经插入了一些数据行:
在大多数情况下,表上还会有一个或多个向量索引:
这是使用 pgvector 时的典型场景。如果满足以下条件,即可开始迁移:
- 请确认你的
pgvector扩展并未安装在vectorsSchema 中。这意味着你可以在同一个数据库中同时安装pgvector和PGVecto.rs。
迁移步骤
1. 安装 PGVecto.rs
请按照安装指南安装 PGVecto.rs,并确保 PostgreSQL 已加载该扩展。
此时,pgvector 和 PGVecto.rs 两个扩展已同时安装在 PostgreSQL 中。
要验证安装结果,请在 psql 中运行 \dx。你会看到代表 pgvector 的 vector 扩展,以及代表 PGVecto.rs 的 vectors 扩展。
请注意,这两个扩展中存在一些同名的类型和符号,这可能会在迁移过程中引起混淆。为了区分二者,请先确认当前的 search_path 中不包含 PGVecto.rs 的 vectors Schema:
2. 检查现有索引
对于在向量列上创建的索引,请先查询其定义并记录下来,以便在后续阶段重建索引。
3. 迁移向量列
要迁移 pgvector 的向量列,第一步是创建一个对应类型的 PGVecto.rs 向量列,第二步是将原列中的向量数据复制到新列中。
以下是 pgvector 各向量类型的转换路径:
vector(pgvector) -> real[] -> vector(PGVecto.rs)halfvec -> vector(pgvector) -> real[] -> vector(PGVecto.rs) -> vecf16bit -> text[] -> real[] -> vector(PGVecto.rs) -> bvector
目前暂不支持迁移以下向量类型:
sparsevec
方法一:先验证再替换
使用此方法,你可以在迁移过程中检查向量数据的正确性,而且无需担心原向量列上已创建的索引(在删除原列时索引会自动删除)。 但这种方法需要额外的存储空间来同时保存迁移前后的向量数据。
此步骤会导致一定的停机时间,原因包括:
ALTER TABLE ADD COLUMN会获取短暂的ACCESS EXCLUSIVE锁UPDATE会持有较长时间的ROW EXCLUSIVE锁ALTER TABLE DROP COLUMN会获取短暂的ACCESS EXCLUSIVE锁
数据复制完成后,你可以通过 SELECT 检查数据,然后用新列替换旧列:
方法二:原地转换(无需额外存储空间)
使用此方法,可以在一条命令内完成列类型转换,无需占用额外的列存储空间。 但你需要提前手动删除该向量列上的索引。
此步骤会导致一定的停机时间,原因包括:
ALTER TABLE ALTER COLUMN会持有较长时间的ACCESS EXCLUSIVE锁
4. 重建索引
要为 PGVecto.rs 的 vector 列重建索引,可以开启兼容模式并直接执行之前的索引创建语句:
对于其他向量类型(如 halfvec、sparsevec 和 bit),请参考索引指南重新创建索引。目前 pgvector_compatibility 兼容模式暂不支持这些类型。
5. 清理环境
如果不再需要 pgvector 扩展,现在可以安全地将其卸载:
卸载 pgvector 扩展后,建议重新设置 search_path,以确保可以在全局直接访问 PGVecto.rs 中的符号:
验证结果
迁移任务执行完毕后,你可以通过 SELECT 语句验证新列的数据与类型:
6 - 常见问题
6.1 - 常见问答
我们强烈建议你了解并选用我们全新的 VectorChord 实现,它提供了更高的稳定性和性能。建议现有用户迁移至 VectorChord,具体步骤请参阅迁移指南。
找不到向量类型或操作符类
在大多数情况下,这是由于缺少 Schema 搜索路径(search_path)或权限不足导致的。
请按照以下检查清单逐一排查:
- 在
psql中运行\dx或执行SELECT * FROM pg_extension;,检查扩展是否已安装:
如果未安装,请执行 CREATE EXTENSION vectors; 进行安装。
- 运行
SHOW search_path;,检查其中是否包含vectors:
如果不包含,请执行 SET search_path="$user", public, vectors; 进行设置。
- 如果
pgvecto.rs是由其他超级用户安装的:
请在 psql 中运行 \dn 或执行 SELECT nspname FROM pg_catalog.pg_namespace;,检查 vectors Schema 是否存在且当前用户是否有权访问:
如果当前用户无权访问,请以超级用户身份登录并将 Schema 权限授予当前用户(current_user):
GRANT ALL ON SCHEMA vectors to tensorchord;
6.2 - 与 pgvector 对比
原文:pgvector vs. pgvecto.rs in 2024: A Comprehensive Comparison for Vector Search in PostgreSQL
太长不看(TL; DR):请直接跳转到总结部分,查看展示两者核心差异的对比表格。
检索能力
检索是数据库的核心能力,对于实现高效的数据获取、帮助用户快速查找所需信息至关重要。下面我们将展示 pgvecto.rs 与 pgvector 的性能表现,并重点对比二者提供的各项功能特性。
过滤检索
虽然 pgvector 和 pgvecto.rs 都支持在 PostgreSQL 中进行向量相似度检索,但 pgvecto.rs 更进一步,引入了来自 OSDI 2023 的 VBASE 方法。
真实业务负载通常涉及向量检索与关系型查询的结合。向量检索擅长相似度匹配与相似向量召回,而关系型查询则支持对结构化数据执行复杂的连接(JOIN)、过滤(Filter)和聚合(Aggregation)。
pgvecto.rs 专为高效处理**单向量 TopK + 过滤 + 连接(Single-Vector TopK + Filter + Join)**场景而设计。
由于目前缺乏通用的关系型向量基准测试集,我们使用 laion-768-5m-ip-probability 数据集进行基准测试。该数据集衍生自 LAION 2B 图像数据集,包含 5,000,000 条向量和 10,000 条查询。
该数据集包含一个 probability 列,用于存储从 0 到 1 均匀分布生成的随机浮点数。选择率(ratio)为 0.01 意味着每次查询过滤后覆盖数据集的 1%(即 0.01 倍),便于开展针对性的选择率分析。
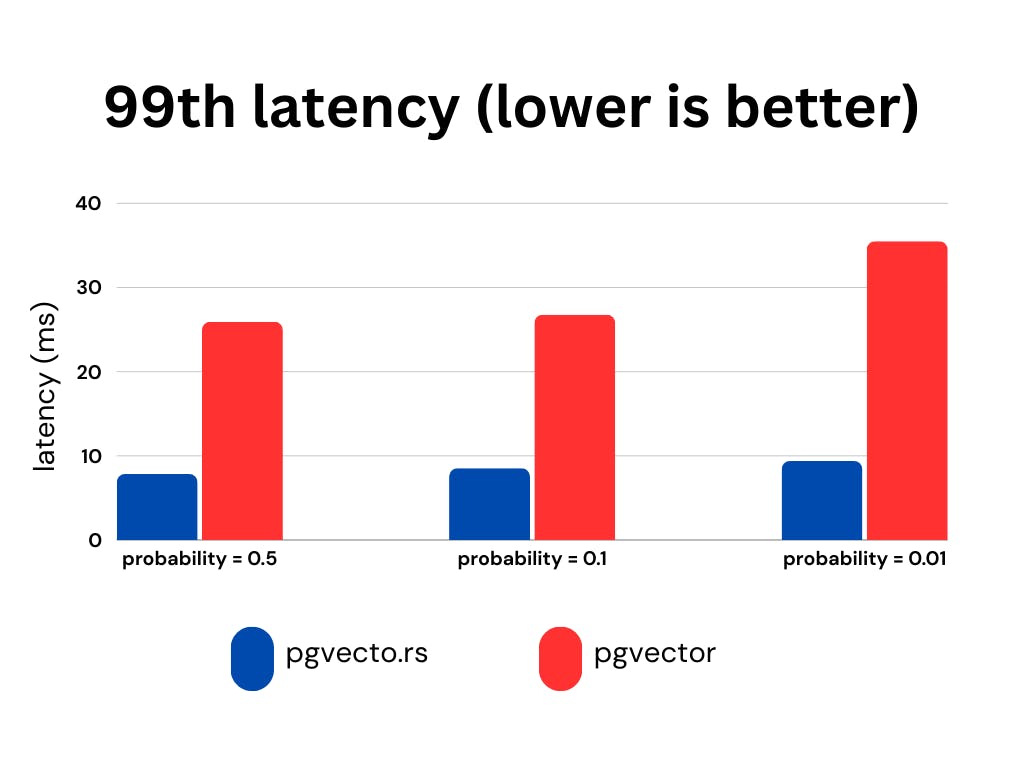
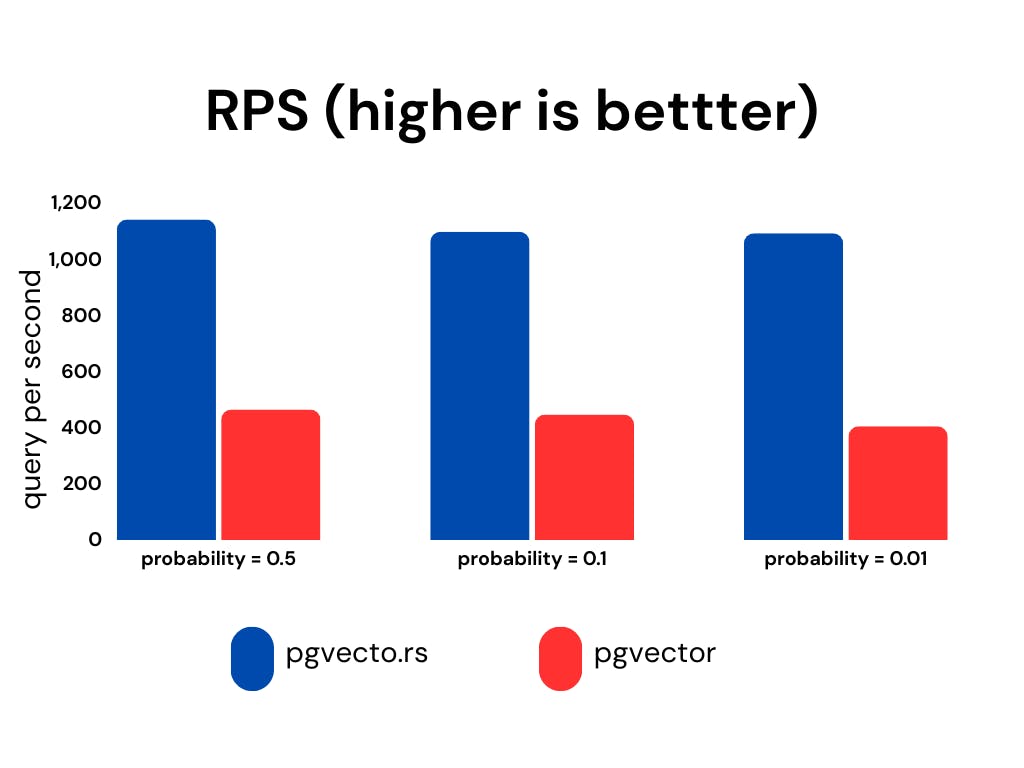
我们在保持 ef_search 不变的前提下,展示了不同 probability 范围下的召回率(Recall)、延迟(毫秒)和每秒请求数(RPS)。ef_search 参数表示 k-NN(k 近邻)搜索期间使用的候选列表大小,决定了搜索精度与查询处理耗时之间的权衡。
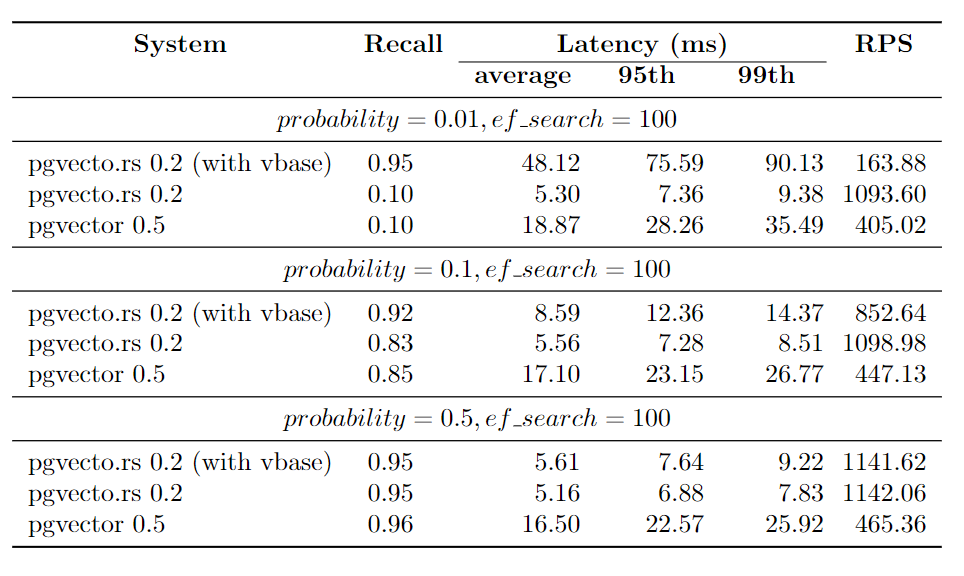
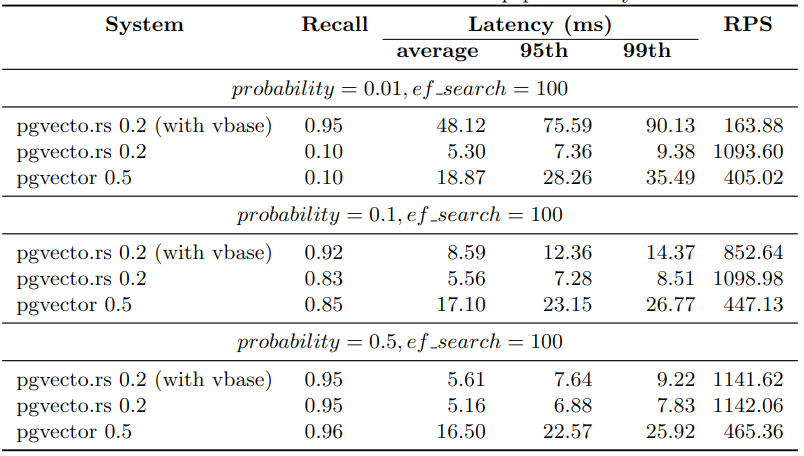
当结合 VBASE 使用时,pgvecto.rs 能够始终保持更高的召回率,尤其是在低选择率(高过滤比)场景下优势极为显著。
稀疏向量检索
稀疏向量是仅包含少量非零元素的高维向量,非常适用于传统信息检索(IR)场景。例如,一个拥有 32,000 个维度但仅有 2 个非零元素的向量就是典型的稀疏向量:
稠密向量则是神经网络生成的嵌入向量(Embeddings),由文本嵌入模型生成,其中绝大多数或全部元素均为非零值。它们的维度通常较低(如 256 或 1536 维),远小于稀疏向量:
pgvecto.rs 同时支持稠密向量检索和稀疏向量检索。它提供了 svector 数据类型,用于构建稀疏向量索引并执行高效检索:
向量维度上限
pgvecto.rs 扩展支持最高 65,535 维的向量,而 pgvector 扩展的 vector 索引最多仅支持 2,000 维。这一维度上限的差异使得 pgvecto.rs 能够直接处理 OpenAI 最新高维嵌入模型生成的向量。
单指令多数据流(SIMD)
pgvecto.rs 会在运行时动态检测并利用用户机器上可用的最优 SIMD(单指令多数据流)指令集;而 pgvector 则依赖编译器在编译期生成静态 SIMD 代码,无法在运行时针对宿主机的硬件特性自动选择更快的指令集。更快的向量距离计算使得 pgvecto.rs 的检索速度更具优势。
数据类型
二值向量
bvector 是 pgvecto.rs 中的二值向量类型,表示每个分量仅取两个可能值(通常为 0 和 1)的向量。
在配合特定嵌入模型(如 OpenAI 嵌入模型)使用时,二值向量具有显著优势:它能在保持理想召回精度的同时,大幅降低内存占用。
以下是 bvector 类型的性能基准测试,采用 dbpedia-entities-openai3-text-embedding-3-large-3072-1M 数据集,测试环境为 Google Cloud 上的 n2-standard-8(8 vCPU,32 GB 内存)虚拟机。
我们将 100 万条二值向量写入表中并建立索引,随后对每条查询运行 KNN 搜索。为 100 万条二值向量建立索引仅需约 600 MB 内存,而使用 vector 类型为相同数量的向量建立索引则需要约 18 GB 内存。如果结合采用自适应检索(Adaptive Retrieval),bvector 的准确率可超过 95%。
FP16/INT8
除二值向量外,pgvecto.rs 还支持 FP16(16 位浮点数)数据类型以及 INT8(8 位整数)量化存储。
索引架构
与 pgvector 相比,pgvecto.rs 采用了不同的索引架构设计。它独立于 PostgreSQL 管理索引的存储与内存,而不是像 pgvector 那样依赖 PostgreSQL 的原生页面存储引擎。
这是一种工程架构上的权衡。在开发初期,我们也曾尝试像 pgvector 一样基于 PostgreSQL 的页面存储(Page Storage)来实现分层可导航小世界(HNSW)图索引,但遇到了诸多制约其性能与功能的瓶颈:
- 并行化难题:PostgreSQL 采用单语句单进程模型,且内部 API 并非线程安全,这给多线程并行带来了巨大挑战。构建向量索引属于计算密集型任务,并行化能显著提升性能;但我们在尝试并行化该过程时,频繁遭遇
Too many shared buffer locked(锁定的共享缓冲区过多)错误。 - 预写式日志(WAL)写放大:插入一条 2 KB 的向量往往会产生超过 20 KB 的 WAL 日志。这一问题源于 HNSW 算法本身的特性——每插入一个节点都需要修改图中的多条边,而 PostgreSQL 会在 WAL 中逐条记录每一次页面修改,从而导致严重的 WAL 写放大。
- 锁竞争(Lock Contention):在遍历和更新 HNSW 图时,读写操作都需要对边列表加锁。由于 HNSW 采用分层结构,越高的层级包含的节点越少,导致高层节点在索引并发读写时极易成为锁竞争瓶颈,进而引发延迟升高和并发吞吐量下降。
为此,pgvecto.rs 采用了类似 FreshDiskANN 与日志结构合并树(LSM-Tree)的架构设计。该架构由三个组件构成:写入段(Writing Segment)、增长段(Growing Segment)和封存段(Sealed Segment)。新写入的向量首先进入写入段,随后由后台进程异步转换为不可变的增长段,最后增长段会与封存段进行合并(类似于 LSM-Tree 中的 Compaction 过程)。这种设计带来了诸多优势:
- 非阻塞插入:索引的后台构建与优化不会阻塞前台的数据插入操作。
- 批量更新图结构:将对 HNSW 图的修改进行批量聚合处理,显著提升了写入吞吐量。
- 消除读写锁竞争:由于封存段(Sealed Segment)是不可变的(Immutable),彻底缓解了并发检索时的读写锁竞争问题。
当然,这种独立存储方式也存在不足,其中最主要的一点是索引无法直接获得 PostgreSQL 开箱即用的预写式日志(WAL)支持。这意味着依赖 WAL 的时间点恢复(PITR)和物理复制(Physical Replication)无法直接作用于索引文件(注:这一限制已在后续的继任项目 VectorChord 中通过原生 PostgreSQL 存储引擎架构彻底解决)。
总结
下表汇总了 pgvecto.rs 与 pgvector 之间的主要区别:
| 特性 | pgvecto.rs | pgvector |
|---|---|---|
| 过滤检索(Filtering) | 引入 VBASE 方法,专为向量检索结合关系型查询(如单向量 TopK + Filter + Join)深度优化。 | 应用过滤条件时可能出现召回结果不足的情况(例如原本指定 LIMIT 10,过滤后可能只返回 5 条结果)。 |
| 向量维度上限 | 最高支持 65,535 维。 | 索引最高支持 2,000 维(vector 类型)。 |
| SIMD 加速 | 在运行时根据宿主机硬件能力动态派发最优 SIMD 指令集,最大化计算性能。 | 依赖编译器在编译期生成的静态 SIMD 代码。 |
| 数据类型 | 提供丰富的数据类型支持:稠密向量、稀疏向量、二值向量、FP16(16 位浮点数)以及 INT8 量化。 | - |
| 索引存储架构 | 独立于 PostgreSQL 管理索引的磁盘存储与内存映射。 | 依赖 PostgreSQL 原生页面存储引擎。 |
| WAL 支持 | 表数据支持预写式日志(WAL),索引的 WAL 支持尚在开发中。 | 表数据和索引均支持预写式日志(WAL)。 |
6.3 - 为什么不使用专用向量数据库?
欢迎阅读我们的完整博客文章:我们真的需要专用向量数据库吗?(2023) | vchord.pgsty.com。
试想一下:你现有的业务数据已经存储在 Postgres 数据库中,现在你希望引入向量数据库来执行向量相似度检索。如果采用专用向量数据库,你就必须将数据从 Postgres 同步迁移到向量数据库中,并且同时运维两套数据库系统。这显然不是一个好主意。
为什么不直接使用 Postgres 来完成向量相似度检索呢?这正是我们构建 pgvecto.rs 的初衷。使用体验非常自然直观:
引用自 SingleStore DB 博客:
向量和向量检索本质上只是一种数据类型和一种查询处理方式,而不是构建全新数据处理范式的基石。使用专用向量数据库(SVDB)会导致我们在使用多套专用系统的客户身上反复看到的那些典型问题:数据冗余、过度的数据迁移、分布式组件之间的数据不一致、需要专门技能带来的额外人力成本、额外的商业授权费用、受限的查询语言表达能力与可编程/可扩展性、匮乏的工具链生态集成,以及与真正的数据库管理系统(DBMS)相比糟糕的数据完整性与高可用保障。
6.4 - 基准测试
pgvecto.rs 从诞生之初就高度专注于性能。我们持续监控 pgvecto.rs 的性能表现,并与其他向量检索库进行对比测试。以下基准测试结果来自 2024 年 1 月。
测试在 Google Cloud n2-standard-8(8 vCPU,32 GB 内存)实例上进行,使用 laion-768-5m-ip 数据集。
pgvecto.rs 对比 pgvector
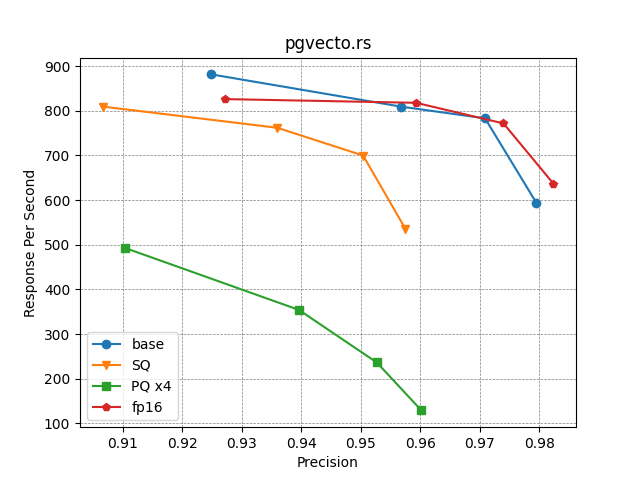
在使用 HNSW 索引时,pgvecto.rs 在保持约 97% 略高召回精度的同时,每秒响应数(RPS)可达到 pgvector 的 2.5 倍。当对召回精度要求更高时,这一性能优势还会进一步扩大。
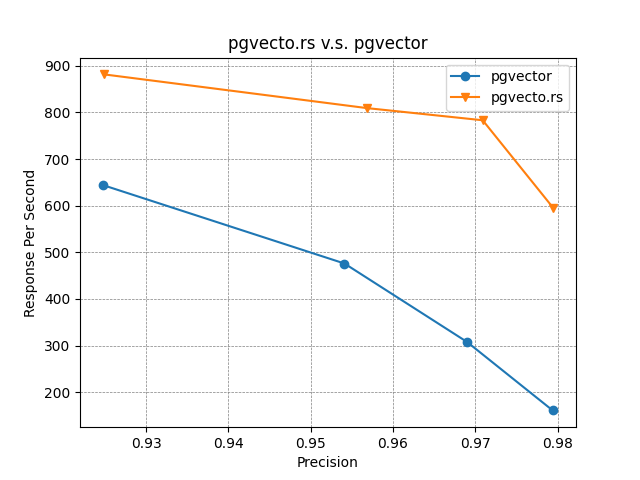
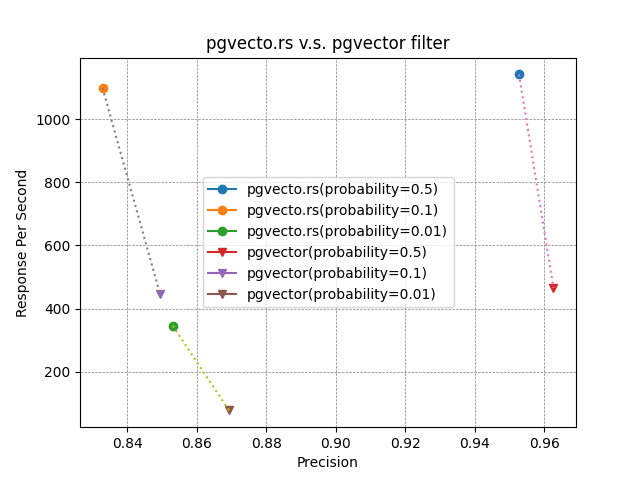
启用 vbase 模式后,在不同的过滤条件选择率(filter probability)下,pgvecto.rs 的每秒响应数相比 pgvector 均可提升 2 倍以上。
不同量化方法的对比
pgvecto.rs 支持多种量化方法以及不同低精度的索引方式。这些方法有助于在不同数据规模下大幅降低内存占用。下图展示了 pgvecto.rs 在不同量化方法下的性能表现:
缩短嵌入向量(即 Matryoshka Embedding)
OpenAI 的最新嵌入模型支持缩短嵌入向量(Shortening Embeddings),开发者只需“直接移除序列末尾的部分数值”,即可在更短的维度下依然保留有效的文本语义表征。
这一特性带来了极高的使用灵活性。例如,当使用的向量数据存储仅支持最高 1024 维的嵌入向量时,开发者依然可以使用我们最强大的嵌入模型
text-embedding-3-large,并将 API 参数dimensions指定为 1024,从而将嵌入向量从 3072 维缩短为 1024 维,以极小的精度折衷换取更紧凑的向量体积。
以下是针对缩短后嵌入向量的性能基准测试。测试采用 dbpedia-entities-openai3-text-embedding-3-large-3072-1M 数据集。原始嵌入向量为 3072 维,缩短后的嵌入向量分别为 256 维和 1024 维。基准测试同样在 Google Cloud 的 n2-standard-8(8 vCPU,32 GB 内存)虚拟机上进行。
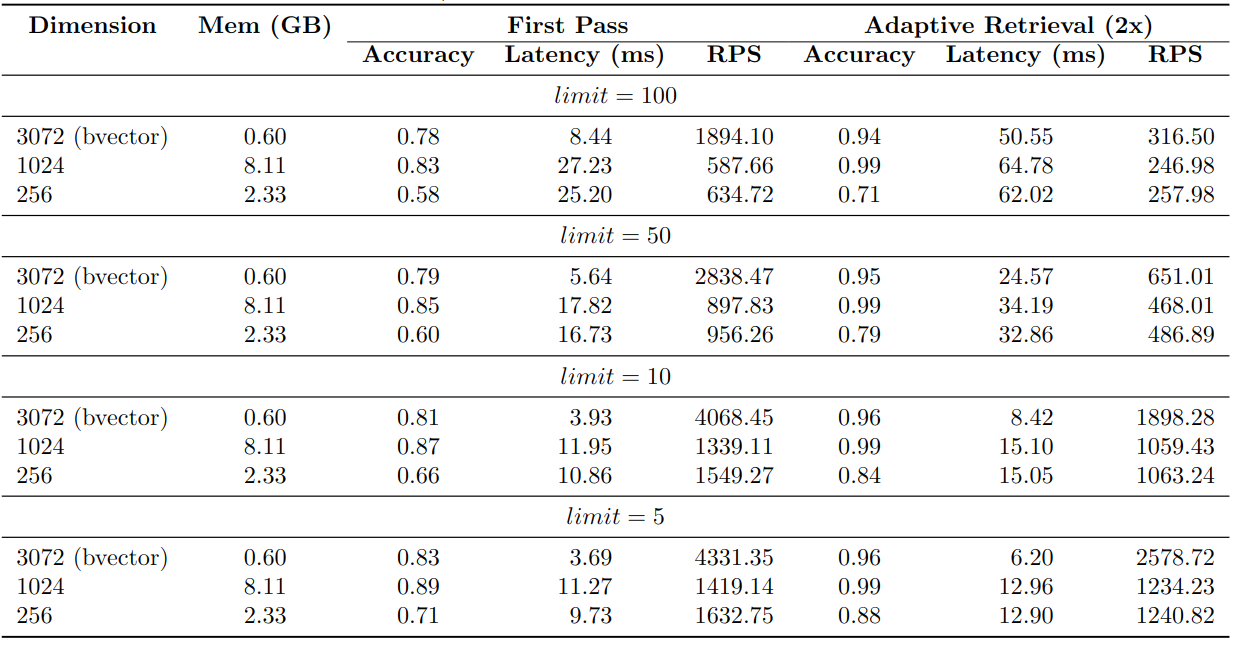
基准测试中的 First Pass(初筛阶段) 表明,仅使用缩短后的嵌入向量时,其召回精度不如完整维度的嵌入向量:256 维 HNSW 索引仅能达到约 65% 的准确率,而 1024 维 HNSW 索引约为 85%。
然而,当结合使用自适应检索(Adaptive Retrieval)时,缩短后嵌入向量的最终准确率能够超过 95%。此外,采用这种方法还能在 RPS(每秒请求数)和查询延迟方面带来显著提升。
二值向量
pgvecto.rs 支持二值向量(Binary Vectors)。bvector 类型专为存储效率与计算性能而优化,采用按位紧凑打包(bit-packed)的方式存储二值向量,并针对二值向量的距离计算进行了专门优化。
以下是 bvector 类型的性能基准测试,使用 dbpedia-entities-openai3-text-embedding-3-large-3072-1M 数据集,测试环境为 Google Cloud 上的 n2-standard-8(8 vCPU,32 GB 内存)虚拟机。
我们将 100 万条二值向量写入表中并建立索引,随后对每条查询向量运行 KNN 搜索。为 100 万条二值向量建立索引仅需约 600 MB 内存,而使用普通 vector 类型为相同数量的向量建立索引则需要约 18 GB 内存。
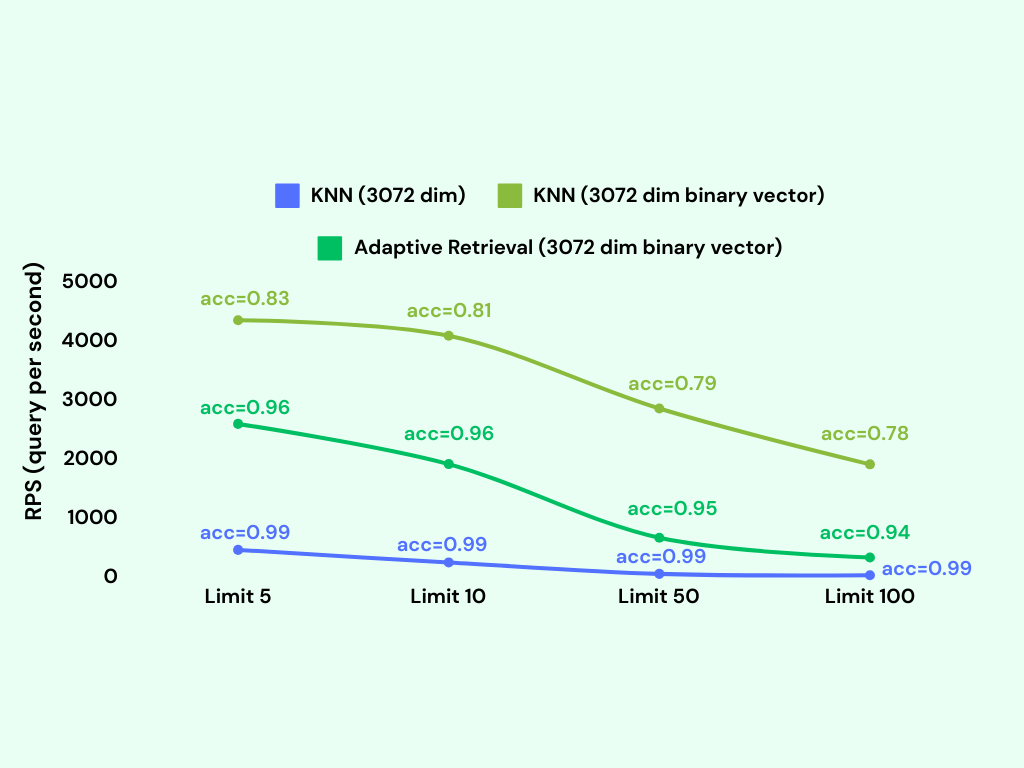
可以看到,单纯使用 bvector 的召回精度略低于 vector 类型,但如果结合采用自适应检索(Adaptive Retrieval),其准确率同样能够超过 95%。
7 - 参考手册
7.1 - 数据库 Schema
以下是 pgvecto.rs 提供的数据库对象定义(Schema)。
数据类型列表
| 名称 | 说明 |
|---|---|
| vector | 稠密向量,标量元素类型为 IEEE 754-2008 定义的 binary32(32 位浮点数) |
| vecf16 | 半精度向量,标量元素类型为 IEEE 754-2008 定义的 binary16(16 位浮点数) |
| veci8 | 整数向量,标量元素类型为 8-bit Integer(8 位有符号整数) |
| svector | 稀疏向量,标量元素类型为 IEEE 754-2008 定义的 binary32(32 位浮点数) |
| bvector | 二值向量,定长位串(bit string) |
| vector_index_stat | 表示向量索引统计信息的复合类型 |
操作符列表
| 名称 | 左操作数类型 | 右操作数类型 | 返回类型 | 说明 |
|---|---|---|---|---|
| + | vector | vector | vector | 逐元素加法运算 |
| + | vecf16 | vecf16 | vecf16 | 逐元素加法运算 |
| + | veci8 | veci8 | veci8 | 逐元素加法运算 |
| + | svector | svector | svector | 逐元素加法运算 |
| - | vector | vector | vector | 逐元素减法运算 |
| - | vecf16 | vecf16 | vecf16 | 逐元素减法运算 |
| - | veci8 | veci8 | veci8 | 逐元素减法运算 |
| - | svector | svector | svector | 逐元素减法运算 |
| & | bvector | bvector | bvector | 逐元素按位与(AND) |
| | | bvector | bvector | bvector | 逐元素按位或(OR) |
| ^ | bvector | bvector | bvector | 逐元素按位异或(XOR) |
| = | vector | vector | boolean | 字典序比较 |
| = | vecf16 | vecf16 | boolean | 字典序比较 |
| = | veci8 | veci8 | boolean | 字典序比较 |
| = | svector | svector | boolean | 字典序比较 |
| = | bvector | bvector | boolean | 字典序比较 |
| <> | vector | vector | boolean | 字典序比较 |
| <> | vecf16 | vecf16 | boolean | 字典序比较 |
| <> | veci8 | veci8 | boolean | 字典序比较 |
| <> | svector | svector | boolean | 字典序比较 |
| <> | bvector | bvector | boolean | 字典序比较 |
| < | vector | vector | boolean | 字典序比较 |
| < | vecf16 | vecf16 | boolean | 字典序比较 |
| < | veci8 | veci8 | boolean | 字典序比较 |
| < | svector | svector | boolean | 字典序比较 |
| < | bvector | bvector | boolean | 字典序比较 |
| > | vector | vector | boolean | 字典序比较 |
| > | vecf16 | vecf16 | boolean | 字典序比较 |
| > | veci8 | veci8 | boolean | 字典序比较 |
| > | svector | svector | boolean | 字典序比较 |
| > | bvector | bvector | boolean | 字典序比较 |
| <= | vector | vector | boolean | 字典序比较 |
| <= | vecf16 | vecf16 | boolean | 字典序比较 |
| <= | veci8 | veci8 | boolean | 字典序比较 |
| <= | svector | svector | boolean | 字典序比较 |
| <= | bvector | bvector | boolean | 字典序比较 |
| >= | vector | vector | boolean | 字典序比较 |
| >= | vecf16 | vecf16 | boolean | 字典序比较 |
| >= | veci8 | veci8 | boolean | 字典序比较 |
| >= | svector | svector | boolean | 字典序比较 |
| >= | bvector | bvector | boolean | 字典序比较 |
| <-> | vector | vector | real | 平方欧氏距离 |
| <-> | vecf16 | vecf16 | real | 平方欧氏距离 |
| <-> | veci8 | veci8 | real | 平方欧氏距离 |
| <-> | svector | svector | real | 平方欧氏距离 |
| <-> | bvector | bvector | real | 平方欧氏距离 |
| <#> | vector | vector | real | 负点积 |
| <#> | vecf16 | vecf16 | real | 负点积 |
| <#> | veci8 | veci8 | real | 负点积 |
| <#> | svector | svector | real | 负点积 |
| <#> | bvector | bvector | real | 负点积 |
| <=> | vector | vector | real | 余弦距离 |
| <=> | vecf16 | vecf16 | real | 余弦距离 |
| <=> | veci8 | veci8 | real | 余弦距离 |
| <=> | svector | svector | real | 余弦距离 |
| <=> | bvector | bvector | real | 余弦距离 |
| <~> | bvector | bvector | real | 杰卡德距离(Jaccard 距离) |
函数列表
| 名称 | 参数类型 | 返回类型 | 说明 |
|---|---|---|---|
| pgvectors_upgrade | void | 用于升级 pgvecto.rs 的管理函数。 |
|
| to_svector | dims integer, index integer[], value real[] | svector | 根据下标数组和值数组构造一个稀疏向量。 |
| binarize | vector vector | bvector | 将向量二值化:所有正数元素设为 1,其余元素设为 0。 |
| text2vec_openai | input text, model text | vector | 调用 OpenAI Embeddings API 的嵌入生成函数。 |
| text2vec_openai_v3 | input text | vector | 调用 OpenAI Embeddings API 的嵌入生成函数,默认模型设为 text-embedding-3-small。 |
类型转换列表
| 源类型 | 目标类型 | 是否隐式转换? |
|---|---|---|
| real[] | vector | yes |
| vector | real[] | yes |
| vector | vecf16 | no |
| vecf16 | vector | no |
| vector | veci8 | no |
| veci8 | vector | no |
| vector | svector | no |
| svector | vector | no |
| vector | bvector | no |
| bvector | vector | no |
访问方法(Access Methods)列表
| 名称 | 类型 | 说明 |
|---|---|---|
| vectors | Index | pgvecto.rs 向量索引方法 |
操作符族(Operator Families)列表
| 访问方法 | 操作符族 | 适用类型 |
|---|---|---|
| vectors | vector_cos_ops | vector |
| vectors | vector_dot_ops | vector |
| vectors | vector_l2_ops | vector |
| vectors | vecf16_cos_ops | vecf16 |
| vectors | vecf16_dot_ops | vecf16 |
| vectors | vecf16_l2_ops | vecf16 |
| vectors | veci8_cos_ops | veci8 |
| vectors | veci8_dot_ops | veci8 |
| vectors | veci8_l2_ops | veci8 |
| vectors | svector_cos_ops | svector |
| vectors | svector_dot_ops | svector |
| vectors | svector_l2_ops | svector |
| vectors | bvector_cos_ops | bvector |
| vectors | bvector_dot_ops | bvector |
| vectors | bvector_l2_ops | bvector |
| vectors | bvector_jaccard_ops | bvector |
操作符类(Operator Classes)列表
| 访问方法 | 输入类型 | 操作符类 | 是否默认? | 说明 |
|---|---|---|---|---|
| vectors | vector | vector_l2_ops | no | 平方欧氏距离 |
| vectors | vector | vector_dot_ops | no | 负点积 |
| vectors | vector | vector_cos_ops | no | 余弦距离 |
| vectors | vecf16 | vecf16_l2_ops | no | 平方欧氏距离 |
| vectors | vecf16 | vecf16_dot_ops | no | 负点积 |
| vectors | vecf16 | vecf16_cos_ops | no | 余弦距离 |
| vectors | veci8 | veci8_l2_ops | no | 平方欧氏距离 |
| vectors | veci8 | veci8_dot_ops | no | 负点积 |
| vectors | veci8 | veci8_cos_ops | no | 余弦距离 |
| vectors | svector | svector_l2_ops | no | 平方欧氏距离 |
| vectors | svector | svector_dot_ops | no | 负点积 |
| vectors | svector | svector_cos_ops | no | 余弦距离 |
| vectors | bvector | bvector_l2_ops | no | 平方欧氏距离 |
| vectors | bvector | bvector_dot_ops | no | 负点积 |
| vectors | bvector | bvector_cos_ops | no | 余弦距离 |
| vectors | bvector | bvector_jaccard_ops | no | 杰卡德距离(Jaccard 距离) |
视图列表
| 名称 | 说明 |
|---|---|
| pg_vector_index_stat | 提供向量索引统计信息的监控视图 |
7.2 - 索引选项
我们使用 TOML 语法来表达索引的配置参数。以下是配置中各个顶层键(表)的含义:
| 键名 | 类型 | 说明 |
|---|---|---|
| segment | table | 分段(Segment)相关选项。 |
| optimizing | table | 后台优化相关选项。 |
| indexing | table | 用于构建索引的算法配置。 |
segment 表选项
| 键名 | 类型 | 取值范围 | 默认值 | 说明 |
|---|---|---|---|---|
| max_growing_segment_size | integer | [1, 4_000_000_000] |
20_000 |
未建立索引的增长中分段的最大向量数量。 |
| max_sealed_segment_size | integer | [1, 4_000_000_000] |
1_000_000 |
已封存(建立索引)分段的最大向量数量。 |
optimizing 表选项
| 键名 | 类型 | 取值范围 | 默认值 | 说明 |
|---|---|---|---|---|
| optimizing_threads | integer | [1, 65535] |
CPU 核心数的平方根 | 后台构建索引的最大线程数。 |
| sealing_secs | integer | [1, 60] |
60 |
见下方说明。 |
| sealing_size | integer | [1, 4_000_000_000] |
1 |
见下方说明。 |
如果一个写入分段(write segment)中的向量数大于 sealing_size,且在连续 sealing_secs 秒内没有接收到新数据,该写入分段将被转为已封存分段(sealed segment)以构建索引。
indexing 表选项
| 键名 | 类型 | 说明 |
|---|---|---|
| flat | table | 若设置此表,索引将使用暴力搜索(flat)算法。 |
| ivf | table | 若设置此表,索引将使用 IVF 算法。 |
| hnsw | table | 若设置此表,索引将使用 HNSW 算法。 |
在上述三种索引算法中只能选择其一,默认值为 hnsw。
flat 表选项
| 键名 | 类型 | 说明 |
|---|---|---|
| quantization | table | 要使用的量化算法配置。 |
ivf 表选项
| 键名 | 类型 | 取值范围 | 默认值 | 说明 |
|---|---|---|---|---|
| nlist | integer | [1, 1_000_000] |
1000 |
聚类单元(聚类中心)的数量。 |
| nsample | integer | [1, 1_000_000] |
65536 |
用于 K-Means 聚类训练的样本数量。 |
| least_iterations | integer | [1, 1_000_000] |
16 |
K-Means 聚类的最少迭代次数。 |
| iterations | integer | [1, 1_000_000] |
500 |
K-Means 聚类的最大迭代次数。 |
| quantization | table | 要使用的量化算法配置。 |
hnsw 表选项
| 键名 | 类型 | 取值范围 | 默认值 | 说明 |
|---|---|---|---|---|
| m | integer | [4, 128] |
12 |
节点的最大连接度数。 |
| ef_construction | integer | [10, 2000] |
300 |
构建索引时的搜索范围。 |
| quantization | table | 要使用的量化算法配置。 |
quantization 表选项
| 键名 | 类型 | 说明 |
|---|---|---|
| trivial | table | 若设置此表,则不使用任何量化。 |
| scalar | table | 若设置此表,则使用标量量化(Scalar Quantization)。 |
| product | table | 若设置此表,则使用乘积量化(Product Quantization)。 |
在上述量化算法中只能选择其一,默认值为 trivial。
product 表选项
| 键名 | 类型 | 取值范围 | 默认值 | 说明 |
|---|---|---|---|---|
| sample | integer | [1, 1_000_000] |
65535 |
用于量化训练的样本数量。 |
| ratio | enum | "x4", "x8", "x16", "x32", "x64" |
"x4" |
量化的压缩比。 |
压缩比(ratio)表示存储向量时节省的内存比例。例如,对于标准 32 位浮点向量 vector,"x4" 表示内存占用降至原来的 ;如果您是在半精度向量 vecf16 上创建索引,则 "x4" 表示内存占用降至原来的 。
7.3 - 搜索选项
搜索选项通过 PostgreSQL GUC 参数进行指定。
ivf 选项
以下选项仅对 IVF 算法生效。详情请参阅索引指南。
| 选项 | 类型 | 取值范围 | 默认值 | 说明 |
|---|---|---|---|---|
| vectors.ivf_nprobe | integer | [1, 1_000_000] |
10 |
扫描的列表数量。 |
hnsw 选项
以下选项仅对 HNSW 算法生效。详情请参阅索引指南。
| 选项 | 类型 | 取值范围 | 默认值 | 说明 |
|---|---|---|---|---|
| vectors.hnsw_ef_search | integer | [1, 65535] |
100 |
HNSW 的搜索范围。 |
其他选项
与搜索模式及规划器相关的查询选项:
| 选项 | 类型 | 取值范围 | 默认值 | 说明 |
|---|---|---|---|---|
| vectors.search_mode | enum | "basic", "vbase" |
"vbase" |
搜索模式,详情请参阅搜索指南。 |
| vectors.pgvector_compatibility | boolean | off |
启用或禁用 pgvector 兼容模式,详情请参阅 pgvector 兼容性。 |
|
| vectors.enable_index | boolean | on |
启用或禁用查询规划器对向量索引的使用。 |
7.4 - 向量类型
在前面的索引和搜索章节中,我们已经接触了标准的 vector 类型。本节将探讨更多向量数据类型及其在向量搜索领域的应用:
- 半精度向量(Half-Precision Vector)
- 8 位整数向量(8-Bit Integer Vector) since v0.3.0
- 稀疏向量(Sparse Vector) since v0.3.0
- 二值向量(Binary Vector) since v0.3.0
低精度索引
since v0.3.0为了提升在 vector 列上的查询速度并降低内存占用,可以考虑使用表达式索引,基于 vecf16、veci8 或 bvector 类型创建低精度索引,而非直接对 vector 类型创建全精度索引:
缩短嵌入向量(Shortening Embedding)
since v0.3.0部分嵌入模型(例如 OpenAI 的 text-embedding-3-small 和 text-embedding-3-large)支持缩短嵌入向量,即直接移除向量序列末尾的部分数值,而不会丢失嵌入向量的核心概念表达能力。
在某些场景下,可能需要在嵌入生成并入库之后再动态调整检索维度。pgvecto.rs 提供了通过数组切片语法直接使用缩短后的嵌入向量进行查询和建索引的方法:
自 v0.3.0 版本起,pgvecto.rs 中的所有向量数据类型均支持缩短嵌入向量切片操作。
类型转换
下图展示了不同向量数据类型之间的转换关系,由箭头连接的两个类型可以相互转换(Cast):
其中,ARRAY 是 PostgreSQL 的原生数组类型,其余均为 pgvecto.rs 定义的向量类型。
以下是向量类型转换的几个示例:
7.4.1 - 半精度向量:`vecf16`
vecf16 以半精度数值格式存储,充分利用了 16 位浮点数(FP16)的优势,与标准 32 位浮点数的 vector 相比,仅使用一半的内存和内存带宽。
以下是创建包含 vecf16 列的表并插入数据的示例:
同样可以在 vecf16 类型上创建索引:
我们支持三种用于计算两个 vecf16 值之间距离的操作符:
<->(vecf16_l2_ops):平方欧氏距离,定义为 。<#>(vecf16_dot_ops):负点积,定义为 。<=>(vecf16_cos_ops):余弦距离,定义为 。
7.4.2 - 8 位整数向量:`veci8`
Int8 是一种用于表示有符号整数的数据类型,代表“8 位整数(integer 8-bit)”,使用 8 比特(1 字节)内存存储一个值,可表示范围为 -128 到 127 的整数。
由于向量中的每个元素仅需 8 比特(1 字节)内存,使用 veci8 可以大幅减少程序的整体内存占用。
以下是创建包含 veci8 列的表并插入数据的示例:
同样可以在 veci8 类型上创建索引:
我们支持三种用于计算两个 veci8 值之间距离的操作符:
<->(veci8_l2_ops):平方欧氏距离,定义为 。<#>(veci8_dot_ops):负点积,定义为 。<=>(veci8_cos_ops):余弦距离,定义为 。
7.4.3 - 稀疏向量:`svector`
与稠密向量不同,稀疏向量(Sparse Vector)通常具有非常高的维度,但其中只包含极少数的非零值。
通常情况下,稀疏向量可以由以下方式生成:
- 词共现矩阵(Word co-occurrence matrices)
- 词频-逆文档频率(TF-IDF)向量或 SPLADE/BGE-M3 词法权重
- 用户-物品交互矩阵(User-item interaction matrices)
- 网络邻接矩阵(Network adjacency matrices)
在 pgvecto.rs 中,稀疏向量类型称为 svector。
以下是创建包含 svector 列的表并插入数据的示例:
同样可以在 svector 类型上创建索引:
我们支持三种用于计算两个 svector 值之间距离的操作符:
<->(svector_l2_ops):平方欧氏距离,定义为 。<#>(svector_dot_ops):负点积,定义为 。<=>(svector_cos_ops):余弦距离,定义为 。
此外,还提供了 to_svector 函数用于构造 svector,它会在指定的下标位置设置对应的非零值:
7.4.4 - 二值向量:`bvector`
bvector 类型是 pgvecto.rs 中的二值向量(Binary Vector)类型。在二值向量中,每个分量只能取两个可能的值(通常为 0 和 1)。
以下是创建包含 bvector 列的表并插入数据的示例:
同样可以在 bvector 类型上创建索引:
我们支持四种用于计算两个 bvector 值之间距离的操作符:
<->(bvector_l2_ops):平方欧氏距离,定义为 。对于二值向量,汉明距离(Hamming distance)与平方欧氏距离完全等价。<#>(bvector_dot_ops):负点积,定义为 。<=>(bvector_cos_ops):余弦距离,定义为 。<~>(bvector_jaccard_ops):杰卡德距离(Jaccard distance),定义为 。
此外,还提供了 binarize 函数用于从 vector 构造 bvector,它会将向量元素二值化为 0 或 1:
性能表现
bvector 类型针对存储和计算性能进行了深度优化。它采用按位紧缩(bit-packed)的表示方式存储二值向量,并且距离计算也专门针对位运算进行了加速优化。
以下是 bvector 类型的性能基准测试结果。测试使用 dbpedia-entities-openai3-text-embedding-3-large-3072-1M 数据集,运行在 Google Cloud 的 n2-standard-8(8 vCPU,32 GB 内存)虚拟机上。
我们向表中插入了 100 万条二值向量并运行 KNN 查询。为 100 万条 3072 维二值向量建立索引仅需约 600MB 内存,而使用标准 vector 类型对相同数量的向量建立索引则需要约 18GB 内存。
可以看到,单纯使用 bvector 的准确率虽不及 vector 类型,但如果结合采用自适应检索(Adaptive Retrieval),其准确率即可超过 95%。
8 - 社区
8.1 - 参与贡献 `pgvecto.rs`
我们欢迎来自开源社区、个人开发者及合作伙伴的各种形式的贡献。如果你有兴趣参与贡献,希望本文档能帮助你清晰了解贡献流程。
无论是资深贡献者还是刚接触开源的新手,以下指南都会非常有帮助:
行为准则
行为准则(Code of Conduct)是一份确立项目参与者行为预期的文档。采用并执行行为准则有助于为社区营造积极健康的交流氛围。
如果你还不了解什么是行为准则,请参阅你的行为准则 | Open Source Guides。
参与方式
我们的社区始终欢迎热心开发者以各种方式参与其中。
⚽ 开始使用 pgvecto.rs
阅读并跟随快速开始指南操作。一切是否都符合预期?如果遇到问题,我们随时欢迎改进建议。你可以在 💬 Discord 上与我们交流,或在 GitHub 上提交 Issue。
🙋 协助整理 Issue 和 Pull Request
即使不编写任何代码,协助整理和分类新提交的 Issue 与 Pull Request 也是为项目做出重要贡献的绝佳方式:
- 如果你认为某个 Issue 未提供解决问题所需的完整细节,可以礼貌地请求补充更多信息。
- 建议合适的标签(Label),以帮助对 Issue 进行分类。
- 标记已经过时(stale)或应当关闭的 Issue。
- 询问测试计划并协助审查代码(Code Review)。
👨💻 为 pgvecto.rs 贡献代码
如果你发现了想要修复的 Issue,欢迎提交 Pull Request。请先阅读开发教程以快速上手。
👉 完善文档
大家都喜欢清晰易读的文档。如果你发现任何令人困惑或可以改进的地方,可以点击大多数文档页面底部的“编辑此页”,直接跳转到 GitHub 界面进行修改并提交更改建议。
💬 在 Discord 上交流 pgvecto.rs
欢迎加入我们的 💬 Discord 与社区一起交流讨论。
8.2 - 路线图
我们强烈建议你了解并选用我们全新的 VectorChord 实现,它提供了更高的稳定性和性能。建议现有用户迁移至 VectorChord,具体步骤请参阅迁移指南。
中期规划
稀疏向量支持
稀疏向量在 RAG 和文本检索等任务中表现出了优异的性能,并且能够与稠密向量互补以提升检索效果。因此,我们计划支持稀疏向量索引。
更好地支持流式工作负载
作为数据库,支持向量数据的灵活插入和删除至关重要。然而,当前主流的 HNSW 算法对删除操作的支持并不理想,通常需要重建索引。因此,我们计划参考 DiskANN 论文并支持 Vamana 算法。Vamana 算法是一种基于图的增量索引算法,无需重建索引即可良好地支持向量的动态删除与插入。
单机支持更大规模向量
在相同硬件资源下支持更多向量,对于帮助用户降低成本具有重要意义。目前我们已经支持用户以 fp16 格式存储向量,在几乎不损失精度的前提下仅需一半的内存和存储空间。我们还计划支持更多向量格式(如 fp8 和 int8),以进一步降低存储和内存消耗。同时,我们也在积极探索基于 SSD 的向量索引算法(如 DiskANN)。
物理复制与流复制支持
pgvecto.rs 目前是一个独立于 PostgreSQL 的外部存储系统,自行管理索引内存和磁盘存储,因此无法开箱即用地支持物理复制。我们计划实现自定义的 WAL 资源管理器(Resource Manager),以满足物理复制的要求,使用户在 PG 中使用复制更加便捷。
长期规划
在 PostgreSQL 内支持十亿级(1B)向量
我们的终极目标是在 PostgreSQL 中支持 10 亿(1 Billion)规模的向量检索。要实现这一目标仍需克服诸多挑战,可能需要借助表访问方法(Table Access Method)实现自定义的向量存储方案,或者结合 Citus 等分布式分片扩展。目前我们在该领域的探索尚处于早期阶段,非常欢迎感兴趣的开发者与我们探讨交流。
与我们交流
想要参与进来?欢迎随时参与讨论和代码贡献!
- 在 💬 Discord 上与我们交流
- 查看带有
good first issue 💖标签的新手友好型 Issue! - 更多详情请参阅贡献指南
以上规划项并非 MVP 的必需功能,而是我们长期路线图的一部分。如果你对其中任何方向感兴趣,欢迎随时加入!
更多规划将在未来持续补充。
8.3 - 采用者案例
- immich 是一款支持直接从手机备份照片和视频的自托管解决方案,它使用 pgvecto.rs 实现智能搜索。
- postgresql_embedded 是一套在 Rust 中安装、运行和管理 PostgreSQL 及其扩展的工具集,支持安装 pgvecto.rs。
添加你的应用
如果你在自己的应用中使用了 pgvecto.rs,欢迎编辑此页面。我们非常高兴能收到你的反馈,并协助你不断提升 pgvecto.rs 的使用体验。
9 - 开发者指南
9.1 - 开发教程
搭建开发环境
你可以使用 envd 轻松搭建开发环境,它会自动创建一个 Docker 容器并为你安装所有依赖项:
或者,你也可以按照以下步骤手动搭建开发环境:
- 安装基础依赖项:
- 安装
clang-16(不支持其他版本的clang):
- 安装 Rust(请勿使用系统包管理器安装
rustc):
- 克隆代码仓库:
- 安装
cargo-pgrx:
cargo-pgrx 是开发 PostgreSQL 扩展的得力工具,你可以通过 https://docs.rs/crate/cargo-pgrx/latest 阅读其文档。
交叉编译
假设你需要在 x86_64 宿主机环境下为 aarch64 目标架构编译二进制文件和 Schema,可以按照以下步骤操作:
- 安装交叉编译工具链:
设置环境变量:
在 ~/.cargo/config.toml 文件末尾添加以下配置,为 Rust 配置模拟器、链接器和 sysroot:
- 生成目标架构上的 PostgreSQL 头文件。该步骤可通过
cargo-pgrx完成,同时你也可以直接利用仓库中vendor/pgrx_config和vendor/pgrx_binding目录下的文件。详情请参阅pgrx的官方文档。
调试
即使在 Release 模式下,编译生成的二进制文件中也包含了调试信息(Debug Info),因此你随时可以使用 gdb 进行调试。
对于 Debug 构建,当后台工作进程(Background Worker)中的线程发生 panic 时会打印调用栈(backtrace),但会话进程(Session Process)报错时默认不打印。对于 Release 构建,默认不打印任何 backtrace。但如果你将环境变量 RUST_BACKTRACE 设置为 1,则会打印所有 backtrace。建议在调试 Release 构建时使用命令 RUST_BACKTRACE=1 cargo pgrx run --release。