Vchord 家族套件
检索增强生成(Retrieval-Augmented Generation,简称 RAG)正在彻底改变我们与海量数据集及大语言模型的交互方式。通过在生成回答前检索相关信息,RAG 系统能够提供更加精准、具备上下文感知且时效性更强的答案。然而,构建稳健、可扩展且高效的 RAG 流水线依然面临诸多挑战,在生产环境中尤为如此。
许多现有方案采用了复杂的架构,分别使用不同的专用数据库来处理向量检索、关键词检索和主数据存储。这往往会导致数据同步困难、基础设施复杂度上升以及运维成本居高不下。
如果能够直接在您信赖的 PostgreSQL 数据库中构建强大且达到生产级标准的 RAG 系统,会怎样呢?
为此,我们推出了 Vchord 家族套件(Vchord Suite)——这是一套专为将高性能向量检索、原生 BM25 排序以及灵活的分词能力直接引入 Postgres 而设计的 PostgreSQL 扩展套件。下面让我们一起探索其核心组件,以及它们如何赋能下一代 RAG 解决方案。
什么是 Vchord 家族套件?
该套件由三个协同工作的核心 PostgreSQL 扩展组成:
-
vchord(pgsty/vchord): 核心向量检索引擎,专为在 PostgreSQL 内部实现可扩展、高性能且高磁盘效率的向量相似性检索而设计。 -
vchord_bm25(pgsty/vchord_bm25): 该扩展利用高效的 Block-WeakAnd 算法,直接在 PostgreSQL 内部实现了成熟的 BM25 排序算法。BM25 是基于关键词词频与文档特征进行相关性排序的行业标准。 -
pg_tokenizer(pgsty/pg_tokenizer): 提供高效全文检索所需的核心文本分词能力,支持对全文检索中的文本处理流程进行细粒度控制。
通过组合这些扩展,您可以完全在 PostgreSQL 内部解锁构建高级 RAG 系统的强大能力。
如何使用 Vchord 家族套件
您可以使用 tensorchord/vchord-suite Docker 镜像来运行由 TensorChord 提供的多个扩展。该镜像基于 Docker 官方 PostgreSQL 镜像构建,并内置了以下扩展:
vchordpg_tokenizervchord_bm25vector
Vchord 家族套件的应用场景
场景 1:基于原生 BM25 与 vchord 的强大混合检索
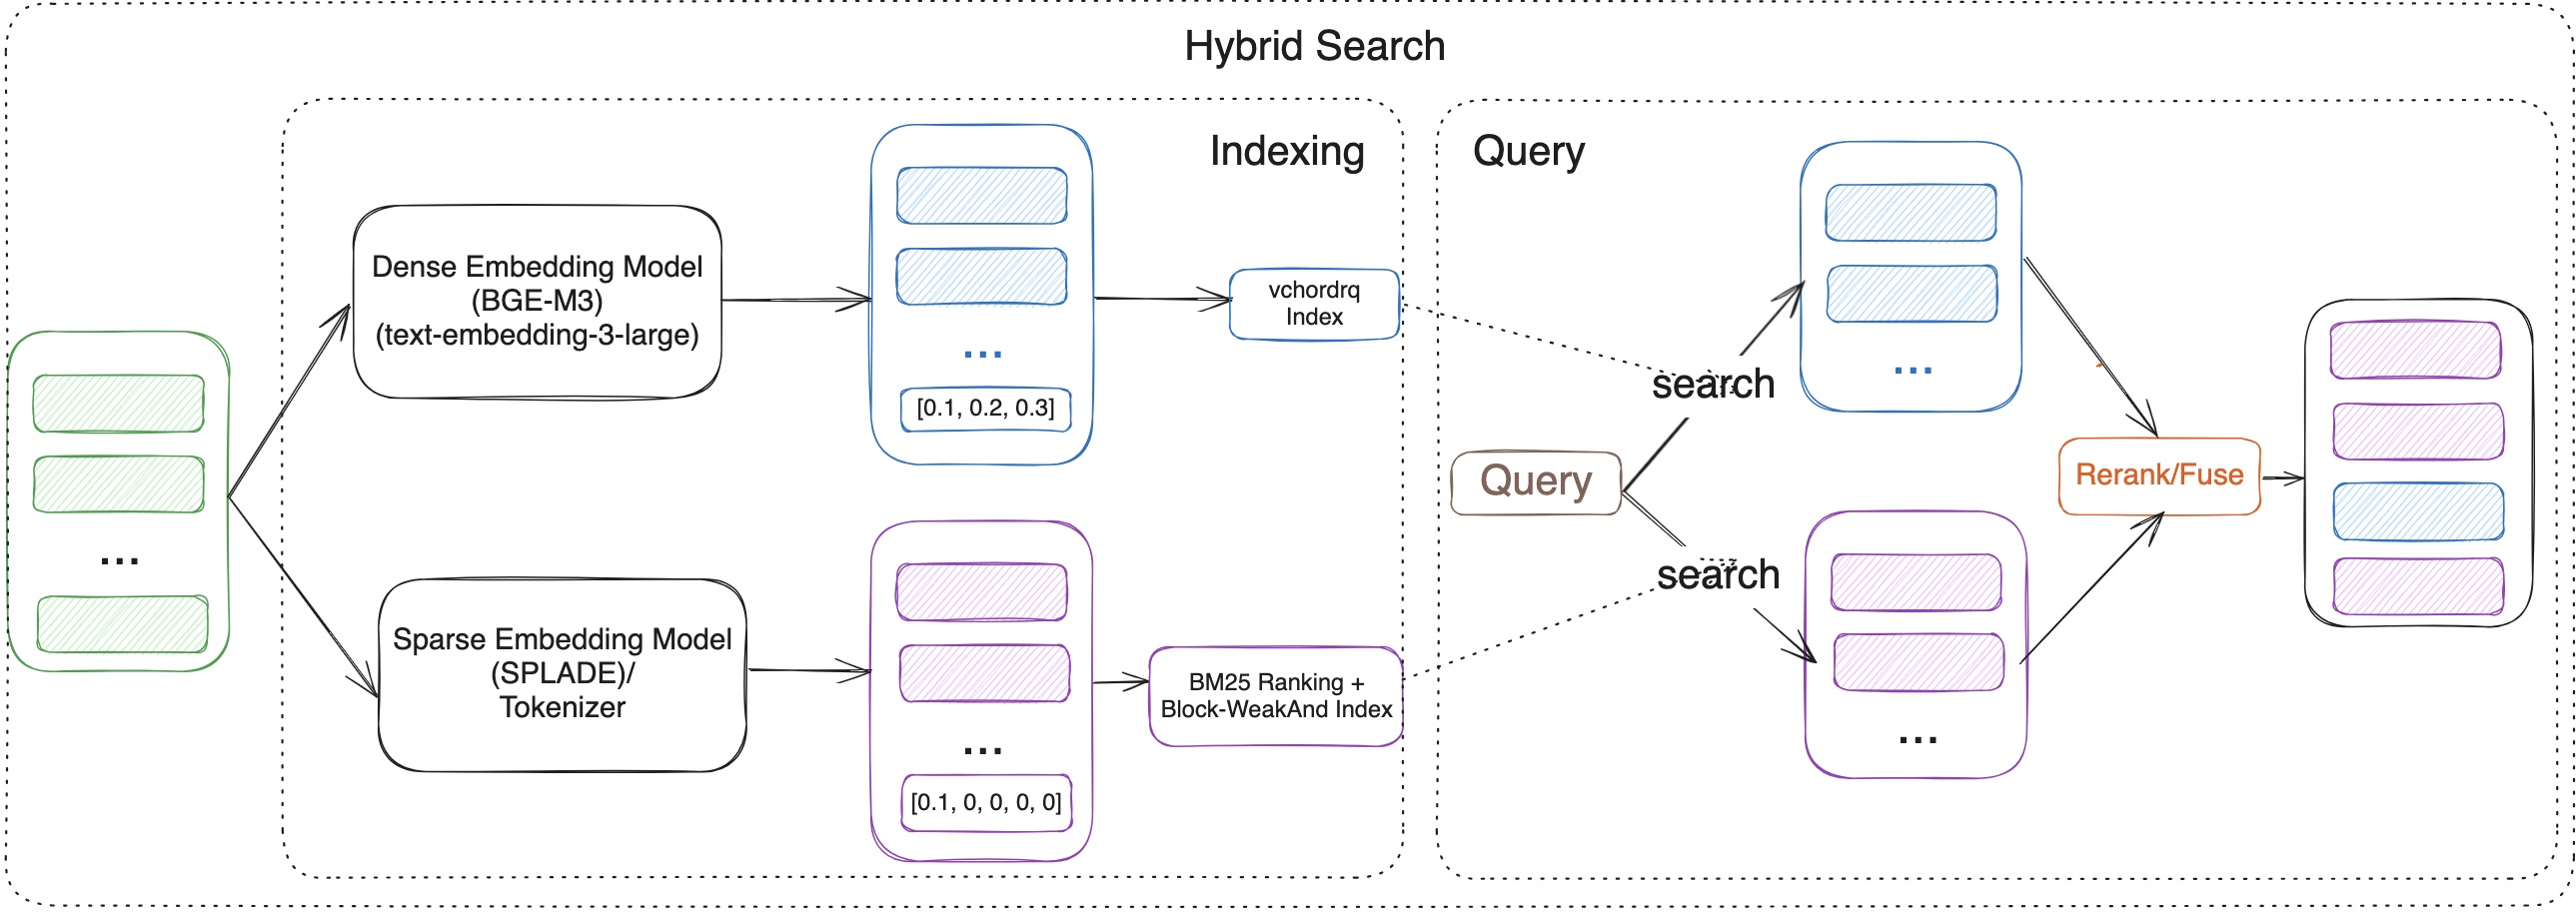
在 RAG 时代,高效的检索至关重要。无论是单纯的关键词检索还是单纯的向量检索,都并非完美无缺:
-
关键词检索(如 BM25): 擅长精确匹配,能够找出包含确切关键词的文档,非常适合结构化查询和特定术语检索。然而,它在处理同义词、改写表述以及理解潜在语义或意图方面表现欠佳。(基于
vchord_bm25与pg_tokenizer实现)。 -
向量检索: 能够捕捉深层语义信息及概念间的关联,即使查询中未出现完全一致的关键词,也能找到相关信息。但在面对要求精确匹配特定术语的查询时,其精度有时会略显不足。(基于
vchord实现)。
解决方案:混合检索(Hybrid Search)。 通过在 PostgreSQL 内部结合这两种方法的优势,Vchord 家族套件完美弥补了这一鸿沟。您可以在查询中同时利用:
-
vchord_bm25(由pg_tokenizer驱动)实现关键词精确匹配。 -
vchord实现深层语义理解。
随后,可以将两者的检索结果进行智能融合(例如使用倒数排序融合 RRF,或基于模型的重排序),从而生成比任何单一方法都更加准确、上下文相关且具备语义感知的最终排序。这将为您的 RAG 应用带来显著的检索性能提升。
场景 2:超越纯文本——基于 ColQwen2 与 vchord 的免 OCR RAG
为 PDF 或扫描图像等文档构建 RAG 系统通常涉及繁琐的预处理流水线。传统方法高度依赖光学字符识别(OCR)和版面分析来提取文本。这一过程往往存在以下弊端:
-
速度缓慢: OCR 的计算开销通常非常高昂。
-
容易出错: OCR 的准确率受文档质量影响极大。
-
信息有损: 表格、图表、排版格式以及相对位置等关键视觉上下文信息,往往会在文本提取过程中丢失。
解决方案:免 OCR、具备视觉感知的 RAG。 如果您无需显式执行 OCR,就能直接根据文档的视觉外观及其内容进行查询,会怎样呢?
现在,通过结合以下两项技术即可实现这一目标:
-
多模态视觉语言模型(VLM): 诸如 ColQwen2 等模型可以直接处理图像(文档页面),并生成同时捕捉文本内容与视觉版面信息的嵌入向量(Embeddings)。
-
vchord的多向量检索能力:vchord可以在 PostgreSQL 中高效地为每篇文档存储和检索多个向量——允许您存储代表文档不同维度的嵌入表示(例如文本内容与视觉布局)。
借助这一方案,您可以直接在 PostgreSQL 中使用提及视觉元素的提示词(如“查找包含对比销售数据的柱状图的文档”)或结合图文线索的查询来检索文档数据库。这不仅简化了您的 RAG 技术栈,还通过保留视觉上下文提升了检索准确率,并彻底消除了传统 OCR 流水线的性能瓶颈。
为什么在 PostgreSQL 中构建 RAG?
在 PostgreSQL 中使用 Vchord 家族套件具有显著优势:
-
数据统一: 将源数据、文本、元数据和向量嵌入统一保存在同一个数据库中。
-
降低复杂度: 无需维护独立的向量数据库及复杂的数据同步流水线。
-
复用现有基础设施: 充分利用您现有的 PostgreSQL 专业经验、工具链和运维体系。
-
事务完整性: 受益于 PostgreSQL 强大的 ACID 事务保障。
-
丰富的生态系统: 无缝接入 PostgreSQL 生态系统中种类繁多的工具与特性。
总结
Vchord 家族套件将 PostgreSQL 打造成了一个强大且达到生产级标准的平台,用于构建高级 RAG 解决方案。通过集成高性能向量检索(vchord)、成熟的关键词排序(vchord_bm25)以及灵活的文本处理(pg_tokenizer),您可以直接在数据库内部实现混合检索与免 OCR 多模态检索等前沿技术。在 PostgreSQL 中借助 Vchord 简化系统架构、提升检索精度,并充分释放 RAG 的全部潜能。
相关博文
在近期的博文中,我们分享了多个实际应用案例,其中所有的 Docker 镜像均可以直接替换为 VectorChord Suite 镜像: