基于 Postgres 原生 BM25 与 VectorChord 的混合检索
在检索增强生成(RAG)时代,从海量数据集中高效检索相关数据对于企业和开发者而言至关重要。传统的基于关键词的检索方法(例如使用 BM25 作为评分机制的方法)擅长根据词频和精确关键词匹配对文档进行排序,因此在处理结构化查询和关键词密集型内容时非常高效。然而,它们在理解同义词、上下文细微差别以及深层语义意图方面往往力不从心。相反,基于向量的检索能够捕捉深层语义信息,面对多样化的查询具备更好的泛化能力,但有时会在精确关键词匹配上牺牲精度。混合检索(Hybrid Search)通过将 BM25 的精确性与向量检索的上下文理解能力相结合,弥补了这一差距,从而提供更快、更准确且具备语义感知的检索结果。
本文将探讨如何在 Postgres 中使用 VectorChord-bm25 进行关键词检索,并使用 VectorChord 进行语义检索,从而实现混合检索。通过结合 VectorChord-bm25 基于 Block-WeakAnd 算法的 BM25 排序能力与 VectorChord 先进的向量相似性检索能力,您可以构建一个将关键词精度与语义理解无缝融合的稳健检索系统。无论您是在构建推荐引擎、文档检索系统还是企业级搜索解决方案,本指南都将带您逐步解锁混合检索的全部潜能。
所有相关的基准测试代码均可在此处获取。
混合检索原理解析
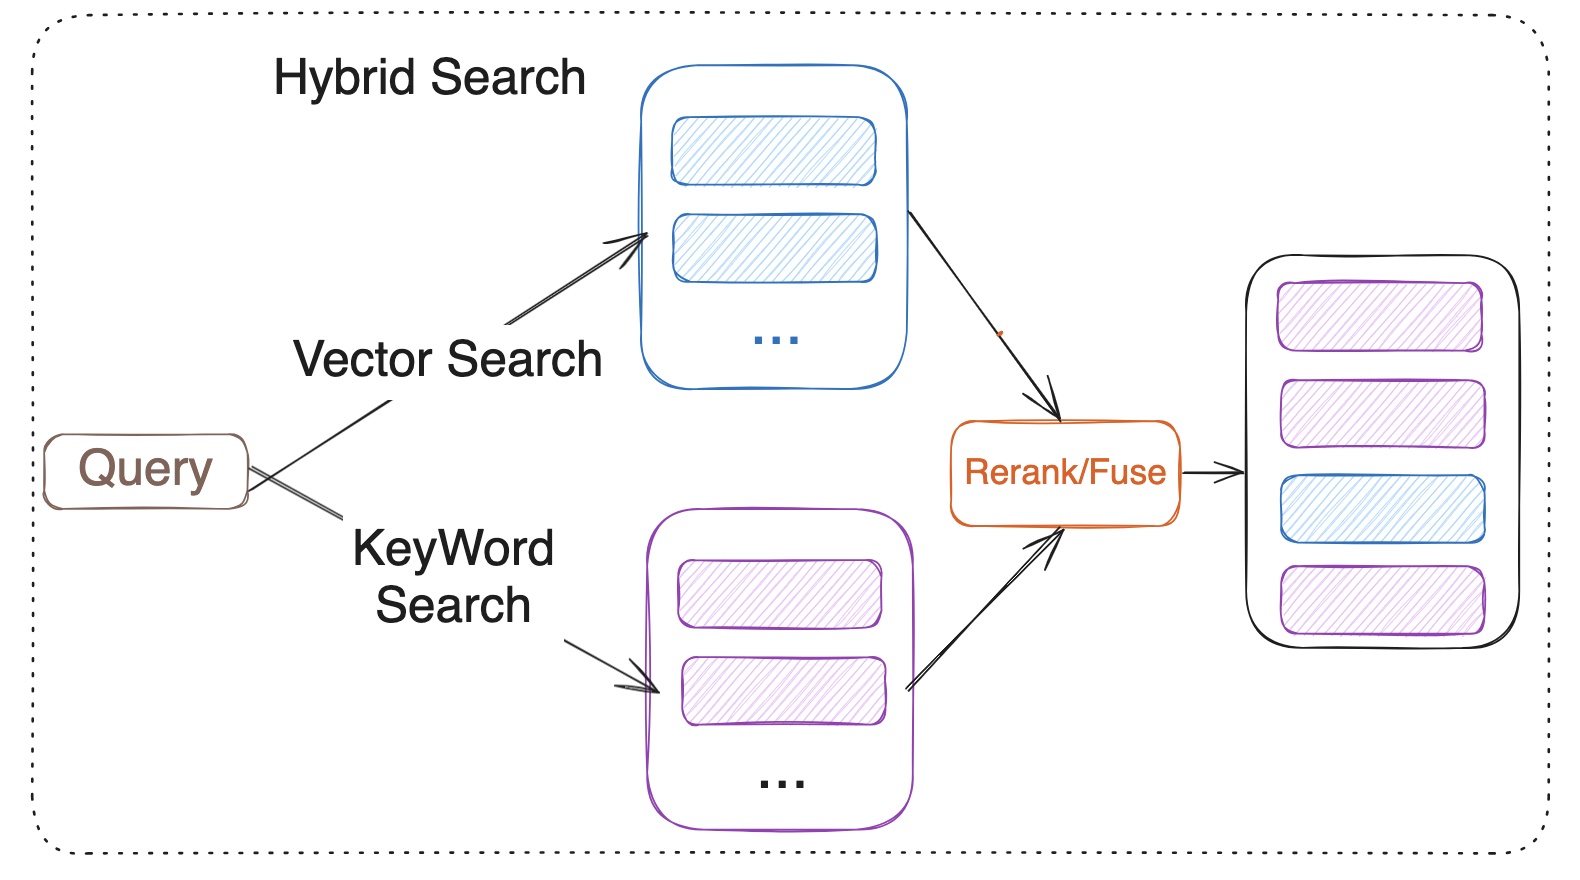
混合检索会将向量检索与关键词检索的结果进行合并。向量检索基于查询与文档之间的语义相似度,而关键词检索则依赖于 BM25 排序算法。不过需要注意的是,BM25 本身仅负责对文档进行打分,而完整的关键词检索流程还包括分词(Tokenization)、**索引构建(Indexing)和查询解析(Query Parsing)**等步骤。混合检索会利用重排序器(Reranker)或结果融合(Fusion)技术来整合两种方法的结果。融合方法包括针对多路召回策略的倒数排序融合(RRF,Reciprocal Rank Fusion)或加权评分;基于模型的重排序则包括诸如 bge-reranker-v2-m3 等交叉编码器(Cross-Encoder)模型,以及多向量表示模型 ColBERT。
什么是 VectorChord?
您可能已经熟悉 pgvector——一款面向 Postgres 的开源向量相似性检索扩展。然而,面对大规模或性能敏感型场景,往往需要更先进的向量检索解决方案,而 VectorChord 正是一个绝佳的选择。
欢迎阅读博文《VectorChord:在 PostgreSQL 中仅需 1 美元存储 400k 向量》,深入了解其设计动机与架构原理。
什么是 VectorChord-BM25
VectorChord-BM25 是一款用于关键词检索的 PostgreSQL 扩展。它不仅实现了 BM25 排序,还内置了分词器(Tokenizer)以及用于加速检索的 Block-WeakAnd 索引。
什么是 BM25?
BM25(Best Matching 25)是信息检索领域常用的一种概率排序函数,用于评估文档与查询之间的匹配程度。它基于词频(TF,Term Frequency)和逆文档频率(IDF,Inverse Document Frequency)计算相关性得分,同时引入了文档长度归一化机制。该公式确保在单篇文档中频繁出现的词(TF)以及在整个语料库中较为罕见的词(IDF)都能获得合理的权重,从而提升搜索的准确性与相关性。其中,IDF 衡量一个词在整个文档集合中出现的频率——出现次数越少,其权重越高;TF 则表示查询中的特定词在目标文档中出现的频率——TF 越高,说明查询与该文档之间的相关性越强。
为什么需要 Postgres 原生的 BM25 排序实现?
在我们此前的博文《VectorChord-BM25:以比 Elasticsearch 快 3 倍的 BM25 排序彻底革新 PostgreSQL 搜索》中,我的同事 Allen 已经给出了详尽且充分的解释,欢迎参考阅读。
教程:使用 VectorChord-BM25 与 VectorChord 实现混合检索
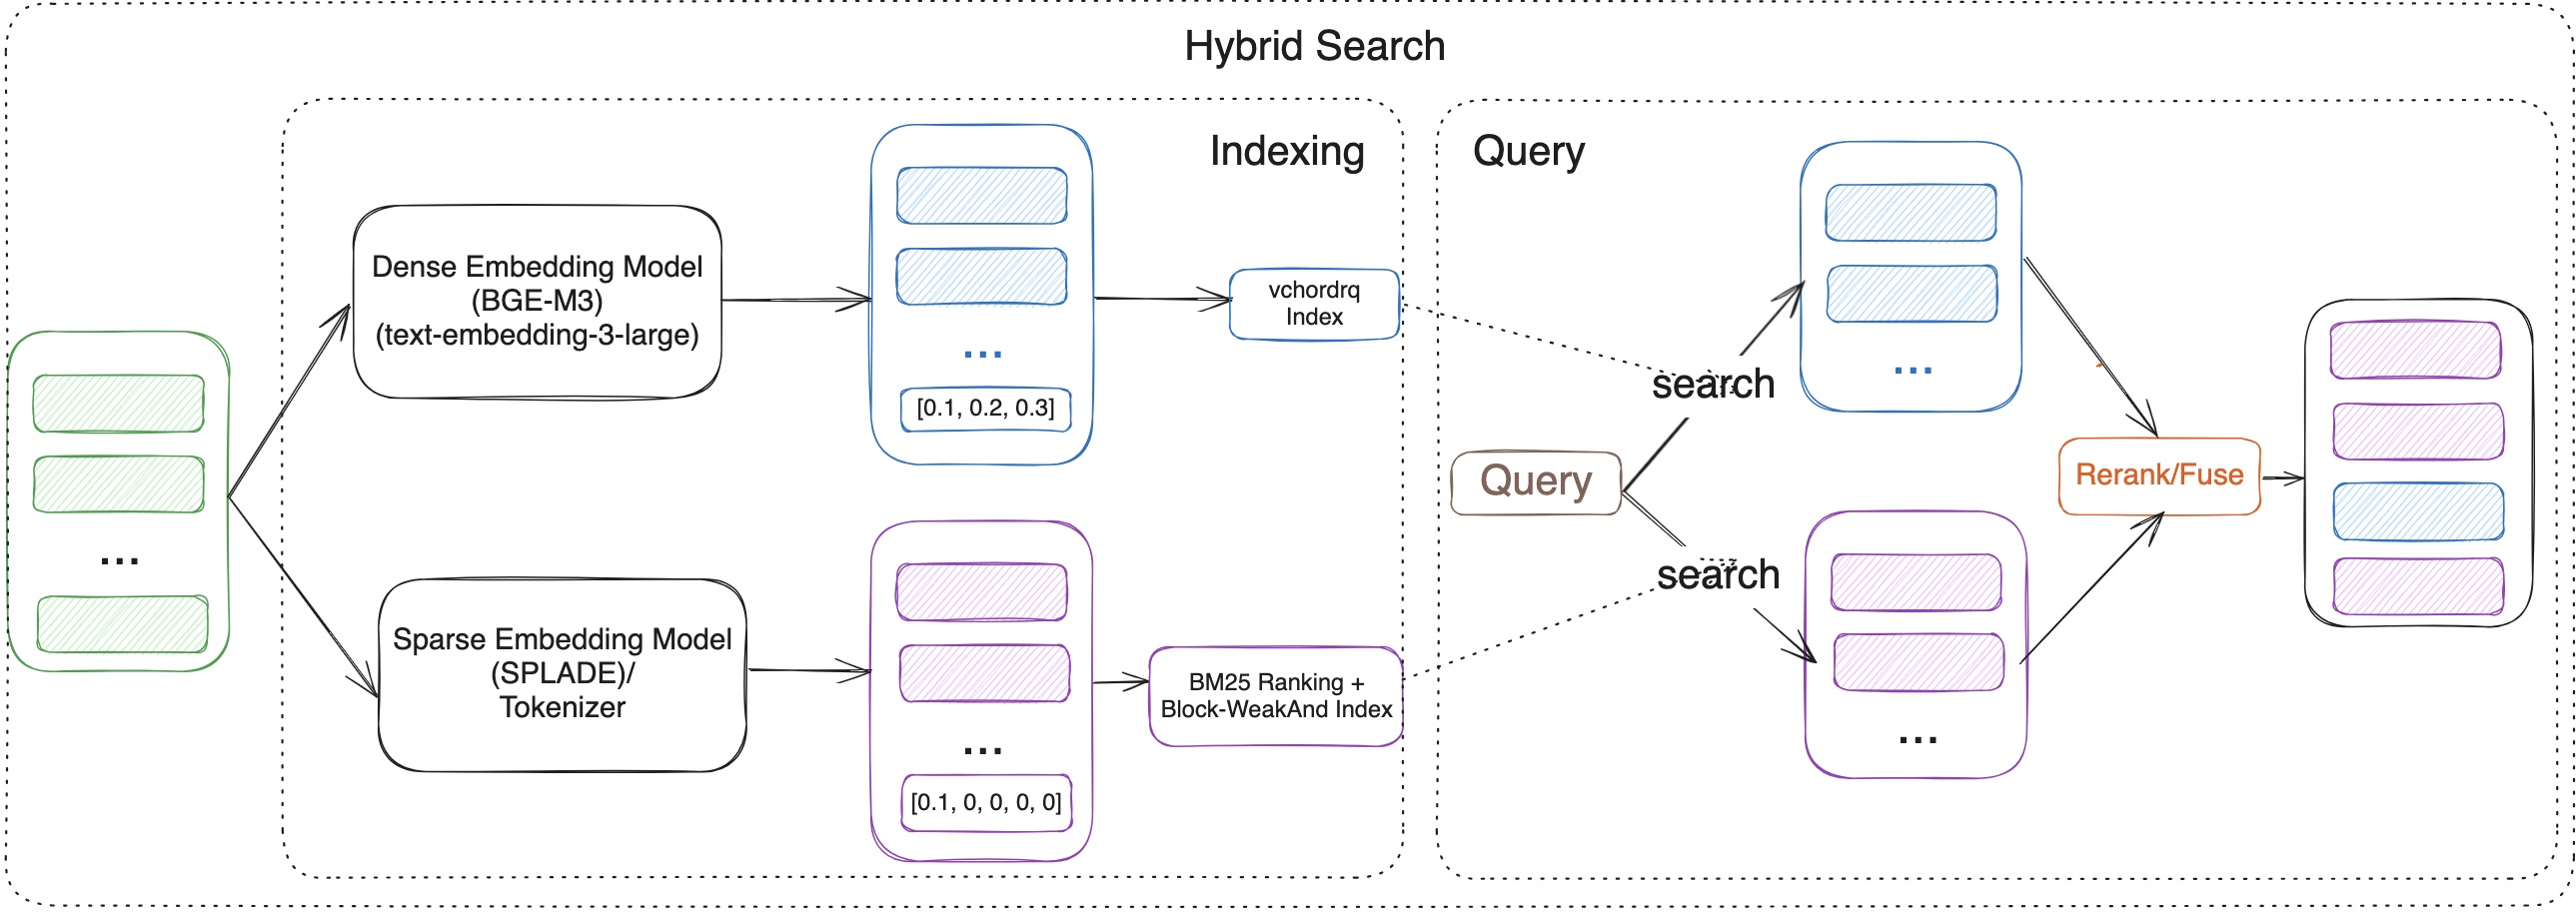
在本教程中,我们将指导您逐步在 PostgreSQL 中使用 VectorChord-BM25 和 VectorChord 实现混合检索。我们将涵盖以下内容:
-
使用 VectorChord 进行语义检索
-
使用 VectorChord-BM25 进行关键词检索
-
重排序(Rerank)
前置条件
- 安装包含 VectorChord-BM25 与 VectorChord 的 Postgres
如果您希望快速复现本教程,可以使用 tensorchord/vchord-suite 镜像来运行由 TensorChord 提供的多个扩展。
您可以运行以下命令来启动包含 VectorChord-BM25 与 VectorChord 的 Postgres 容器:
- 准备嵌入模型与数据
在嵌入生成方面,我们可以使用如 BGE-M3 这样的预训练嵌入模型为文档生成向量。BGE-M3 是一款高质量的嵌入模型,以其多功能性、多语言支持和多粒度表征能力而闻名。
在验证评估方面,我们使用 BEIR 数据集——这是一个异构的信息检索基准测试集。它非常易于使用,支持在 15 个以上的多样化信息检索数据集上评估模型表现。
首先,您需要将数据加载到 PostgreSQL 中,然后可以使用以下代码为文档生成嵌入向量并写入数据库:
生成嵌入向量的代码如下:
数据处理与嵌入生成的完整代码可在此处查看。
使用 VectorChord 进行语义检索
在语义检索部分,我们使用了在 VectorChord PostgreSQL 扩展中经过深度优化的 RaBitQ 算法。RaBitQ 是一种面向高维空间的量化算法,旨在提升嵌入向量等高维数据的存储与检索效率。
它通过将高维向量映射到低维离散空间,同时保留原始向量的相似性信息来实现这一目标。这一过程在大幅降低存储需求与计算开销的同时,依然能够保持极高的检索精度。
如果您发现在自己的数据集上构建索引速度较慢,可以利用外部构建(External Build)功能来加速这一过程。更多详情请参阅我们此前的博文:VectorChord 外部质心构建的优势与操作步骤。
索引构建完成后,您可以使用以下 SQL 查询来检索相似文档:
使用 VectorChord-BM25 进行关键词检索
对于关键词检索,我们需要使用**分词器(Tokenizer)**将文本转换为 BM25 向量——它类似于一种记录词汇 ID 及其出现频次的稀疏向量。
下面详细解释一下这一操作:tokenize 函数用于按照指定的分词器对文本进行分词。在本例中,我们使用了 Unicode 分词器。tokenize 函数的输出是一个 BM25 向量,即存储文本中每个词的词汇表 ID 及其出现次数的稀疏向量。例如,1035:7 表示词汇表 ID 为 1035 的词在该文本中出现了 7 次。
创建索引后,您就可以计算查询与各个文档向量之间的 BM25 得分了。请注意,这里的 BM25 得分是负数,意味着数值越小(绝对值越大),文档的相关性越高。我们之所以特意将其设计为负数,是为了让您能够直接使用默认的升序 ORDER BY 优先检索出最相关的文档。
重排序与融合(Rerank/Fuse)
当您分别获取到语义检索和关键词检索的结果后,可以通过**融合(Fuse)或重排序(Rerank)**流程将两部分结果合并。
- 结果融合(倒数排序融合,Reciprocal Rank Fusion (RRF))
RRF 的优势在于它不依赖于具体的得分量纲,而是基于排名位置进行融合,因此非常适合将采用不同评分标准的排序系统结合起来。
其中:
-
d表示文档。 -
n表示参与融合的排序系统数量。 -
rank表示文档在对应排序系统中的排名。 -
k为调节参数,通常取值为 60(经验值),用于控制排名位置对最终得分的影响程度。
- 交叉编码器(Cross-Encoder)模型重排序
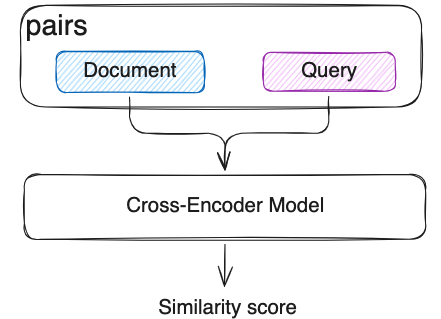
在语义检索阶段,我们已经使用双编码器(Bi-Encoder)分别将文档和查询编码为向量。但这种独立编码的方式导致查询与文档之间缺乏深层交互。交叉编码器(Cross-Encoder)模型则会将查询和文档作为一个整体同时输入模型,使模型能够同时看到两者的内容,并通过 Transformer 层捕捉它们之间细粒度的语义关联。与 RRF 相比,Cross-Encoder 模型能够更细腻地捕捉查询与文档之间的语义关系,准确率更高,但计算速度相对较慢。
评估结果
我们在多个 BEIR 数据集上测试了上述方法的 NDCG@10 指标,Top-10 评估结果如下:
| 数据集 | 语义检索 | BM25 | Cross-Encoder 重排序 | RRF |
|---|---|---|---|---|
| FiQA-2018 | 0.40343 | 0.25301 | 0.42706 | 0.37632 |
| Quora | 0.88433 | 0.78687 | 0.89069 | 0.87014 |
| SCIDOCS | 0.16055 | 0.15584 | 0.17942 | 0.17299 |
| SciFact | 0.57631 | 0.68495 | 0.74635 | 0.67855 |
从上表可以得出以下几点结论:
-
与单一的 BM25 或语义检索相比,使用 Cross-Encoder 模型进行重排序能够在不同数据集上显著提升检索性能。
-
在部分数据集上,RRF 可能会导致性能有所下降。因此,在决定是否采用 RRF 之前,请务必针对您的实际数据进行验证测试。如果验证有效,选择 RRF 将是一个非常经济高效的方案——因为它的计算速度比 Cross-Encoder 模型重排序快得多,且几乎不消耗额外计算资源。
所有相关的基准测试代码均可在此处获取。如果您有任何疑问,欢迎随时在 Discord 上与我们交流,或发送邮件至 [email protected]。
未来规划
上述测试结果充分展示了混合检索方法的巨大潜力。未来,我们将重点围绕以下几个方向进一步推进 RAG 技术:
- 改进重排序方法:探索其他基于模型的重排序方案(例如 ColBERT 或 ColPali),以进一步提升重排序性能。
- 融合图检索(Graph Search):研究使用 Apache AGE 扩展进行图检索,并将其与混合检索方法相结合,从而更进一步提升检索效果。
参考资料
- https://github.com/pgsty/vchord
- https://github.com/pgsty/vchord_bm25
- https://techcommunity.microsoft.com/blog/adforpostgresql/introducing-the-graphrag-solution-for-azure-database-for-postgresql/4299871
- https://www.pinecone.io/learn/hybrid-search-intro/
- https://www.pinecone.io/learn/series/rag/rerankers/
- https://blog.vespa.ai/improving-zero-shot-ranking-with-vespa-part-two/